 夜雨聆风
尤其是做:
时,你会发现:
很多时候,不是模型不够强,而是文档数据太差。
最近看到一个非常强的国产开源项目:
MinerU
GitHub:https://github.com/opendatalab/MinerU
在线使用:
https://mineru.net/OpenSourceTools/Extractor
它不是传统 OCR 工具,而是:
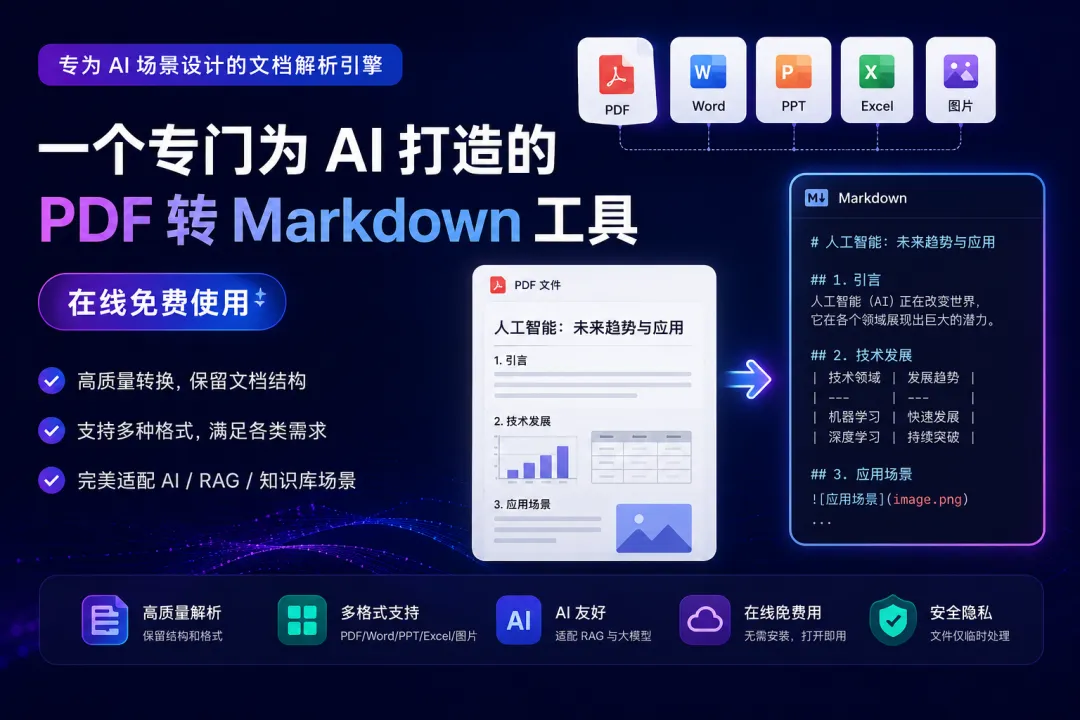
专门为 LLM 场景设计的文档解析引擎
为什么 PDF 解析一直很难?
传统方案最大的问题是:
“只能提取文本,无法理解文档结构”
于是就会出现:
最后导致:
很多 AI 项目最后效果不好,其实问题根源在数据层。
MinerU 强在哪里?
MinerU 最核心的能力是:
不只是提取文本,而是重建文档结构
它会真正理解:
并输出:
对于 RAG 来说,这一点非常重要。
因为:
LLM 更需要“结构化文档”,而不是纯文本。
我觉得最实用的几个能力
1. PDF 转 Markdown 效果非常好
很多工具导出的 Markdown:
MinerU 的输出已经很接近:
“可直接喂给 LLM”
这能省掉大量清洗工作。
2. 对复杂 PDF 支持很好
包括:
都能较好处理。
这点对论文、金融、企业文档场景非常重要。
3. 非常适合 RAG Pipeline
很多人现在已经开始把它作为:
直接接到 AI Pipeline 里。
生态也很完整
目前已经支持:
还能和:
等生态配合使用。
甚至支持纯 CPU 运行。
一个很明显的趋势
以前大家做 AI:
重点在模型。
现在越来越多团队开始发现:
“高质量数据入口” 才是真正的核心竞争力。
而 MinerU 正在解决的,就是:
如何让 AI 真正读懂复杂文档。
如果你正在做:
这个项目非常值得看看。
项目地址:
https://github.com/opendatalab/MinerU