 夜雨聆风
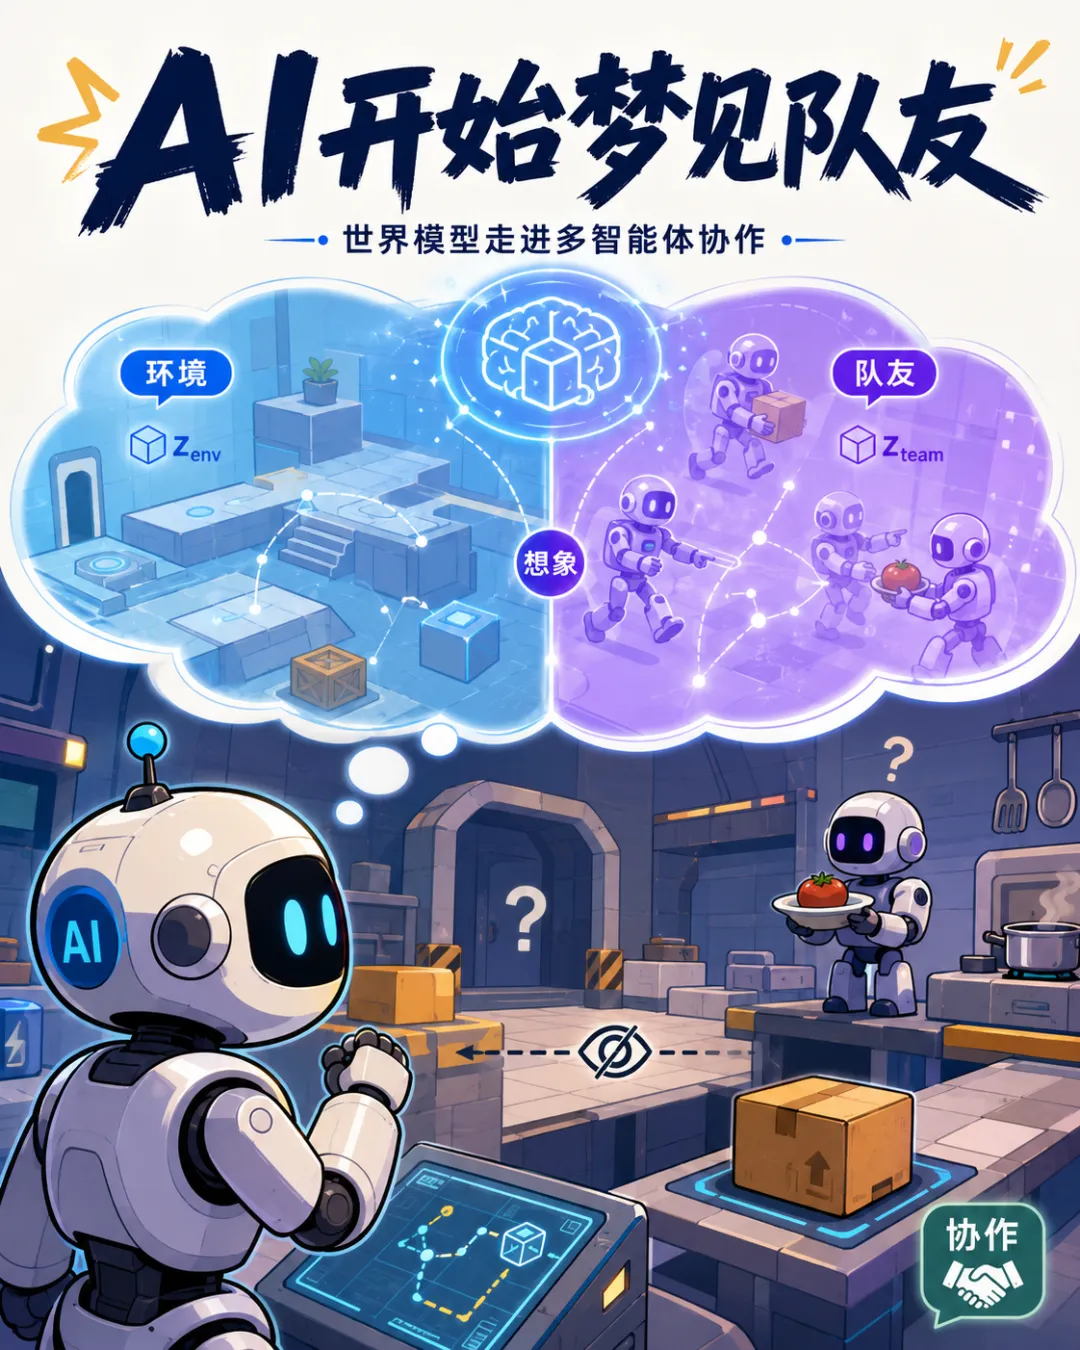
你是一个AI智能体。
你被放进一个陌生环境,身边还有一个从未见过的队友。
你不知道它会怎么行动,不知道它的策略,也看不到它的“内心”。
但你做了一件很像人类的事:
你开始想象它。
你在脑子里模拟它可能要去哪里、想做什么、会不会配合你、会不会突然改变计划。
换句话说,AI开始“梦见”队友了。
这正是论文 《Dreaming Of Others: Latent Teammate Modeling In World Models For Multi-Agent Reinforcement Learning》 想表达的核心思想。
这篇工作被 2026 World Modeling Workshop 接收,并于 5 月 29 日挂上 arXiv。虽然它目前更像是一篇概念性论文,但提出的问题非常有意思:
世界模型不应该只模拟物理世界,也应该模拟“别人怎么想”。
01
过去的AI,只会梦见世界
先说什么是世界模型。
在强化学习里,世界模型的思路很直观:
让AI先学会一个“脑内世界”。
它不用每次都真的去环境里试错,而是可以在自己的模型里提前想象:
如果我这么做,会发生什么?
如果我走这条路,会不会失败?
如果我改变策略,结果会不会更好?
DeepMind 的 Dreamer 系列就是代表。它让智能体在“梦境”中进行大量想象 rollout,然后用这些想象出来的经验训练策略。
这有点像人类下棋:
高手不会真的把棋子一步步乱走,而是在脑子里预演很多种可能。
AI也是如此。
只不过,过去的世界模型主要梦见的是:
环境怎么变化。
比如门会不会打开,箱子会不会移动,奖励会不会出现。
但问题来了。
真实协作任务里,影响结果的不只有环境。
还有队友。
02
一旦有队友,世界就“不稳定”了
单智能体强化学习里,环境通常被假设是相对稳定的。
你做一个动作,环境给一个反馈。
但多智能体场景完全不同。
因为你的队友也在学习,也在决策,也在变化。
今天它喜欢往左走,明天它可能学会了往右走。
这一刻它想搬箱子,下一刻它可能突然去拿钥匙。
对你来说,队友不是背景。
队友本身就是环境的一部分。
更麻烦的是,你通常看不到队友的策略,也不知道它真正的意图。
你只能通过它的行为猜测:
它是不是要配合我?
它是不是误解了任务?
它是不是有自己的计划?
这就是多智能体协作最难的地方:
你必须和一个你看不懂的队友合作。
03
传统方法:要么开上帝视角,要么共享大脑
多智能体强化学习里,常见路线大致有两类。
第一类是 CTDE,也就是“中心化训练、去中心化执行”。
训练时给智能体开上帝视角,让它们看到全局信息;真正执行时,再让每个智能体只用自己的局部观测行动。
MAPPO、QMIX 这类方法都属于这一大类。
第二类是把世界模型扩展到多智能体系统里。
比如 MA-Dreamer、CoDreamer 等方法,会让多个智能体共享某些潜在状态,或者在统一的想象空间里协同训练。
这些方法当然很强。
但它们往往隐含一个前提:
训练时可以拿到比较丰富的中心化信息,或者智能体之间可以共享某些内部表示。
可现实世界未必如此。
人类协作里,我们很少真正知道别人脑子里在想什么。
我们更多时候是在观察、猜测、修正,再继续协作。
这篇论文的切入点就在这里:
不靠上帝视角,不靠通信信道,而是让每个智能体自己建模队友。
04
核心思想:把队友“塞进”世界模型
这篇论文最有意思的地方,是它把世界模型拆成了两部分。
过去,世界模型通常只压缩一个整体潜在状态。
现在,作者提出可以把潜在状态分解为:
z_t = [z_t^env, z_t^team]其中:
z_t^env 表示环境状态。
它负责建模物理世界,比如位置、物体、地形、任务进展。
z_t^team 表示队友状态。
它负责建模队友的行为模式、意图倾向和可能动作。
这一步很关键。
因为它意味着,AI脑中的“世界”不再只是地图、障碍物和奖励。
它还包括另一个智能体。
也就是说:
世界模型开始拥有社会维度。
05
AI如何“读懂”队友?
当然,AI并不是真的读心。
它做的是行为推断。
论文中引入了一个类似“心智理论”的模块,也就是 Theory-of-Mind 头。
这个模块会根据局部观测到的队友行为,推断队友的潜在嵌入。
比如:
它经常先去拿食材,说明它可能偏向准备型角色;
它总是靠近目标区域,说明它可能在主动完成任务;
它突然改变路线,可能意味着它发现了新的机会或障碍。
这些信息会被压缩进 z_t^team。
然后,智能体在自己的“梦境”中训练策略时,不再只想象环境怎么变。
它还会想象:
这个队友可能怎么行动?
我该如何配合它?
如果它换一种风格,我还能不能协作?
这就是标题里的“梦见队友”。
不是文学修辞,而是技术路径。
06
真正厉害的地方:遇到陌生队友也能协作
这个方向最值得关注的能力,是零样本协作。
什么叫零样本协作?
就是AI遇到一个从没见过的队友时,不需要重新训练,也能马上配合。
这在人机协作、多机器人协作、自动驾驶、游戏AI、智能制造里都非常重要。
因为现实世界中的队友不可能永远固定。
你今天合作的是这个人,明天可能换成另一个人。
每个人的习惯、节奏、偏好都不同。
一个真正有用的AI,不应该只会和“训练时见过的队友”合作。
它应该能观察几步,就大致判断:
这个队友是什么风格?
它想怎么完成任务?
我应该主动补位,还是让它主导?
这篇论文提出的队友潜在建模,正是朝这个方向迈了一步。
07
为什么这件事重要?
我认为这篇论文值得关注,不是因为它已经给出了惊艳实验结果。
事实上,它目前更像是一个概念框架,实验验证还没有完全展开。
它真正重要的地方在于,它把一个长期被忽略的问题摆到了台面上:
AI要想协作,就不能只理解世界,还要理解队友。
过去的世界模型,更像是“物理世界模拟器”。
它关心的是物体怎么动、状态怎么变、奖励怎么来。
但未来的世界模型,可能还要变成“社会行为模拟器”。
它不仅要回答:
如果我这样做,世界会怎样?
还要回答:
如果我这样做,队友会怎么理解?
如果队友这样行动,它可能想表达什么?
我怎样才能和它形成默契?
这才是真正的协作智能。
08
从多智能体,到人机协作
这个方向还有一个更大的想象空间:
人机协作。
人类比AI队友更复杂。
人类会犹豫,会犯错,会临时改变计划,也会有自己的偏好和习惯。
如果AI只能按照固定策略行动,它就很难成为真正可靠的助手。
但如果AI能通过世界模型模拟人的潜在行为模式,它就可能变得更“懂人”。
比如在协作厨房里,它能判断人类下一步可能要拿盘子;
在智能驾驶中,它能推断其他驾驶员的意图;
在机器人协作中,它能提前补位,而不是等命令;
在复杂任务规划里,它能根据人的风格调整自己的动作。
这听起来像“读心”。
但更准确地说,是基于观察的行为建模。
AI不是知道你在想什么。
而是通过你的行为,构建一个关于你的动态模型。
09
当然,挑战也不少
这个方向很有潜力,但问题也很明显。
第一,队友数量增加怎么办?
一个队友还好,如果有十个队友,z_t^team 怎么设计?是每个队友一个表示,还是整体压缩成团队状态?
第二,想象会不会越想越错?
如果队友建模本身有误差,那么在世界模型里反复 rollout,误差可能会被不断放大。
第三,如何证明它真的理解了队友?
模型预测动作准确,不一定代表它理解了意图。
它可能只是学到了表面相关性。
第四,实验还需要补上。
这篇论文目前最吸引人的地方是思想,而不是结果。它提出了评估方向,比如 Multi-Agent Particle Environments、Overcooked-AI、Melting Pot 等,但真正的性能提升还需要后续实验验证。
10
写在最后:AI协作的下一步,是“想象他人”
这篇论文最后有一句话很漂亮:
智能体不仅要梦见它所处的世界,也要梦见共享这个世界的其他心智。
这句话概括了整篇工作的野心。
世界模型过去解决的是“我如何理解环境”。
而多智能体世界模型要解决的是:
我如何理解和我一起行动的别人。
这也许是AI从“单体智能”走向“协作智能”的关键一步。
当AI不仅能预测物理世界,还能模拟队友行为、理解协作意图、适应陌生伙伴时,它就不再只是一个会执行任务的工具。
它开始像一个真正的合作者。
所以,“AI梦见队友”听起来像科幻。
但它背后的问题非常现实:
未来的AI,究竟是一个孤独的决策者,还是一个能理解他人的队友?
这篇论文给出的答案是:
先让它学会,在脑子里想象别人。
参考论文
标题:Dreaming Of Others: Latent Teammate Modeling In World Models For Multi-Agent Reinforcement Learning作者:Tomas Leroy-Stone会议:2026 World Modeling Workshop PosterarXiv:2605.31361