 夜雨聆风
这不是什么科幻大片,这是 RAG 检索增强生成
一、从一次翻车说起
前天晚上,我在写一份行业报告,需要查一个冷门的技术参数。
打开大模型对话框,我输入:
"XX 协议在 2024 年的最新规范是什么?"
AI 非常自信地给我回了一大段,有模有样,还带引用。
我差点直接复制粘贴了。
但凭着一丝职业警觉,我去查了原文——结果发现,它说的那个"新规范",根本不存在。
编的。全编的。
那一刻我的感受,就像你问路,一个路人非常热情地给你指了一条路,你走到底发现是个死胡同,回头一想——他压根就没去过那个地方。
这就是大语言模型众所周知的死穴:幻觉。
你问它什么,它都想回答。但它不知道的就是不知道,它会编。说得越自信,越容易翻车。
二、大模型的「死记硬背」病
要理解 RAG 在解决什么问题,先要理解大模型的本质。
别看现在的 AI 聊天、写诗、写代码什么都会,本质上它就是一个超级背诵机器。它的知识来自于训练时"读"过的海量数据,学完之后,所有的信息都压缩到模型参数里。
就像你考试前通宵背书,第二天上考场——如果考的全是背过的,你稳赢。但要是考一道书里没有的题,你就只能靠编了。
大模型也一样:
✅ 问它「李白是哪朝人」→ 稳得很 ✅ 问它「Python 写个冒泡排序」→ 秒出 ❌ 问它「我们公司昨天刚发布的新品叫什么」→ 开始编 ❌ 问它「2024 年 Q3 的这份财报利润率是多少」→ 开始胡扯
为什么?
因为它的知识在训练那一刻就冻结了。你训练截止日期之后发生的事情,它不知道。而且它没有"搜索引擎",没有"查资料"的能力。
打个比方,你请了一个特别博学的助手,但他被关在一个没有窗户的房间里,所有知识都是他两年前记住的。现在你问他外面天气怎么样,他只能凭两年前的记忆瞎猜。
尴尬不尴尬?
三、RAG 是什么?一句话讲清楚
RAG(Retrieval-Augmented Generation),中文叫检索增强生成。
名字听着高级,其实原理特别简单,就三个字——
先查,再答。
你想想一个真人助手是怎么工作的:
你问一个问题 他先去查资料、翻书、搜数据库 找到相关的内容 阅读、理解、整合 然后给你一个靠谱的回答
RAG 干的事,一模一样。
四、RAG 到底怎么工作的?用故事讲
我找一个最简单的场景来解释。
假设你是这家公司的新员工,老板让你去写一份关于「公司 2024 年产品线」的报告。
没有 RAG 的 AI(也就是普通的 LLM):
就像一个第一天入职就被关进小黑屋的新人。他不知道公司有哪些产品,不知道去年的财报,不知道刚发布的新品。但他又不敢说不知道——于是他开始一套组合拳:
"根据行业趋势,贵公司可能推出了 AI 驱动的 XXX 平台……"
每一句听起来都对,但每一句都不对。
有 RAG 的 AI:
像一个入职第一天就被授权查阅所有公司文档的新人。你问他之前,他先做这几步:
Step 1:理解你的问题 "嗯,老板想知道 2024 年的产品线。"
Step 2:去翻资料(检索) 他去公司的知识库、产品文档、飞书文档、企业 wiki 里搜了一圈。找到 10 份相关文档——产品规划书、新品发布公告、QA 规范、架构设计文档……
Step 3:挑出最有用的(相关性排序) 把最相关的几段摘出来,排好顺序。
Step 4:带着材料回来回答(生成) 他是看着材料回答你的,每句话都有据可查。
这就是 RAG 的全部哲学:不给 AI 增加知识,而是给它一个查资料的通道。
五、RAG 解决了哪三个核心问题
1. 消除幻觉
有资料做依托,AI 不敢瞎编了。你甚至可以在答案旁边加个「参考来源」,像论文一样,每条信息都有出处。
2. 实时更新
你不需要重新训练模型。你只需要更新知识库里的文档。今天刚发布的公告、昨天刚写的周报、5 分钟前改的规范——都能被检索到。
这让 AI 的知识保鲜期从几个月缩短到几分钟。
3. 私有知识不出门
公司内部的知识库、机密文档,不需要上传到大模型的训练集。文档依然存在你的数据库里,AI 只在回答时去"翻"。
安全合规,老板放心。
六、让我给你画个流程图
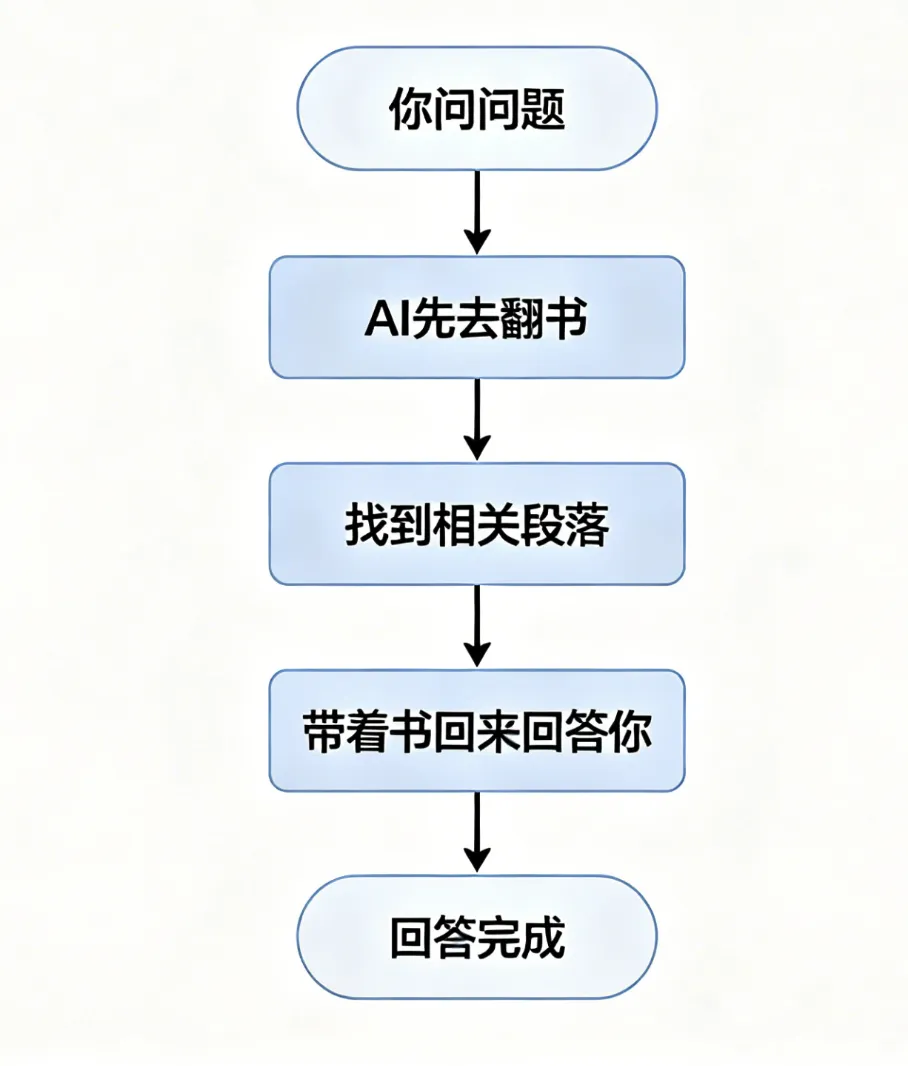
说人话版本:
你问问题 → AI 先去翻书 → 找到相关段落 → 带着书回来回答你
七、代码时间:30 行实现一个简易 RAG
理论听完了,我们上手吧。
下面是一个用 LangChain(版本 1.3.4)实现的 RAG,使用最新的 LCEL(LangChain Expression Language)模式,代码更简洁、可读性更强。
import osfrom langchain_openai import OpenAIEmbeddings, ChatOpenAIfrom langchain_core.prompts import ChatPromptTemplatefrom langchain_core.documents import Documentfrom langchain_core.runnables import RunnablePassthroughfrom langchain_chroma import Chroma# ============ 第一步:准备知识库 ============raw_docs = ["2024年Q1公司发布了新一代AI芯片,算力提升300%","2024年Q2新产品线包含3个型号:Pro、Lite、Mini","2024年Q3财报显示营收同比增长45%,主要来自海外市场","2025年规划:进入欧洲市场,预计Q2在德国设立分公司","公司核心产品是AI驱动的智能客服平台,服务超过1000家企业",]documents = [Document(page_content=t) for t in raw_docs]# ============ 第二步:向量化 + 建索引(Chroma)============embeddings = OpenAIEmbeddings(model="text-embedding-3-small")vector_store = Chroma.from_documents(documents, embeddings)retriever = vector_store.as_retriever(search_kwargs={"k": 2})# ============ 第三步:构建 RAG 链(LCEL 模式)============prompt = ChatPromptTemplate.from_template("""基于以下参考资料回答问题。如果参考资料中没有相关信息,请如实说不知道。参考资料:{context}问题:{input}回答:""")defformat_docs(docs):return"\n".join(f"- {d.page_content}"for d in docs)# 一条链:检索 → 格式化 → 拼 prompt → 调用大模型chain = ( {"context": retriever | format_docs, "input": RunnablePassthrough()} | prompt | ChatOpenAI(model="gpt-4o-mini"))# ============ 测试一下 ============query = "2024年公司发布了什么产品?"result = chain.invoke(query)print(f"问:{query}")print(f"答:{result.content}")print()query2 = "公司2025年的规划是什么?"result2 = chain.invoke(query2)print(f"问:{query2}")print(f"答:{result2.content}")这段代码做了三件事:
文档转向量: Document→OpenAIEmbeddings向量化 →Chroma构建本地向量数据库检索器: vector_store.as_retriever()一步搞定LCEL 管道链:用 |操作符把"检索 → 格式化 → prompt → 大模型"串成一条链,清晰直观
环境要求
Python 3.12+ langchain 1.3.4 / langchain-openai 0.3.0 / langchain-chroma 0.2.0 / chromadb 0.5.23
使用 uv 管理依赖(Chrome 会自动下载需要的 embedding 模型文件,首次运行稍慢):
# 安装 uv(如果没有)curl -LsSf https://astral.sh/uv/install.sh | sh# 创建虚拟环境并安装依赖uv venvuv pip install "langchain==1.3.4""langchain-openai==0.3.0""langchain-chroma==0.2.0" python-dotenv或者一行直接跑:
OPENAI_API_KEY="sk-xxx" uv run --with 'langchain==1.3.4,langchain-openai==0.3.0,langchain-chroma==0.2.0' python rag_demo.pyChroma 是开源向量数据库,相比 FAISS 支持更多高级功能(持久化、元数据过滤、多模态等),适合生产环境使用。
uv 是 Rust 写的 Python 包管理器,安装速度比 pip 快 10-100 倍,且自带虚拟环境管理。
跑一下试试,你会发现 AI 不再编造答案了。如果问的问题知识库里没有,它会老老实实说"不知道"。
就这一点,已经比 90% 的 AI 应用强了。
八、RAG 能干什么?给你几个真实场景
九、写在最后
两年前,我第一次用 ChatGPT 时,那种惊艳感就像第一次用智能手机——原来 AI 真的能"聊天"了。
但用着用着就发现不对劲:你不知道它哪句是真、哪句是编的。
RAG 给 AI 装了一双"眼睛"和一本"字典"。它不再是凭着死记硬背在那里胡诌,而是真的会先去查资料。
就像我们小时候写作文,老师总说:
"别瞎编,去查查资料。"
RAG 就是那个"去查查资料"的能力。
如果你正在搭建自己的 AI 应用,或者想在内部落地一个知识问答系统,RAG 就是你绕不过去的第一步。它不复杂、成本低、效果好——任何团队都能在一天内跑起来。
最后送你一句话:
AI 的能力不是靠记住所有的答案,而是知道去哪里找到答案。
这就是 RAG。
💡 想交流 AI 落地的实际经验?欢迎留言区聊聊你在用 AI 时遇到过的"幻觉"翻车经历。