 夜雨聆风
摘要:为什么写 JPA 的人总是说"先理解 Entity 状态再写代码"?为什么一个
@Transactional就能决定数据是否落库?方法名为什么能变成 SQL? JPA 是什么、Spring Data 怎么简化数据访问,再深入到 Repository 动态代理、PartTree 查询解析、一级缓存和脏检查等源码级细节,这篇文章尝试把JPA讲清楚。标签:JPA、Hibernate、Spring Data、Repository、Entity、PersistenceContext
一、从一个实际问题说起
小 A 在开发一个后台管理系统,发现每个模块都要写重复的数据访问代码:
// 用户模块public interface UserDao { User findById(int id); List<User> findAll(); void save(User user); void delete(int id); List<User> findByRole(String role); List<User> findByNameLike(String name);}// 订单模块 — 又是同样的代码...public interface OrderDao { Order findById(int id); List<Order> findAll(); void save(Order order); void delete(int id); List<Order> findByStatus(String status);}小 A 发现几个问题:
1. 每个模块的 CRUD 代码结构相同:无非是增删改查,只是 Entity 类型不同 2. 查询方法命名模式重复:findByXxx 到处写,SQL 样板代码多 3. 手写 SQL 容易出错:字段名拼写错误、类型转换问题、SQL 注入风险
如果有一套机制,让开发者只声明接口方法,实现由框架自动生成,问题就迎刃而解了。JPA + Spring Data 正是这样的方案。
二、JPA 是什么?
2.1 概念定义
JPA(Java Persistence API):Java 持久化规范,定义了对象-关系映射(ORM)的标准接口。它不是实现,而是一套规范(API),就像 JDBC 是数据库访问规范一样。
Hibernate:JPA 最主流的开源实现,负责将 Java 对象映射为数据库表记录、生成 SQL、管理缓存等。
Spring Data JPA:Spring 对 JPA 的进一步封装,提供 Repository 抽象,开发者只需要声明接口,Spring 自动生成实现类,实现零代码 CRUD。
类比:
如果把数据库访问比作快递系统:
• Entity = 打包好的包裹(Java 对象 = 快递单) • Hibernate = 快递公司(负责把包裹准确投递到对应地址/表) • JPA = 快递行业标准(定义了包裹怎么打、单号怎么编) • Repository = 快递员(你说一声"送到 5 号",他就帮你搞定,不用自己跑去送)
2.2 JPA vs MyBatis
选型建议:
• CRUD 密集型业务(后台管理、数据录入)→ JPA 效率更高 • 复杂查询密集型业务(报表、OLAP)→ MyBatis 更灵活 • 混合场景 → 两者并用(常见于中大型项目)
2.3 架构分层
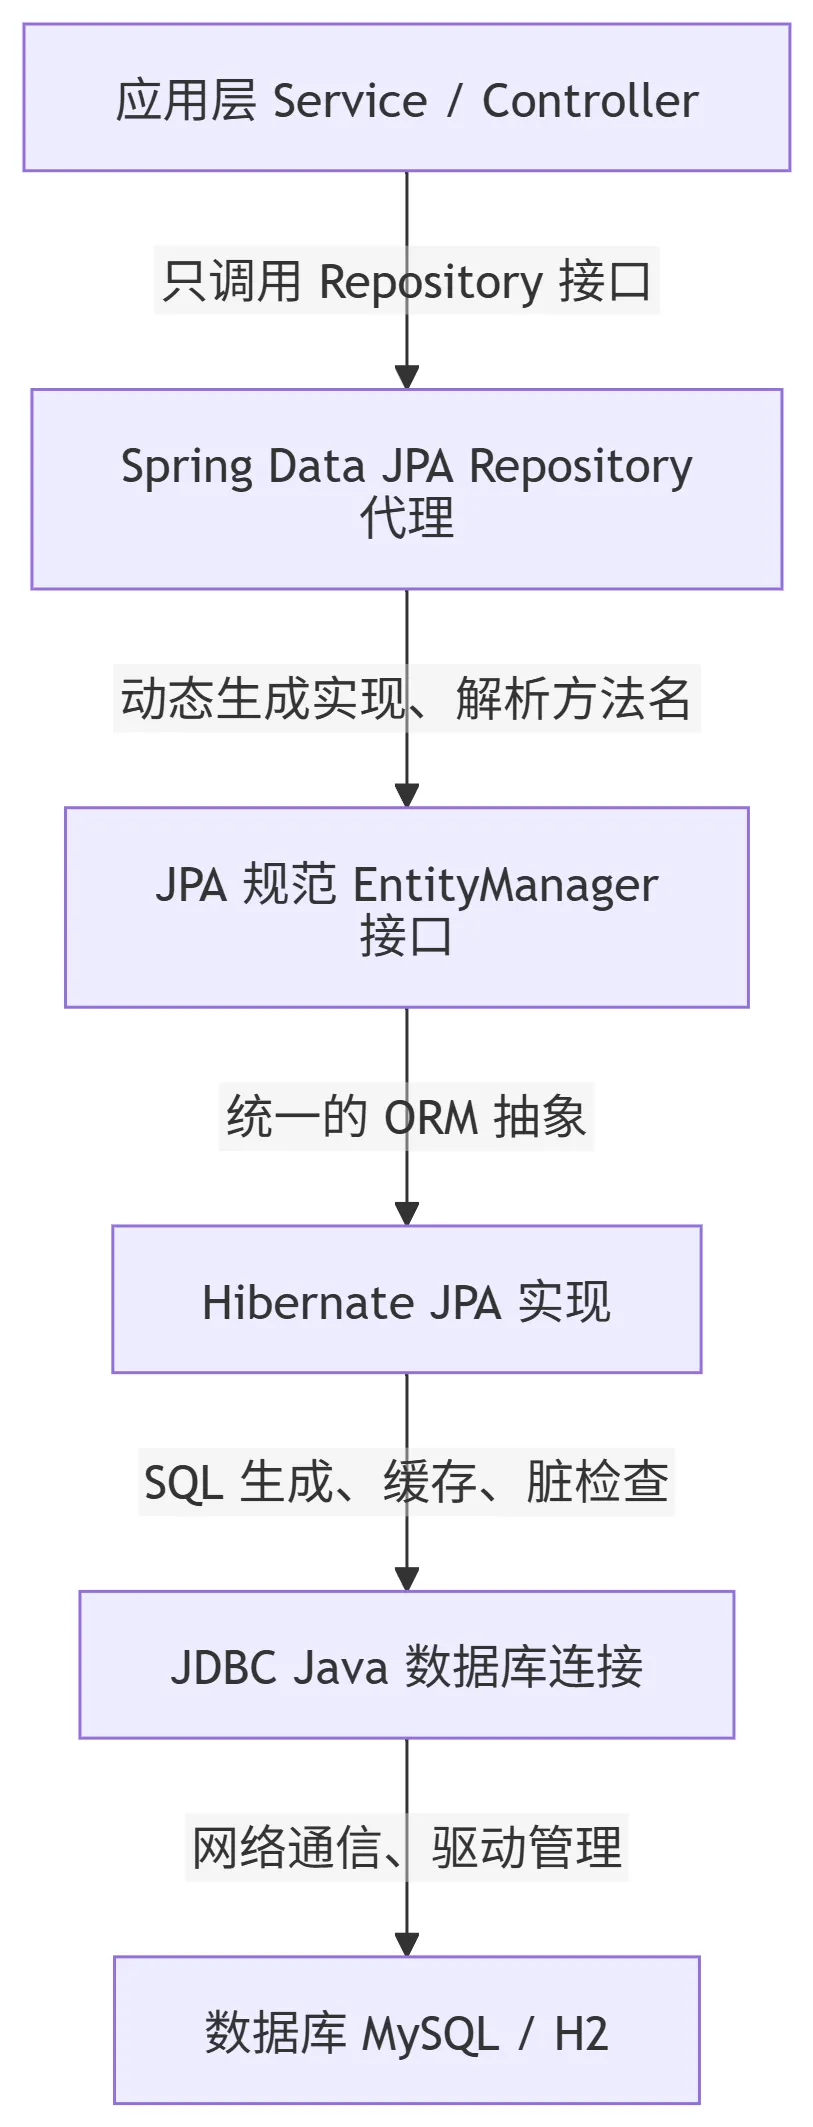
三、Entity 映射
3.1 基本映射
Entity 是 JPA 的基石,每一个 Entity 类对应数据库中的一张表。
@Entity // 标记为 JPA 实体@Table(name = "product") // 指定表名(省略时默认类名转蛇形)public class ProductEntity { @Id // 主键标记 @GeneratedValue(strategy = GenerationType.IDENTITY) // 自增策略 private Integer id; private String name; // 对应 name 列(字段名 = 列名时可省略 @Column) private Double price; // 对应 price 列 private String category; // 对应 category 列 public ProductEntity() {} // 必须有无参构造 public ProductEntity(String name, Double price, String category) { this.name = name; this.price = price; this.category = category; } // getters & setters ...}常用注解速查表:
@Entity | ||
@Table | name = "xxx" | |
@Id | ||
@GeneratedValue | IDENTITYSEQUENCE / AUTO | |
@Column | nullablelength, name | |
@Transient | ||
@Temporal | DATETIME / TIMESTAMP |
为什么必须有无参构造函数? Hibernate 通过反射 clazz.newInstance() 创建实体对象,无参构造是硬性要求。
3.2 关系映射
关系映射是 JPA 最容易踩坑的地方。以小 A 的场景为例:一个分类下有多个产品,一个产品属于一个分类。
@Entity@Table(name = "category")public class CategoryEntity { @Id @GeneratedValue(strategy = GenerationType.IDENTITY) private Integer id; @Column(nullable = false) private String name; @OneToMany(mappedBy = "categoryEntity") // 反向端,由对方维护关系 private List<ProductEntity> products = new ArrayList<>(); // getters & setters ...}@Entity@Table(name = "product")public class ProductEntity { @Id @GeneratedValue(strategy = GenerationType.IDENTITY) private Integer id; private String name; private Double price; @ManyToOne // 多对一:多个产品属于一个分类 @JoinColumn(name = "category_id") // 外键列名 private CategoryEntity categoryEntity; // getters & setters ...}关系映射方向说明:
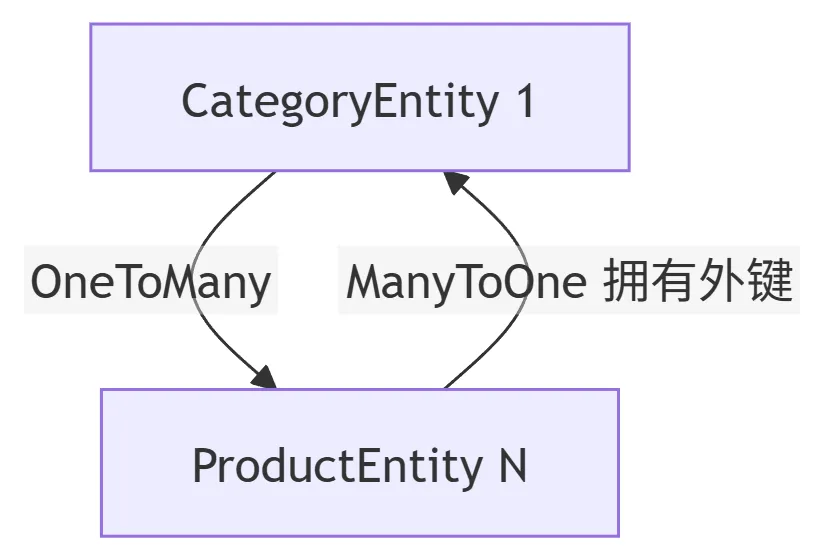
@ManyToOne | ||
@OneToMany | mappedBy)属性名,不是列 | |
@OneToOne | @JoinColumn 的一端 | |
@ManyToMany |
经验法则:绝大多数场景下,用
@ManyToOne维护关系即可,@OneToMany设为mappedBy只读。双向关系如果两端都维护,容易导致数据不一致。
Fetch 策略:
@ManyToOne(fetch = FetchType.EAGER) | ||
@OneToMany(fetch = FetchType.LAZY) |
3.3 主键生成策略
// 策略一:数据库自增(MySQL 推荐)@GeneratedValue(strategy = GenerationType.IDENTITY)// 策略二:序列(Oracle / PostgreSQL 推荐)@GeneratedValue(strategy = GenerationType.SEQUENCE, generator = "seq")@SequenceGenerator(name = "seq", sequenceName = "my_seq", initialValue = 1)// 策略三:UUID(分布式场景)@GeneratedValue(strategy = GenerationType.UUID)// 策略四:Hibernate 优化策略(推荐用于新表)@GeneratedValue(strategy = GenerationType.TABLE, generator = "tbl")@TableGenerator(name = "tbl", table = "id_generator", pkColumnName = "seq_name", valueColumnName = "seq_value")四、Repository 接口
4.1 继承 JpaRepository
public interface ProductJpaRepository extends JpaRepository<ProductEntity, Integer> { // 不需要写实现!Spring 动态生成}调用方式:
@Autowiredprivate ProductJpaRepository productJpaRepository;// 基本 CRUDproductJpaRepository.save(product);productJpaRepository.findById(1);productJpaRepository.findAll();productJpaRepository.deleteById(1);productJpaRepository.count();productJpaRepository.existsById(1);Spring 提供的 Repository 接口层次结构:
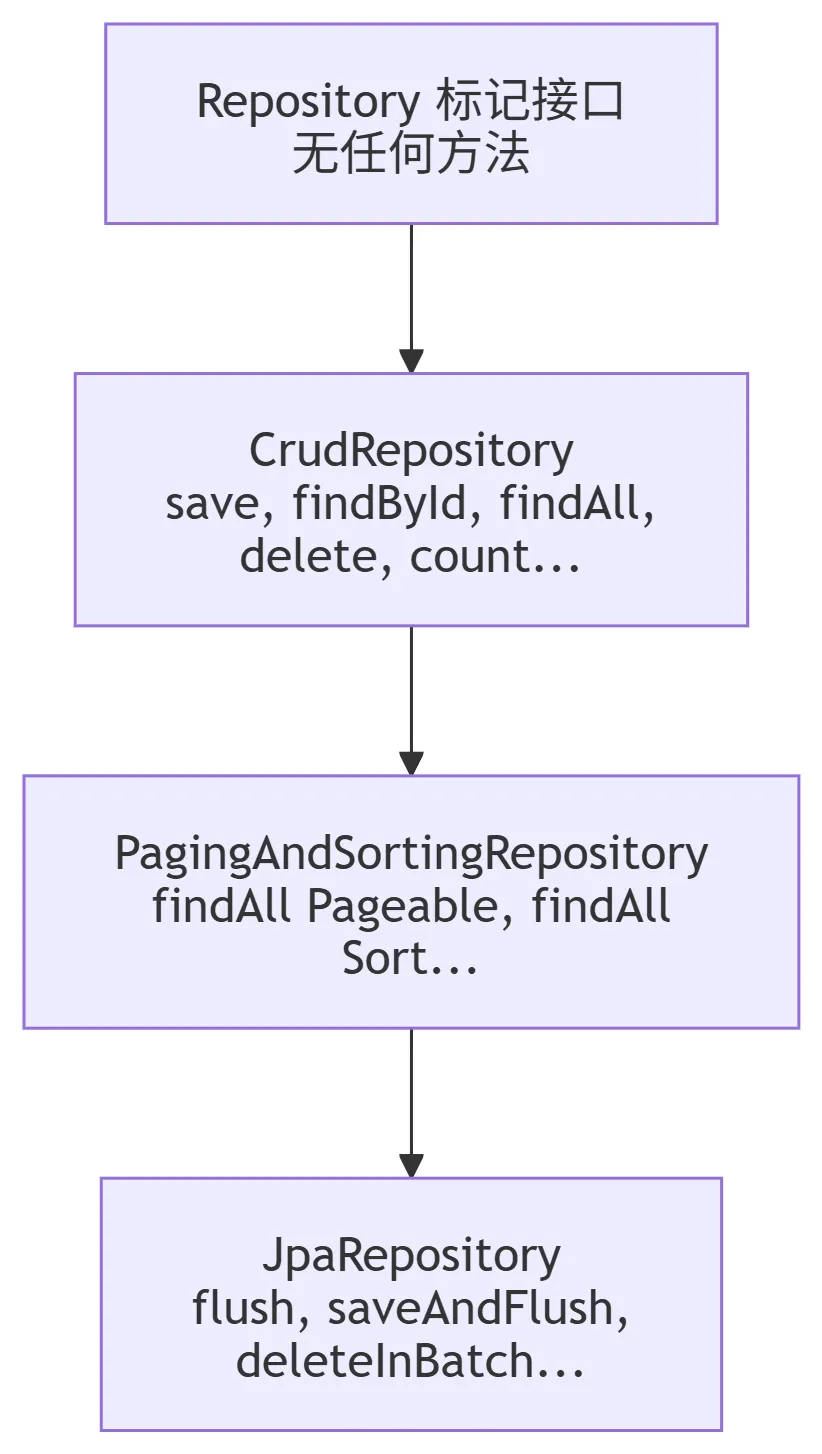
4.2 方法名推导查询
Spring Data JPA 根据方法名自动生成 SQL。这是它最"神奇"的功能之一。
public interface ProductJpaRepository extends JpaRepository<ProductEntity, Integer> { // 按分类查询 → SELECT * FROM product WHERE category = ? List<ProductEntity> findByCategory(String category); // 价格范围查询 → SELECT * FROM product WHERE price BETWEEN ? AND ? List<ProductEntity> findByPriceBetween(Double min, Double max); // 名称模糊查询 → SELECT * FROM product WHERE name LIKE ? List<ProductEntity> findByNameLike(String keyword); // 组合条件 → SELECT * FROM product WHERE category = ? AND price < ? List<ProductEntity> findByCategoryAndPriceLessThan(String category, Double price);}测试验证:
@Testvoid findByCategory() { // 方法名推导:自动生成 SELECT ... WHERE category = ? List<ProductEntity> electronics = productJpaRepository.findByCategory("Electronics"); assertEquals(2, electronics.size()); assertTrue(electronics.stream().allMatch(p -> "Electronics".equals(p.getCategory())));}@Testvoid findByPriceBetween() { List<ProductEntity> products = productJpaRepository.findByPriceBetween(10.0, 6000.0); assertEquals(3, products.size());}常用方法名关键词:
findBy | findByName | WHERE name = ? |
And | findByAAndB | WHERE a = ? AND b = ? |
Or | findByAOrB | WHERE a = ? OR b = ? |
Between | findByPriceBetween | WHERE price BETWEEN ? AND ? |
LessThan | findByPriceLessThan | WHERE price < ? |
GreaterThan | findByPriceGreaterThan | WHERE price > ? |
Like | findByNameLike | WHERE name LIKE ? |
OrderBy | findByOrderByPriceDesc | ORDER BY price DESC |
Distinct | findDistinctByCategory | SELECT DISTINCT ... WHERE category = ? |
FirstTop | findTop10ByCategory | WHERE category = ? LIMIT 10 |
Not | findByNameNot | WHERE name <> ? |
IsNullIsNotNull | findByCategoryIsNull | WHERE category IS NULL |
Containing | findByNameContaining | WHERE name LIKE ?%? |
4.3 @Query 自定义查询
当方法名推导不够用时,可以用 @Query 手动编写查询语句。
JPQL(Java Persistence Query Language):
// JPQL 面向实体操作,不是表名@Query("SELECT p FROM ProductEntity p WHERE p.name LIKE %:keyword%")List<ProductEntity> searchByName(@Param("keyword") String keyword);原生 SQL:
// nativeQuery = true 表示写的是数据库原声 SQL@Query(value = "SELECT * FROM product WHERE price > :price", nativeQuery = true)List<ProductEntity> findExpensiveProducts(@Param("price") Double price);测试验证:
@Testvoid searchByName() { // JPQL 面向对象的查询语言,操作 Entity 而非表 List<ProductEntity> laptops = productJpaRepository.searchByName("Laptop"); assertEquals(1, laptops.size()); assertEquals("Laptop", laptops.get(0).getName());}@Testvoid findExpensiveProducts() { // 原生 SQL 直接操作数据库表 List<ProductEntity> expensive = productJpaRepository.findExpensiveProducts(1000.0); assertEquals(2, expensive.size()); assertTrue(expensive.stream().allMatch(p -> p.getPrice() > 1000.0));}4.4 分页和排序
// 按价格降序,第 1 页(从 0 开始),每页 2 条PageRequest pageRequest = PageRequest.of(0, 2, Sort.by("price").descending());Page<ProductEntity> page = productJpaRepository.findAll(pageRequest);System.out.println("总记录数: " + page.getTotalElements()); // 3System.out.println("总页数: " + page.getTotalPages()); // 2System.out.println("当前页数据: " + page.getContent()); // [Laptop, Phone]测试验证:
@Testvoid paginationAndSort() { PageRequest pageRequest = PageRequest.of(0, 2, Sort.by("price").descending()); Page<ProductEntity> page = productJpaRepository.findAll(pageRequest); assertEquals(3, page.getTotalElements()); assertEquals(2, page.getTotalPages()); assertEquals(2, page.getContent().size()); assertEquals("Laptop", page.getContent().get(0).getName()); assertEquals("Phone", page.getContent().get(1).getName());}@Testvoid paginationSecondPage() { // 第 2 页只有 1 条记录 PageRequest pageRequest = PageRequest.of(1, 2, Sort.by("price").descending()); Page<ProductEntity> page = productJpaRepository.findAll(pageRequest); assertEquals(1, page.getContent().size()); assertEquals("Book", page.getContent().get(0).getName());}五、源码级分析
5.1 Repository 动态代理原理
小 A 最初觉得很不可思议:只声明了一个空接口,Spring 怎么就能调用它的方法?
答案在于 JDK 动态代理。
Spring Data 在启动时,对每个 Repository 接口做了以下处理:
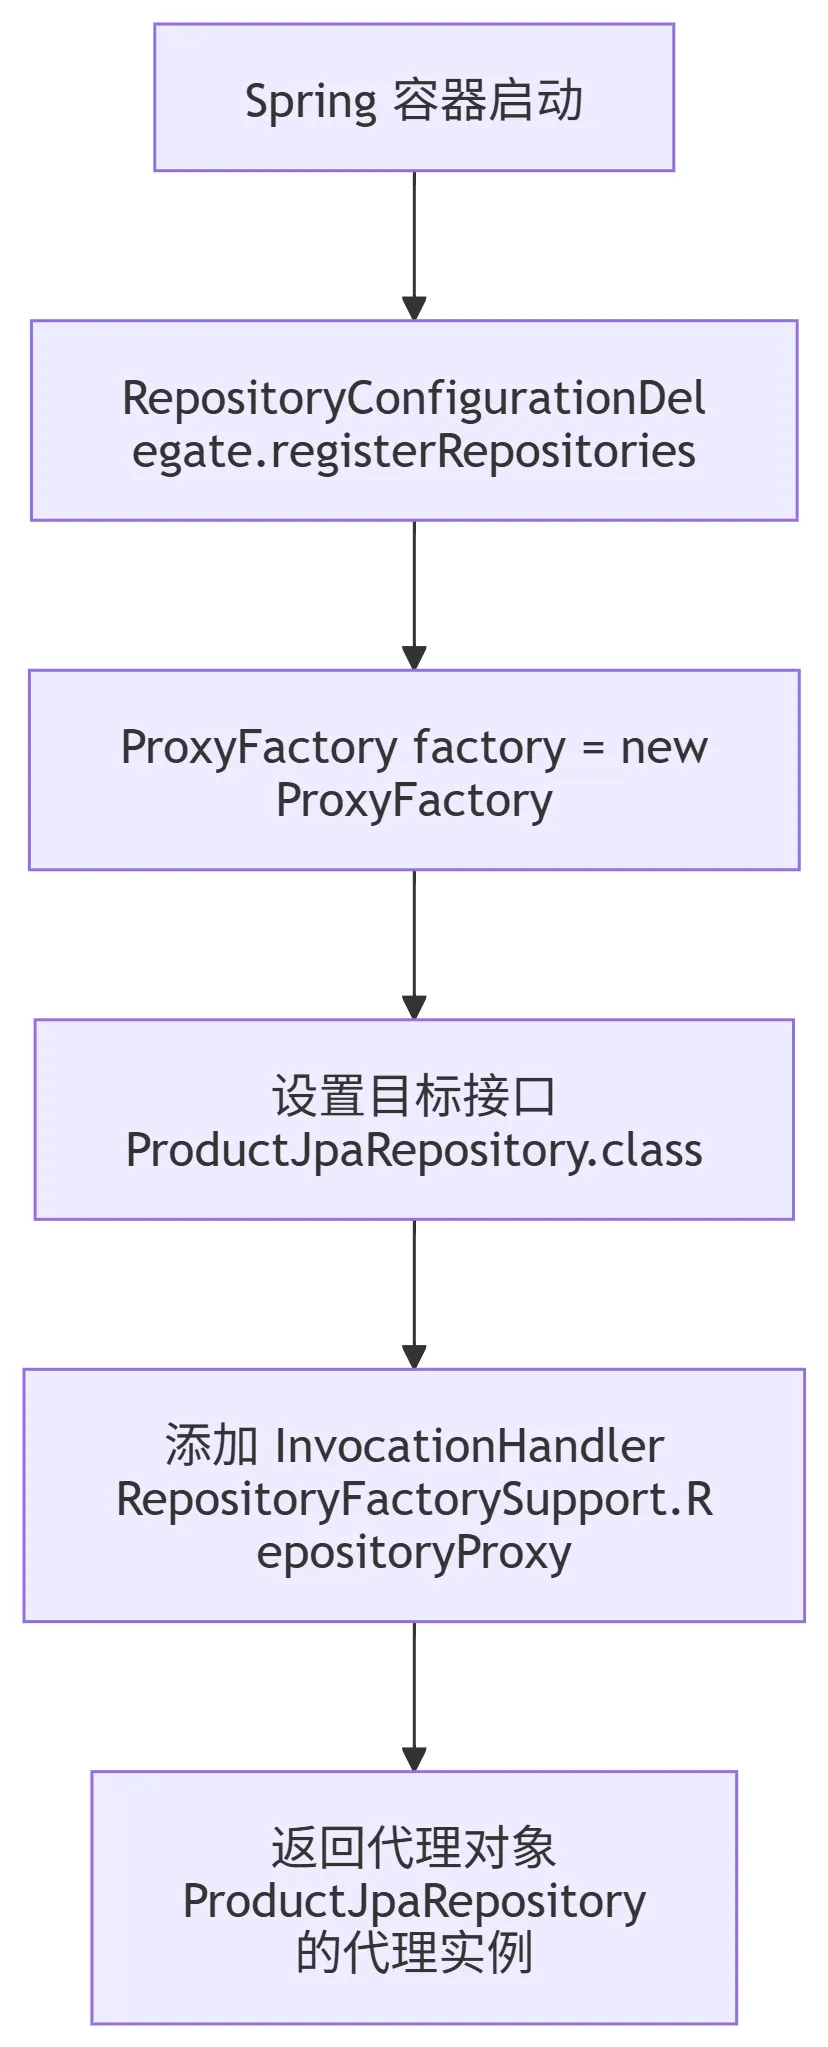
源码简化示意:
// Repository 工厂创建代理的核心逻辑(简化)public class RepositoryFactorySupport { @SuppressWarnings("unchecked") public <T> T getRepository(Class<T> repositoryInterface, Object customImplementation) { // 1. 获取 Repository 元数据(领域类型、ID 类型) RepositoryMetadata metadata = getRepositoryMetadata(repositoryInterface); Class<?> domainClass = metadata.getDomainType(); // ProductEntity Class<?> idClass = metadata.getIdType(); // Integer // 2. 创建代理工厂 ProxyFactory factory = new ProxyFactory(); factory.setInterfaces(repositoryInterface); // 3. 添加核心方法拦截器 factory.addAdvice(new QueryExecutorMethodInterceptor(metadata, entityManager)); // 4. 生成代理对象 return (T) factory.getProxy(classLoader); }}调用代理方法时,请求被转发到 QueryExecutorMethodInterceptor,它判断方法类型:
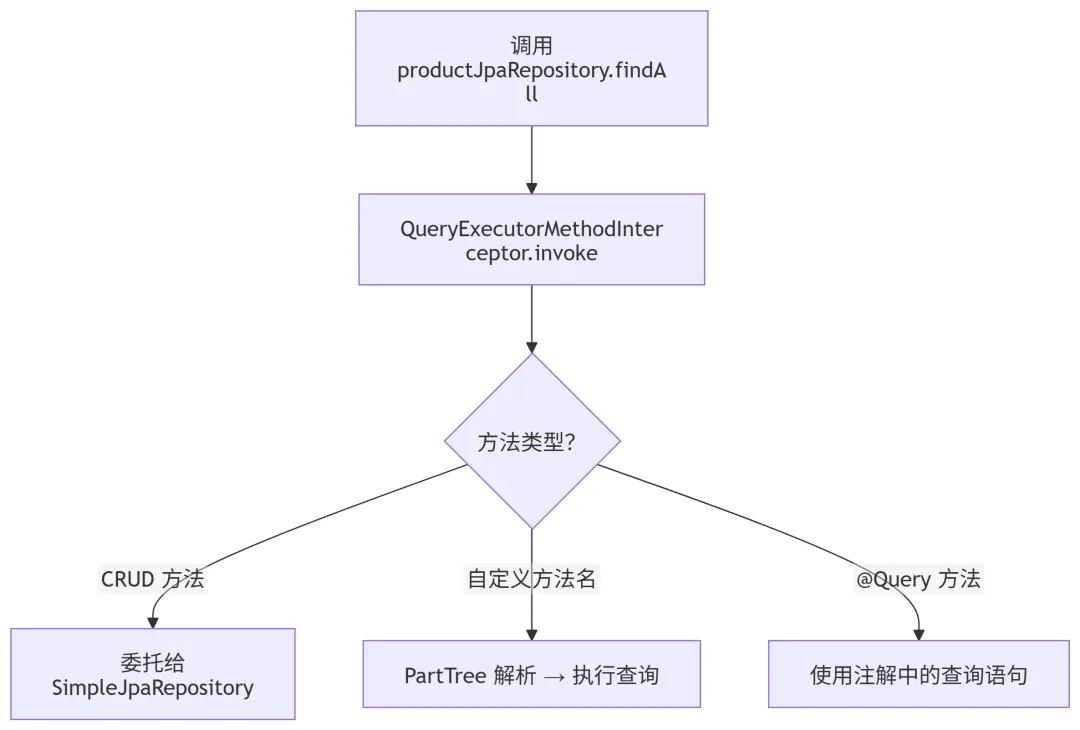
5.2 PartTree 方法名解析原理
当调用 findByCategoryAndPriceLessThan("Electronics", 1000.0) 时,Spring Data 内部经历了怎样的过程?
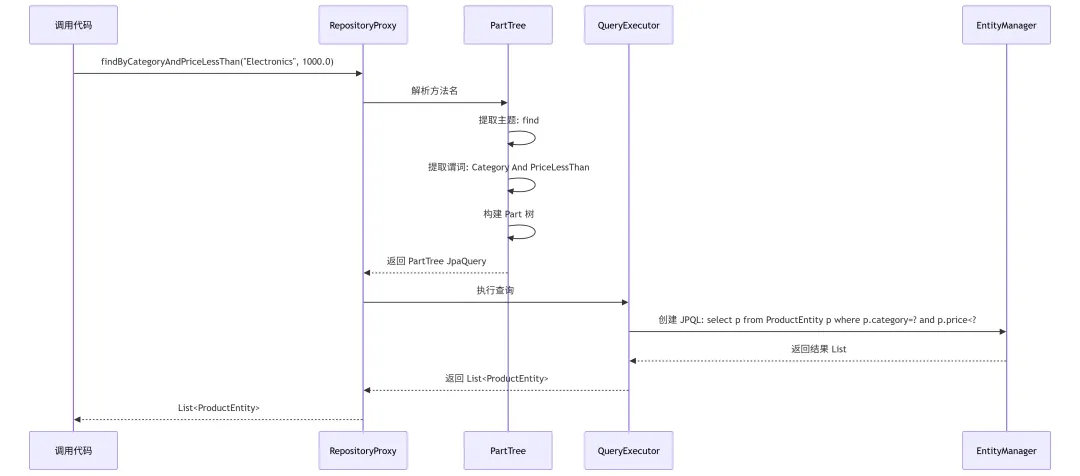
PartTree 解析过程:
// PartTree 的构造和解析(简化)public class PartTree { private final String methodName; // "findByCategoryAndPriceLessThan" private final Subject subject; // 查询主题(find/exists/count) private final Predicate predicate; // 查询谓词 private final Optional<Sort> sort; // 排序信息 public PartTree(String methodName, Class<?> domainClass) { // 1. 解析前缀:find / exists / count / delete / get this.subject = new Subject(methodName); // 2. 解析主题(OrderBy / Distinct / First / TopN) subject = subject.and(new Subject(methodName)); // 3. 解析查询条件:用 And / Or 拆分为多个 Part this.predicate = new Predicate(subject.getPredicateText(), domainClass); // CategoryAndPriceLessThan → 两个 Part: // Part[1]: property="category", keyword=IS_NULL (默认等于) // Part[2]: property="price", keyword=LESS_THAN }}解析步骤拆解:
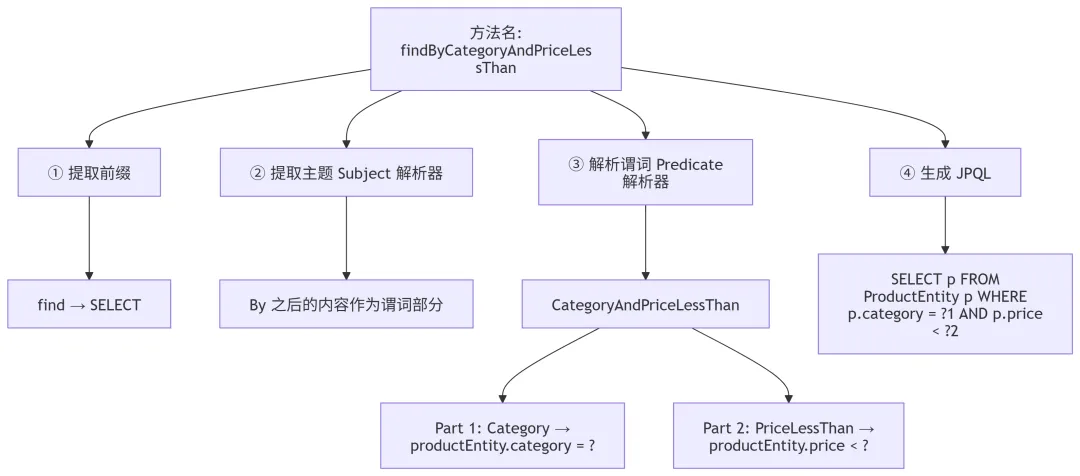
查询策略选择:
Spring Data 按以下优先级选择查询策略:
1. CREATE:直接从方法名创建查询(默认策略) 2. USE_DECLARED_QUERY:使用 @Query注解中声明的查询3. CREATE_IF_NOT_FOUND:如果没找到声明的查询,则从方法名创建 4. DECLARED_AND_PROBED_METHODS:结合 @Query和方法名推导
配置方式:
spring.data.jpa.repositories.query-strategy=create_if_not_found5.3 Entity 状态机
理解 Entity 状态是掌握 JPA 的核心。每个 Entity 实例在某一时刻处于以下四种状态之一:
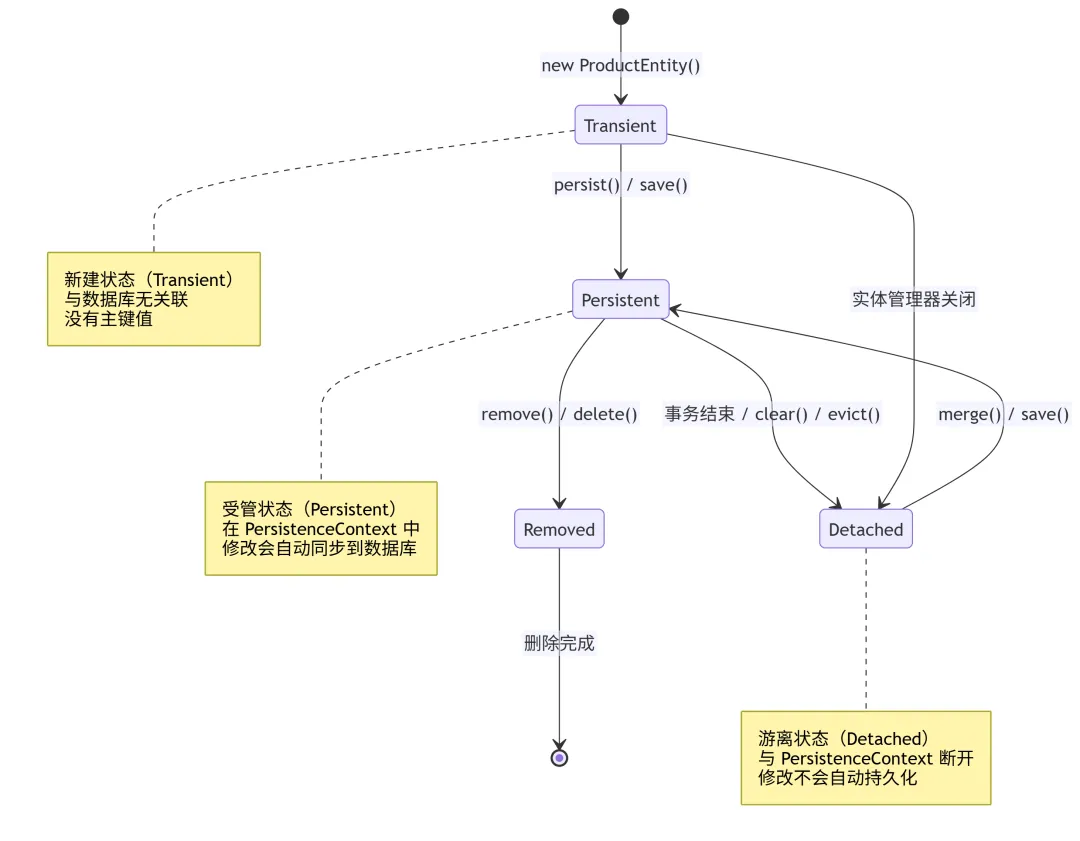
四种状态的含义:
| Transient | ||
| Persistent | ||
| Detached | ||
| Removed |
状态转换的方法:
persist()save() | |
clear(), evict() | |
merge()save() | |
remove()delete() |
测试验证 Detached 状态:
@Testvoid detachedEntityNotPersisted() { // 第一次查询:Entity 在事务结束后变为 Detached 状态 ProductEntity product = productJpaRepository.findById(1).orElseThrow(); assertEquals("Laptop", product.getName()); // 手动清空 EntityManager,模拟 Entity 变为 Detached entityManager.clear(); // 修改 Detached Entity 的属性 product.setName("Changed Name"); // 再次查询,验证数据库未被修改 ProductEntity fromDb = productJpaRepository.findById(1).orElseThrow(); assertEquals("Laptop", fromDb.getName()); // 数据库值不变 assertNotEquals("Changed Name", fromDb.getName());}@Testvoid reattachEntityWithSave() { // Detached Entity 需要通过 save() 重新持久化(merge) ProductEntity product = productJpaRepository.findById(1).orElseThrow(); entityManager.clear(); product.setName("New Name"); productJpaRepository.save(product); // merge 操作 entityManager.flush(); entityManager.clear(); ProductEntity updated = productJpaRepository.findById(1).orElseThrow(); assertEquals("New Name", updated.getName());}5.4 Hibernate 一级缓存(PersistenceContext)
Hibernate 的一级缓存就是 EntityManager 内部的 PersistenceContext,它是 Session 级别的缓存。
工作原理:
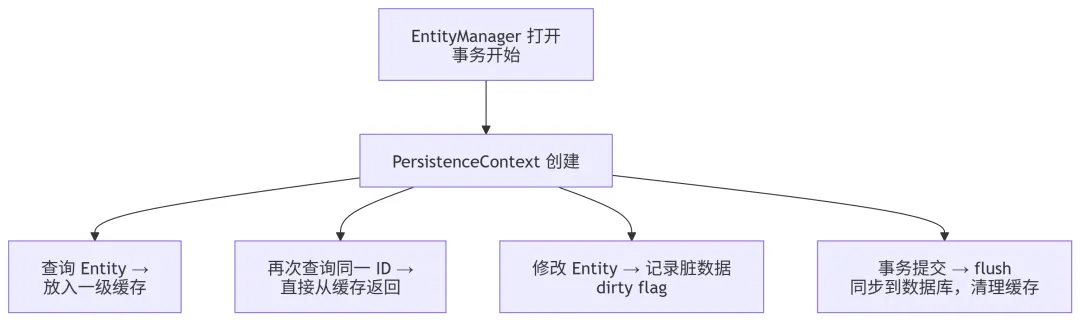
关键概念:
FlushMode.AUTO | |
FlushMode.COMMIT | |
flush() | |
clear() | |
evict(entity) | |
refresh(entity) |
Flush 触发时机:
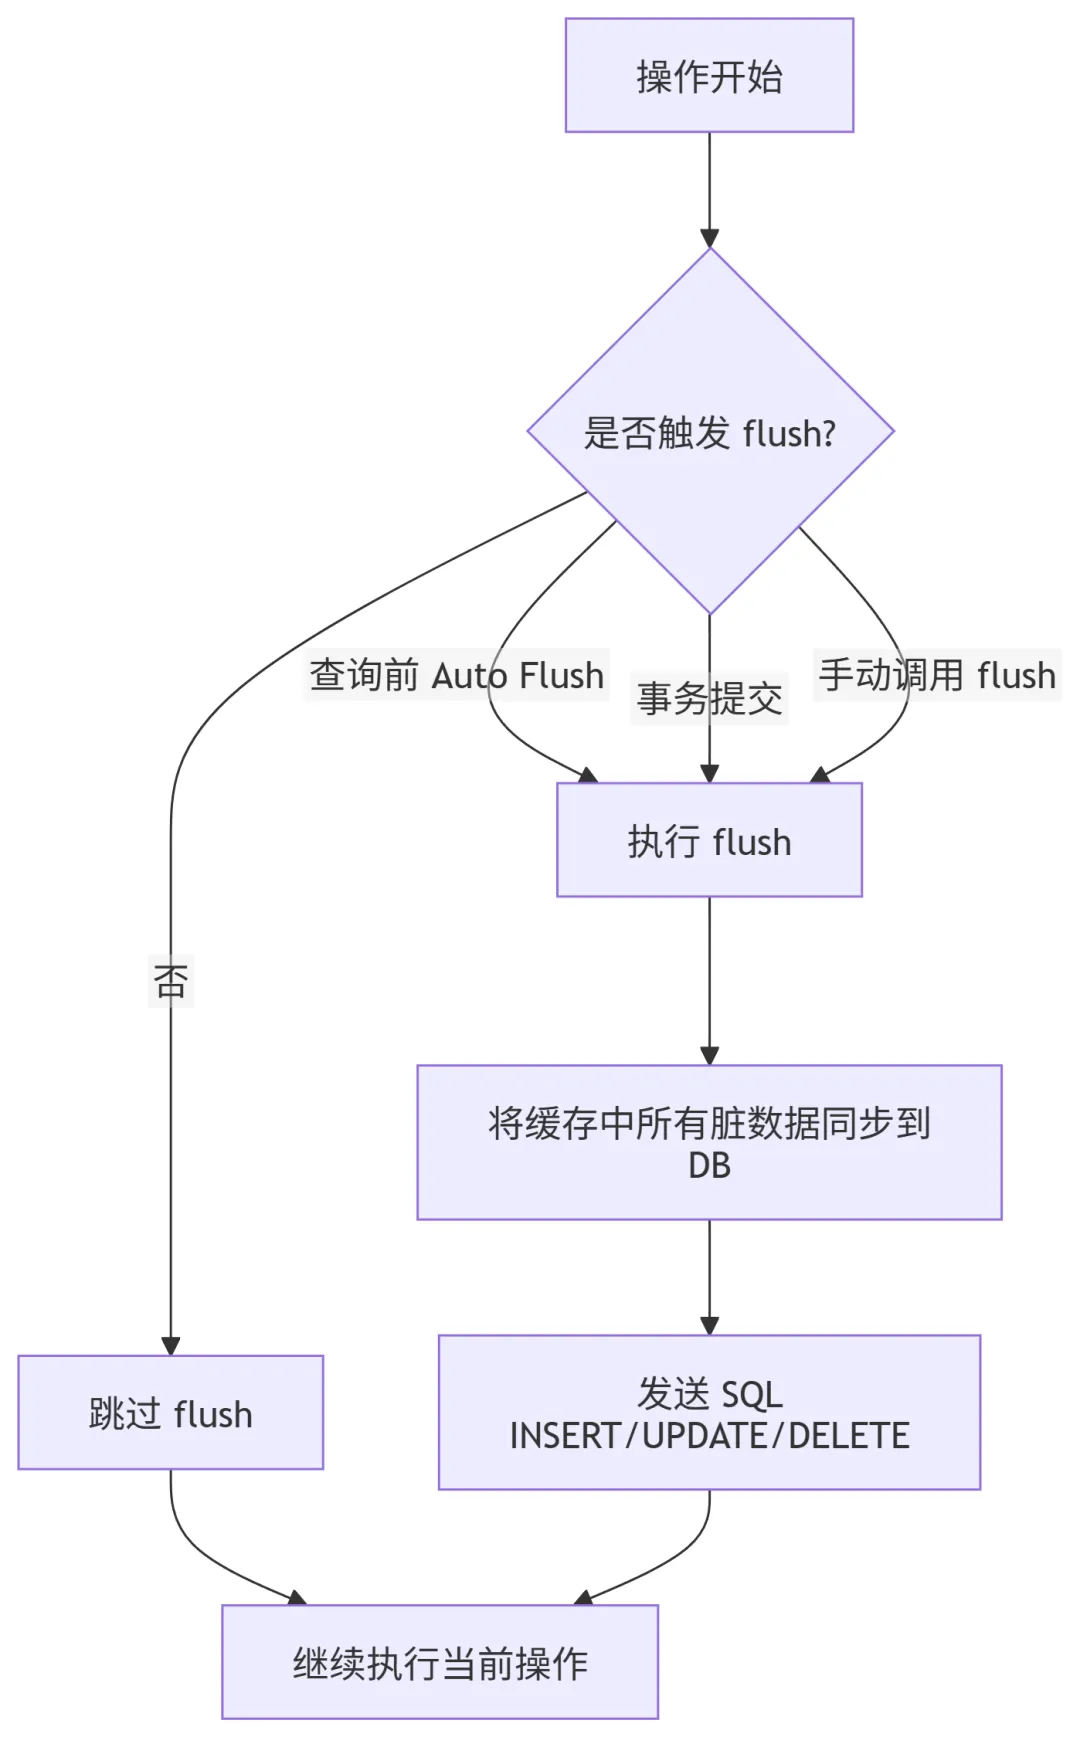
测试验证脏检查:
@Test@Transactionalvoid dirtyChecking() { // 在事务内修改受管 Entity,无需显式调用 save() ProductEntity product = productJpaRepository.findById(1).orElseThrow(); assertEquals("Laptop", product.getName()); // 修改属性 product.setName("MacBook Pro"); product.setPrice(12999.00); // 不调用 save(),事务提交时 Hibernate 自动检测脏数据并更新 entityManager.flush(); // 重新从数据库查询,验证已更新 entityManager.clear(); ProductEntity updated = productJpaRepository.findById(1).orElseThrow(); assertEquals("MacBook Pro", updated.getName()); assertEquals(12999.00, updated.getPrice());}5.5 脏检查机制(Dirty Checking)
脏检查是 Hibernate 自动将内存中的 Entity 变更同步到数据库的核心机制。它的原理并不复杂,但理解它对排查问题至关重要。
原理概述:
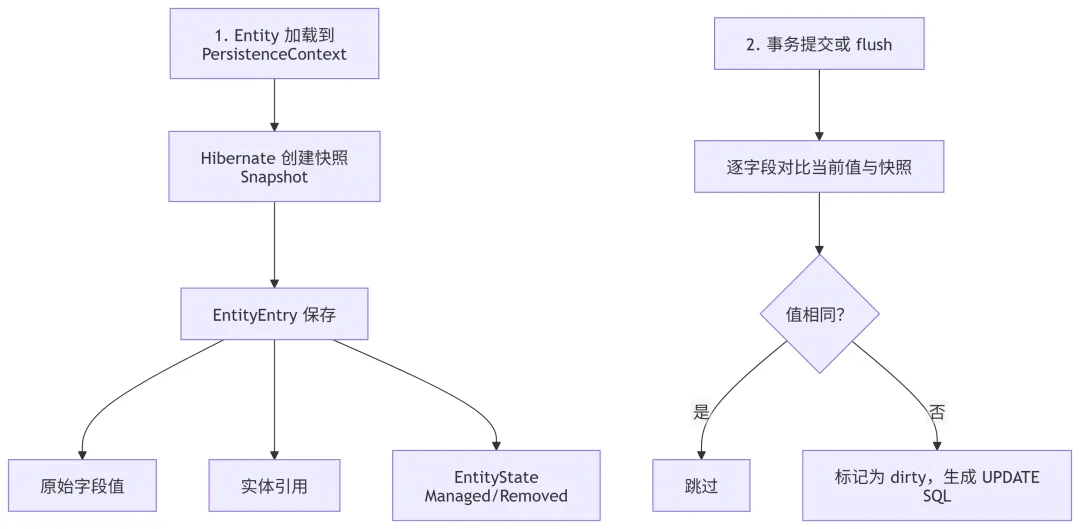
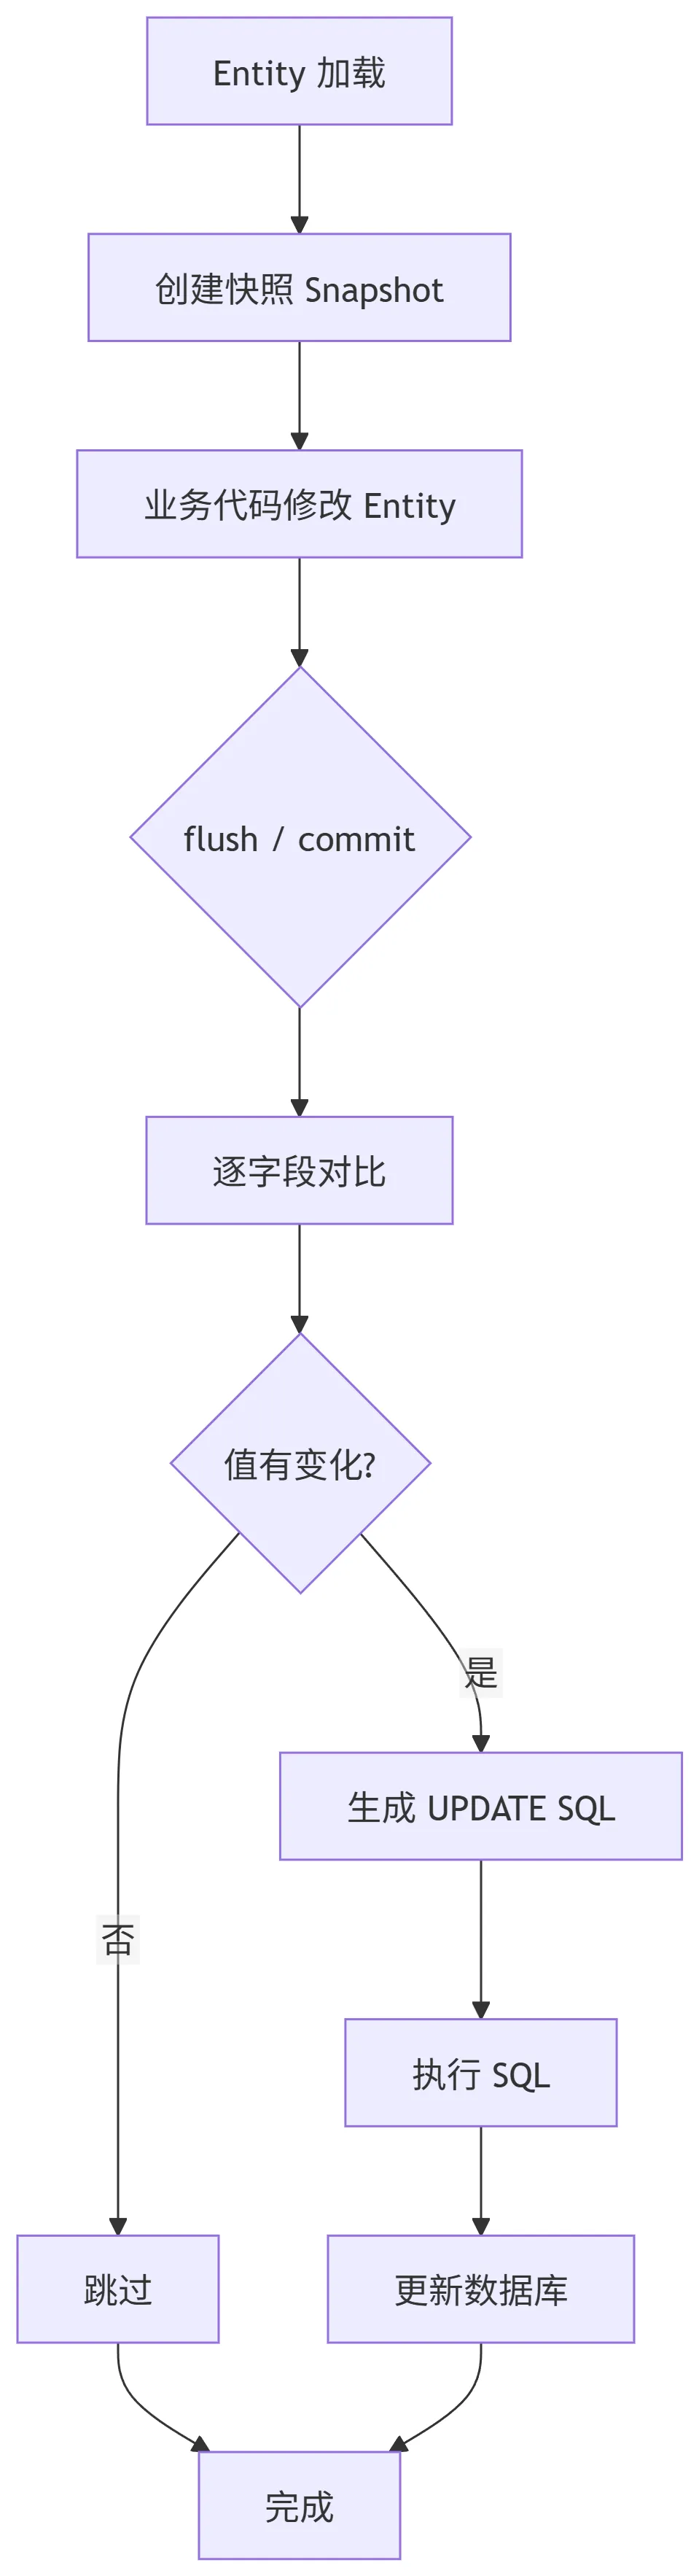
集合追踪(PersistentSet / PersistentBag):
Hibernate 对 @OneToMany 等集合类型的字段进行了包装,将其替换为 PersistentSet、PersistentBag 等自定义集合类。这些包装类会在 add()、remove() 操作时记录变更标记,flush 时一并同步。
5.6 @Transactional 与 EntityManager 的集成
@Transactional 注解为什么能让 EntityManager 自动绑定到当前线程?
Spring 通过 TransactionSynchronizationManager(事务同步管理器)实现了线程级别的 EntityManager 绑定:
方法进入 @Transactional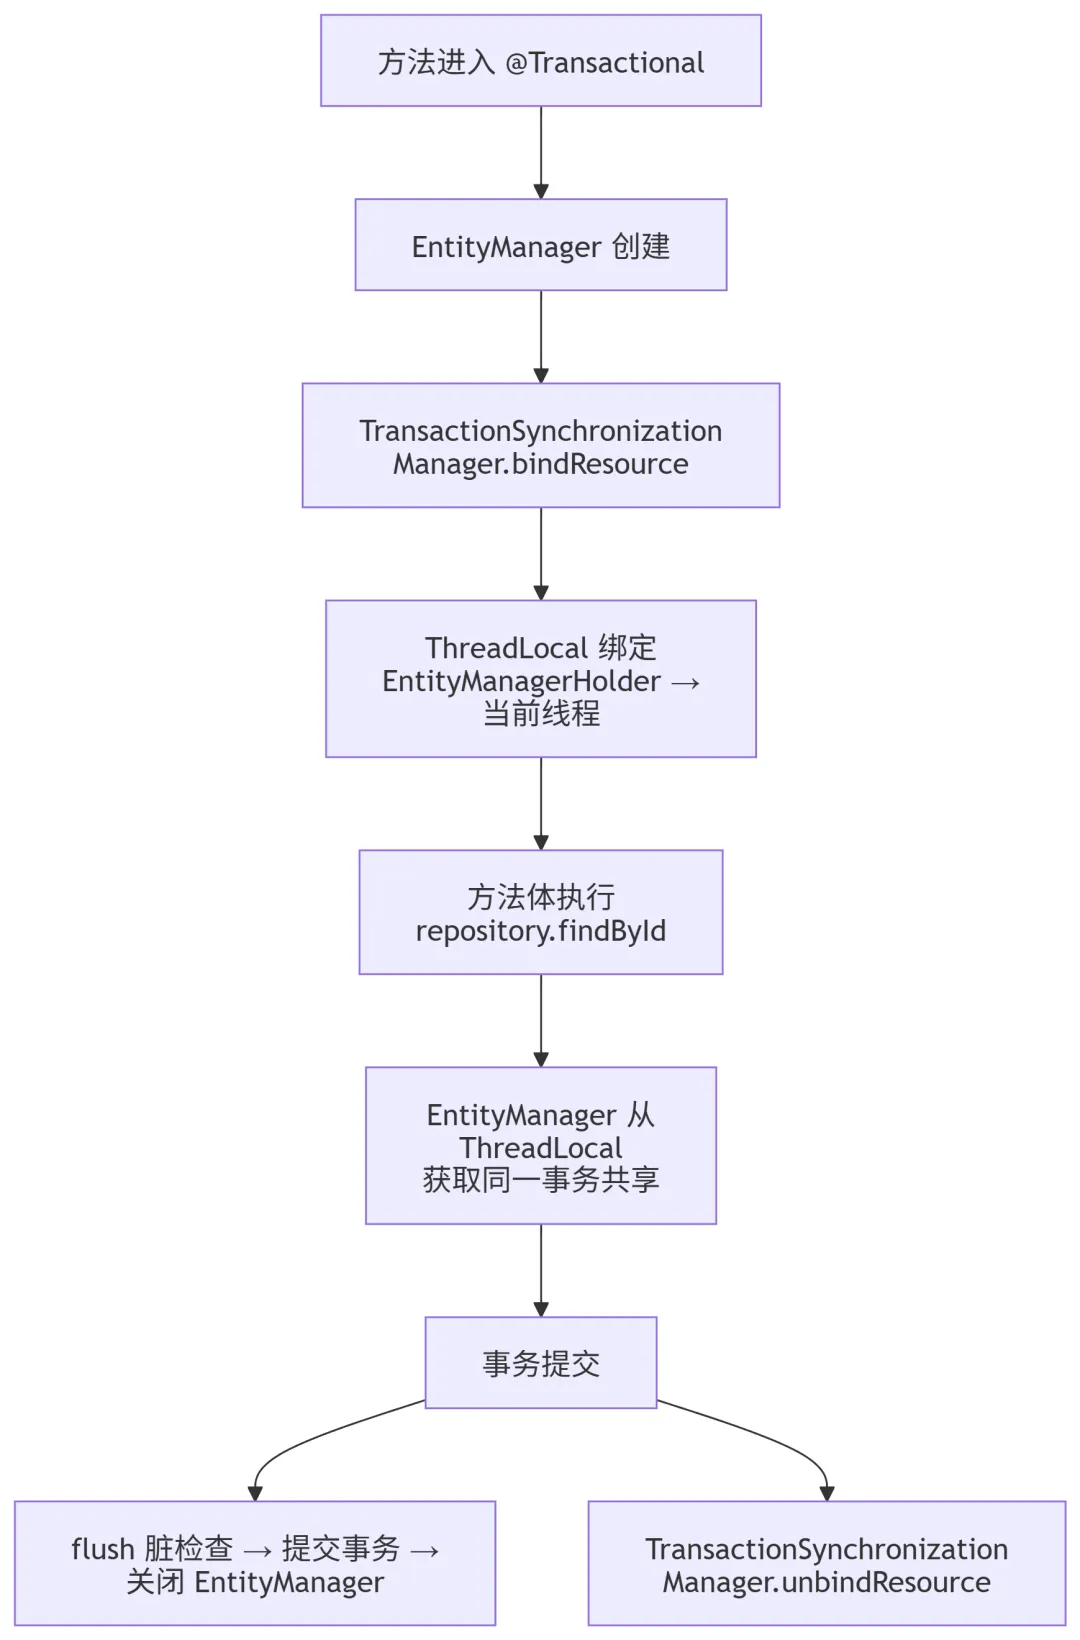
关键源码简化:
// Spring 在事务开启时绑定 EntityManagerpublic static EntityManager getTransactionalEntityManager( EntityManagerFactory emf, @Nullable String persistenceContextKey) { // 从 ThreadLocal 获取已绑定的 EntityManagerHolder SharedEntityManagerHolder holder = (SharedEntityManagerHolder) TransactionSynchronizationManager.getResource(emf); if (holder != null && holder.isSynchronized()) { return holder.getCachedEntityManager(); // 返回当前事务中的 EntityManager } // 否则创建新的}类比:这就像餐厅服务员(TransactionSynchronizationManager)把客人的订单(EntityManager)挂在对应桌号(线程)的架子上。同桌上的人(同一个线程中的方法调用)拿到的都是同一张订单。
5.7 N+1 查询问题及解决方案
什么是 N+1 问题?
当加载一个主查询(1 次查询)后,对每个结果项再查询关联数据(N 次查询),总共执行了 1 + N 次 SQL。
// 场景:查询所有产品及其所属分类List<ProductEntity> products = productJpaRepository.findAll(); // 1 次查询for (ProductEntity p : products) { System.out.println(p.getCategoryEntity().getName()); // N 次查询(LAZY 触发)}// 总共 4 次 SQL:1 条查 product,3 条查 category解决方案对比:
// 方案一:@EntityGraph(声明式)@EntityGraph(attributePaths = {"categoryEntity"})List<ProductEntity> findAll();// 方案二:JOIN FETCH(JPQL)@Query("SELECT DISTINCT p FROM ProductEntity p JOIN FETCH p.categoryEntity")List<ProductEntity> findAllWithCategory();// 方案三:@BatchSize(批量加载,减少查询次数)@BatchSize(size = 10)@ManyToOne@JoinColumn(name = "category_id")private CategoryEntity categoryEntity;// 效果:原来 N 次查询,现在减少为 N/10 次@EntityGraph | |||
JOIN FETCH | Pageable 并用 | ||
@BatchSize |
测试验证 OneToMany:
@Testvoid oneToManyRelationship() { // 查询 Electronics 分类及其关联的产品 CategoryEntity electronics = categoryJpaRepository.findById(1).orElseThrow(); assertEquals("Electronics", electronics.getName()); // OneToMany 默认 LAZY 加载,访问时才触发查询 List<ProductEntity> products = electronics.getProducts(); assertEquals(2, products.size()); assertTrue(products.stream().allMatch(p -> "Electronics".equals(p.getCategory())));}@Testvoid manyToOneRelationship() { // 查询产品所属的分类 ProductEntity laptop = productJpaRepository.findById(1).orElseThrow(); CategoryEntity category = laptop.getCategoryEntity(); assertNotNull(category); assertEquals("Electronics", category.getName());}六、常见误区
误区一:Detached Entity 修改会自动持久化
// ❌ 错误理解ProductEntity product = repository.findById(1).orElseThrow();// 事务已结束,product 变为 Detached 状态product.setName("Changed");// 期望:自动更新到数据库// 实际:不会更新!Detached 状态的修改不会持久化// ✅ 正确做法product.setName("Changed");repository.save(product); // merge 操作,重新关联到 PersistenceContext类比:Detached Entity 就像你离开了银行柜台后的存折。你自己在存折上改了数字,银行不会认。必须重新把存折交给柜员(
save()),柜员才会帮你更新。
误区二:@Transactional 可以加在任意方法上
// ❌ 错误:在同一个类内部调用,事务不生效@Servicepublic class ProductService { public void updateName(Integer id, String name) { this.doUpdate(id, name); // 内部调用,不经过代理,@Transactional 失效 } @Transactional public void doUpdate(Integer id, String name) { ProductEntity p = repository.findById(id).orElseThrow(); p.setName(name); }}// ✅ 正确做法一:把 @Transactional 加到外部调用方法上@Transactionalpublic void updateName(Integer id, String name) { ... }// ✅ 正确做法二:把事务方法放到另一个 Service 中Spring 的 @Transactional 基于 AOP 代理,只有在通过代理对象调用时才会生效。同一个类内部的方法调用不经过代理。
误区三:Fetch.LAZY 序列化导致 LazyInitializationException
// ❌ 错误:在 Controller 层序列化 Entity 时,事务已结束@GetMapping("/products/{id}")public ProductEntity getProduct(@PathVariable Integer id) { ProductEntity p = productService.findById(id); return p; // Jackson 序列化时访问 categoryEntity → LazyInitializationException}// ✅ 正确做法一:使用 DTO 隔离@GetMapping("/products/{id}")public ProductDTO getProduct(@PathVariable Integer id) { ProductEntity p = productService.findById(id); return new ProductDTO(p.getName(), p.getCategoryEntity().getName());}// ✅ 正确做法二:在事务内初始化关联@Transactionalpublic ProductEntity findByIdWithCategory(Integer id) { ProductEntity p = repository.findById(id).orElseThrow(); p.getCategoryEntity().getName(); // 强制加载 return p;}误区四:save() 和 persist() 没有区别
// persist():仅处理 Transient 状态,传入 Detached 会抛异常entityManager.persist(new ProductEntity("New", 100.0, "Test"));// save()(Spring Data Repository):// - Transient → persist// - Detached → merge(重新关联到 PersistenceContext)// 更灵活,是 Spring Data 推荐的方式误区五:findAll() 返回空列表而不是 null
// ❌ 错误:对 findAll() 返回值做空指针检查List<ProductEntity> products = repository.findAll();if (products == null) { // 永远不会成立! // ...}// ✅ 正确:直接判断是否为空if (products.isEmpty()) { // ...}findAll() 和 findBy... 方法返回的是空集合,不是 null。只有 findById() 返回 Optional<T>。
七、单元测试
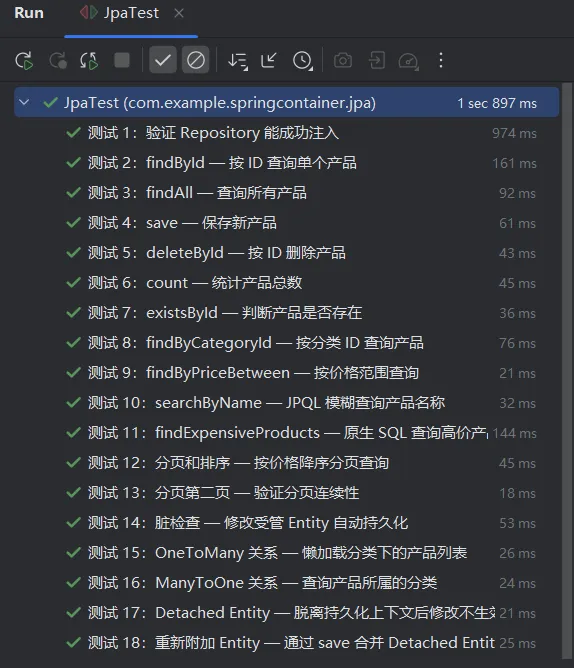
具体查看:JPA全解析(单元测试),核心测试覆盖:
八、总结与最佳实践
核心要点
@Entity、@Table、@Id 等注解映射数据库表 | |
JpaRepository,零代码实现 CRUD | |
@EntityGraph、JOIN FETCH 或 @BatchSize |
设计哲学
JPA 的设计体现了几个核心思想:
• 约定优于配置:字段名默认映射列名,减少配置 • 对象关系映射:用面向对象的方式操作数据,隐藏 SQL 细节 • 状态驱动:通过 Entity 状态机管理数据生命周期,而非显式 CRUD 调用 • 缓存优先:一级缓存减少数据库交互,脏检查降低手动同步成本
最佳实践清单
1. 始终使用 @Transactional控制事务边界:写操作(save/delete)必须有事务包裹2. 优先用 @ManyToOne维护关系:@OneToMany设为mappedBy只读3. 理解 Entity 状态再写代码:Transient/Detached 状态下调用方法行为不同 4. 避免 N+1 查询:用 @EntityGraph或JOIN FETCH预加载关联数据5. 使用 DTO 隔离序列化:避免 LazyInitializationException 6. 不要用 Detached Entity 直接修改:先 merge 回 PersistenceContext 7. 合理配置 FlushMode:只读事务用 FlushMode.MANUAL减少不必要的 flush
九、面试自测
•能说出 JPA、Hibernate、Spring Data JPA 三者的关系 •理解 Entity 的四种状态(Transient / Persistent / Detached / Removed)及其转换方法 •理解 Repository 动态代理的创建过程(ProxyFactory + RepositoryMetadata) •理解 PartTree 如何将方法名解析为 JPQL(前缀 → 谓词 → Part 树) •理解 Hibernate 一级缓存(PersistenceContext)的刷新时机和 clear/evict/refresh 的区别 •理解脏检查机制(snapshot 对比、PersistentSet 集合追踪) •理解 @Transactional 如何通过 TransactionSynchronizationManager 绑定 EntityManager •理解 N+1 查询问题及 @EntityGraph / JOIN FETCH / @BatchSize 的对比 •知道 Detached Entity 修改不会自动持久化 •知道 @Transactional 在同一类内部调用不生效(自调用问题) •知道 Fetch.LAZY 序列化导致 LazyInitializationException 的解决方案 •能区分 @Query JPQL 和 nativeQuery 的使用场景 •能解释 save() 和 persist() 的区别 •知道 findAll() 返回空集合而非 null
👉 查看详细参考答案:JPA全解析(面试自测与答案),期待下文~
参考资料
• Spring Data JPA 官方文档:spring.io/projects/spring-data-jpa • Hibernate ORM 官方文档:hibernate.org/orm • Jakarta Persistence API 规范:jakarta.ee/specifications/persistence • 《Spring 实战》(第 6 版)第 14 章 — 使用 Spring Data 持久化数据 • 《Java 持久化权威指南》(Java Persistence with Hibernate)