 夜雨聆风
"你以为缺的是工具,其实缺的是图纸。"
三个周前,一个朋友跟我说,他搭了个 Agent ,跑了 50 步,最后崩了。
不是模型不行。不是提示词不优。是——
架构有问题。
这句话我最近听到太多次了。 2026 年,满世界都在聊 AI Agent 。 LangChain 12 个主流框架轮着更新, CSDN 上说"90% 的人还停留在'用 LLM 写个自动脚本'的阶段"。工具堆了一桌子。吹得天花乱坠。
但工具不是架构。
说真的, 2026 年了,还在把人往工具堆里赶——这风气温温吞吞的,让人不太舒服。
很多人把 Agent 做成一把瑞士军刀——18 种功能,每个都能用,每个都不牢。你问他"怎么串的?"答不上来。一跑长任务,第 15 步报错,从头崩溃。
这不算架构。这叫堆砌。不对,"堆砌"这个词都客气的——这叫糊弄。架构的核心是"结构",不是"功能"。
打个比方。你在盖房子。工具是砖头。架构是蓝图。你买了一卡车砖头,没有图纸——砖头再多,堆出来的不是房子,是垃圾堆。

模块一:记忆——没有记忆的 Agent 就是每天失忆的病人
先说第一个模块。记忆系统。
很多人以为"记忆"就是保存对话历史。
不对。差得远。应该这么说——记忆是你 Agent 的命根子,不是附属品。
一个生产级的 Agent 记忆至少分三层。工作记忆,当前任务的上下文窗口,类似你的短期记忆——记住现在在干嘛。情景记忆,过去交互的摘要,你上周做过什么。语义记忆,结构化的知识库,你学到的行业常识。
三层各管各的事。工作记忆要精简,塞太多上下文窗口就爆了——这就是所谓的"边际效应递减",懂的都懂。情景记忆要可检索,下次遇到类似任务能调出来。语义记忆要持久化,不能关个终端就没了。
没有记忆的 Agent 是什么状态?你每次跟它说话,都像在跟一个刚睡醒的人重复昨天的事。生产力?谈不上。
LangGraph 去年就内置了 checkpoint 机制做状态持久化。 CrewAI 也有 memory layer 。工具已经有了,关键是你怎么分层。
一个问题:你的 Agent 记忆粒度是什么?按轮次存?按任务切片存?按语义相似度归档?这个选择直接影响你的 Agent 到底"记不记事"。
模块二:工具编排——不是把 API 挂上去就叫"编排"
第二个模块,也是大部分人最擅长的——不做。
工具往 Agent 身上一挂就完事了。这不叫编排。这叫甩手掌柜。
说出去都不好意思。
编排是策略。好比一个厨师知道有刀有锅不算本事,什么时候切什么时候炒才是。
2026 年主流编排模式三种。
顺序执行——一步做完再做下一步。稳,但慢。适合步骤固定的流程。
并行执行——几个工具同时跑。快,但有依赖关系的不能并行。 macgpu.com 那份 2026 生产指南列了六种编排模式,并行是效率提升最明显的一种。
层级执行——主 Agent 拆任务,子 Agent 分头干。这就是所谓的"编排器-Worker"模式。复杂场景扛得住,但设计不好,上下文在传递中污染,子 Agent 之间死锁,够你头疼的。
我见过一个真实案例。有人把所有工具塞进顺序执行,一个任务跑 45 秒。后来改成并行——同样的任务, 8 秒。
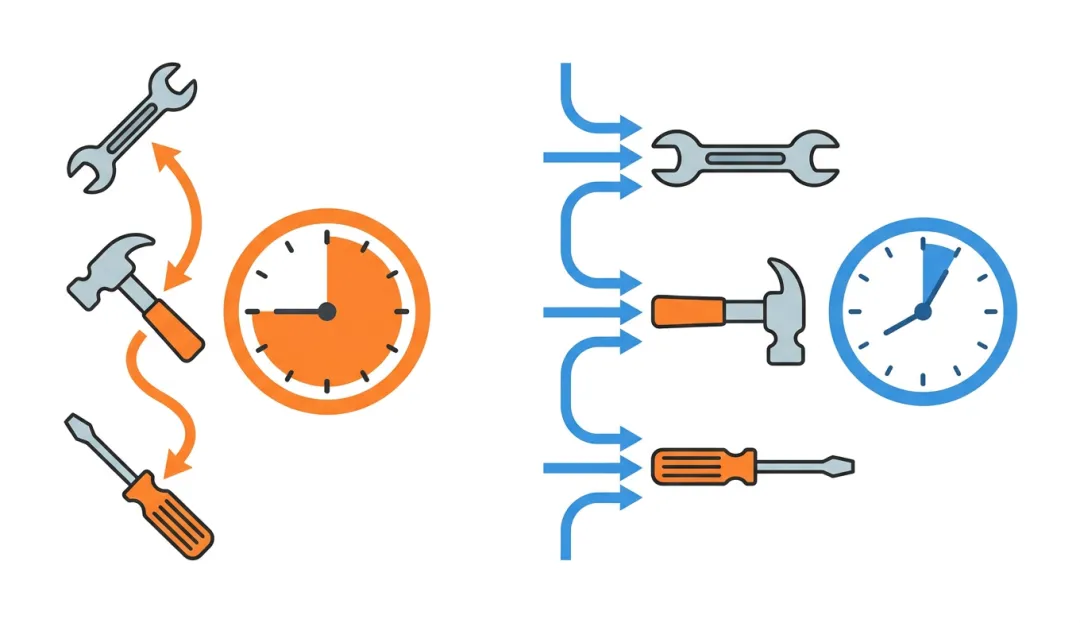
不是工具不行。是你的编排策略不行。
框架怎么选? LangGraph 用状态机建模,灵活但学习曲线陡。 CrewAI 用角色分工,直观但复杂场景容易卡壳。 AutoGen 用对话驱动,在处理多方交互时有优势。
选哪个不重要。重要的是你知不知道自己的工具依赖关系是线性的、并行的、还是分层的。
模块三:错误恢复——90% 的 Agent 没有"后悔药"
第三个模块。这个模块,九成的人没想过。
一个 Agent 跑了 20 步。第 18 步崩了。怎么办?
"从头来。"
——这是多数人的回答。
荒谬。
不对,也不能全怪他们。框架不给力是客观事实,但现实就是这样。
大量 Agent 框架没有检查点。一步错,步步错。用户能做的就是重新输入 prompt ,再等 30 秒。这体验,说实话,挺让人崩溃的。
生产级的 Agent 需要"存档点"。像打游戏——每过一个关键节点,自动存盘。失败了,从最近的存档点恢复,而不是从头读档。
错误处理至少设计三种。可重试的——API 超时、限流,等几秒再来。可降级的——图片生成失败?用文字描述顶上,继续跑。需要人介入的——比如需要确认付款信息,暂停等用户。
三种情况, Agent 得分得清。不是一出错就全体崩溃。
这才是生产力。不是"跑得快",是"摔了能爬起来"。
模块四:人机边界——不是所有事都该让 Agent 自己干
第四个模块。容易被忽略,但出事就是大事。
你让 Agent 帮你写了封邮件,直接发出去了。写错了。收件人是你老板。
谁背锅?
你。没跑的。
所以人机协作的边界必须设计好。哪些节点 Agent 自己走,哪些节点必须人点头。 Anthropic 的 Claude 在处理文件写入、邮件发送这类操作时会主动请求确认——这就是边界设计。不是能力不够,是知道什么时候该停。
我的建议是用"信任阶梯"设计。
读操作——自动。写操作——确认。不可逆操作——等人。
三层。清清爽爽。你用得安心,它跑得有分寸。
模块五:多 Agent 协同——一个人干不了,一群人就能?
最后说说多 Agent 。这是今年最热的方向。 arXiv 上个月刚出了 RecursiveMAS——递归多智能体系统, Agent 下面套 Agent ,一层套一层。
概念很酷。落地嘛——
一个字:难。两个字:扯淡。
单个 Agent 搞不定,多个 Agent 就搞定了?不一定。多 Agent 协同面对的核心问题是:通信、分工、冲突。跟你管一个团队一模一样。
2026 年主流的协同模式, macgpu 那份指南总结了三种——
Supervisor:一个"老板" Agent 分配任务,其他"员工"执行。稳,最常用。
Swarm:没有老板,各自抢活,通过共享信息协调。 Kimi K2.6 那个号称能管 300 个子 Agent 的系统就是走这条路。据说市场预计 2034 年多 Agent 市场能到 2360 亿美元。但说实话,大部分人连 3 个 Agent 的协同都理不顺。
Pipeline: Agent 排成流水线,一个做完传给下一个。适合阶段明确的任务——调研、写作、审核,三步三个人。
一个坑:别过度工程化。两个 Agent 能干的事别硬上 6 个。每多一个 Agent ,通信成本加一层,出错概率涨一分。从单 Agent 开始。遇到性能瓶颈了再拆。
跟微服务一个道理——不是为了拆而拆,是规模到了不得不拆。
五个模块。记忆、编排、容错、人机边界、多 Agent 协同。
不需要一次全想明白。但至少得知道有这五块。这样你的 Agent 出了问题,你能说出是哪块的问题。
回到开头那个跑了 50 步崩掉的 Agent 。
如果有记忆——第 40 步存档,崩了从 40 继续,不用从头来。如果有并行——速度拉三倍,不用傻等。如果有错误恢复——第 48 步报错,重试,不用全部报废。如果有人机边界——第 35 步那个不确定的操作,先问你。
工具没毛病。
有毛病的是架构。一直是。
架构不是装修,是地基。
关于码孖 AI
码孖 AI ,专注 AI 工程化落地。我们相信: AI 不是来替代程序员的,是来帮程序员省时间的——前提是,你得会用。
关注我,持续更新实战踩坑指南。