ARTICLE · 979698
我做了一个 AI 写作工具,最后一直在收拾它的残局
我做了一个 AI 写作工具,最后一直在收拾它的残局
过去一个月,我在做「见字」(github.com/shiker1996/wechat-newsroom-workbench)这款 AI 写作工具时,花最多时间的不是让它多写几段,而是处理那些已经生成、却还不能交稿的东西。
文章生成了,标题却和正文对不上。社交卡片导出了 PNG,文字被背景吃掉一半。批次任务跑了很久,最后因为一条来源失败,只能从头再来。模型返回半截 JSON,系统还把它当成了完成。
如果你用过 AI 写文章,大概知道这种尴尬。最让人烦的不是模型偶尔写错,而是你不知道它错在哪里,也不知道应该从哪一步继续。那些问题单独看都不大,却会把一次本来应该顺畅的生产过程,变成不断返工。
所以,最近一个月「见字」的变化,不能只用“新增了多少功能”来解释。项目从 0.1.x 走到当前的 0.7.2,Git 里有 203 条提交,变更涉及 1,276 个文件。数字当然热闹,但我更在意的是:它开始从一个“能生成内容”的工具,变成一条需要对输入、判断和交付负责的生产流程。
01 /模型说完成了,读者却还看不懂
最早做社交卡片时,我想得很简单:把事实交给模型,让它规划故事板,再生成 HTML,最后截图。
代码确实可以这样跑通。问题是,截图生成出来,事情还没有结束。
有些页面内容太少,留下一大片空白;有些页面的容器高度不对,文字溢出去;有些主题的背景色和文字颜色撞在一起,文字还在,读者却看不见。只看 JSON 和 HTML,很难发现这些问题。浏览器打开以后,答案才比较诚实。
于是我们给社交卡片加了密度预算、稀疏页兜底、自适应容器和分阶段布局修复。后来发现,结构检查还是不够,又接入真实浏览器审计,检查页面是否溢出、文字是否可见。最近连文字可见性也被纳入硬门禁。
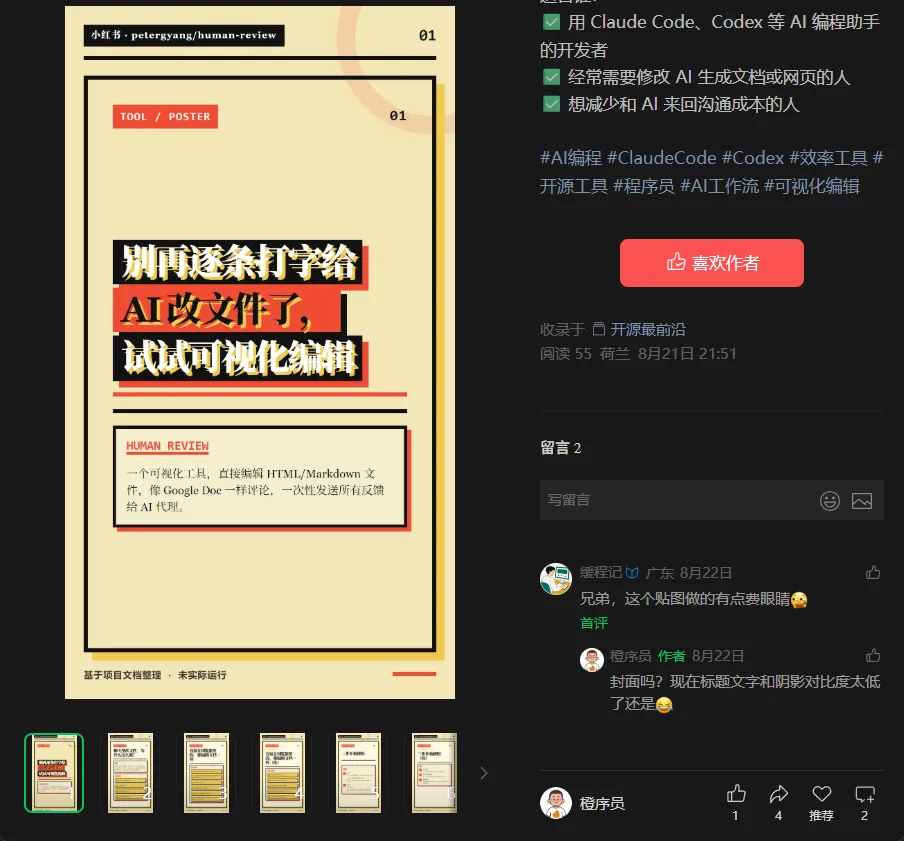
读者反馈也很直接:标题文字和阴影对比度太低了。看到这句话时,我没法再把问题归结为“审美偏好”。卡片确实看不清。
这件事让我有点泄气。我们本来想让 AI 帮忙做设计,最后却花了很多时间规定一个页面至少要有多少内容、哪些颜色不能放在一起、哪一页失败以后应该怎么改。
但这可能就是 AI 生成产品的日常。模型负责提出方案,系统负责检查它在现实里是否成立。
02 /封面不能每次都靠运气
公众号封面图也经历了类似的变化。
一开始,我们希望 AI 直接给出一张封面,但生成的图片AI味太重,即使使用GPT image也会元素太多看着太假。后来发现,模型更适合回答几个问题:标题怎么断行?哪些词需要强调?这篇文章适合哪套主题?信息应该放在哪里?
这些决定可以交给模型。但要想生成杂志风页面,画布、颜色、尺寸和截图,最好由确定性的代码完成。
现在的封面链路是:AI 生成排版规格,系统校验规格;如果标题被改写、字段不完整或布局不合法,就回退到预设方案。最后由模板渲染成 900×383 的图片:
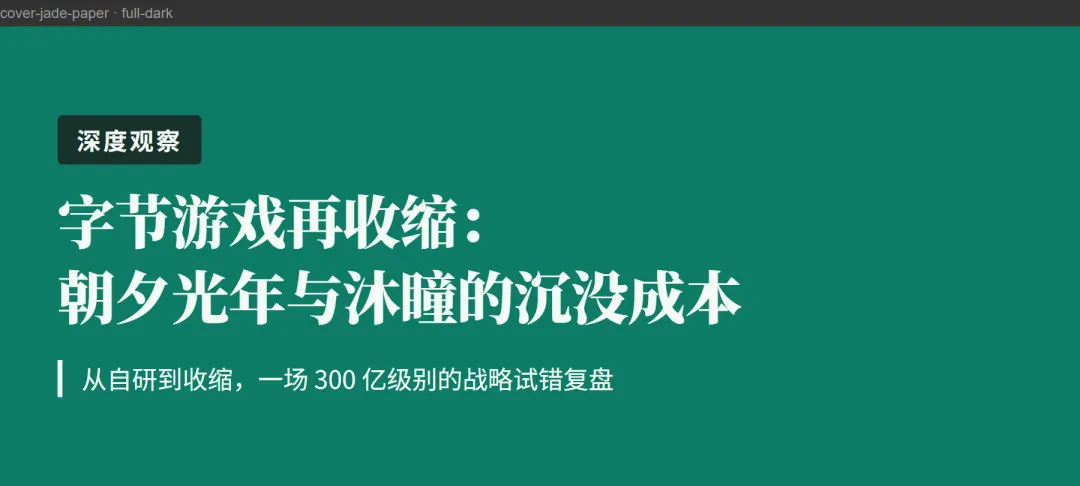
这听起来没有“AI 全自动设计”那么让人兴奋,却更接近实际使用。封面上的标题不能差一个字。模型可以帮忙断行,但不能替作者重新发明一个标题。
我以前把确定性代码理解成一种限制,后来觉得它更像保险。模型可以有创造力,发布物却不能每次都靠运气。
03 /失败以后,不要把人送回起点
另一个变化来自后台任务。
内容采集、热点打标、事件卡和文章生成,本来都可以看作一次任务。任务失败了,就报错;报错以后,用户再点一次。
这套逻辑在演示环境里没什么问题。真正跑一批数据时就不一样了。一批任务可能包含几十个来源,其中一个网站超时,不该让所有结果都作废;一个热点打标失败,也不值得把已经完成的部分全部重做。
所以项目后来开始记录失败对象,而不是只记录“这一批失败了”。哪个来源失败、哪个热点失败、失败原因是什么、能不能单独重试、是否允许跳过,都被保存下来。采集源、打标和事件卡可以分别重跑,成功后归档失败记录。
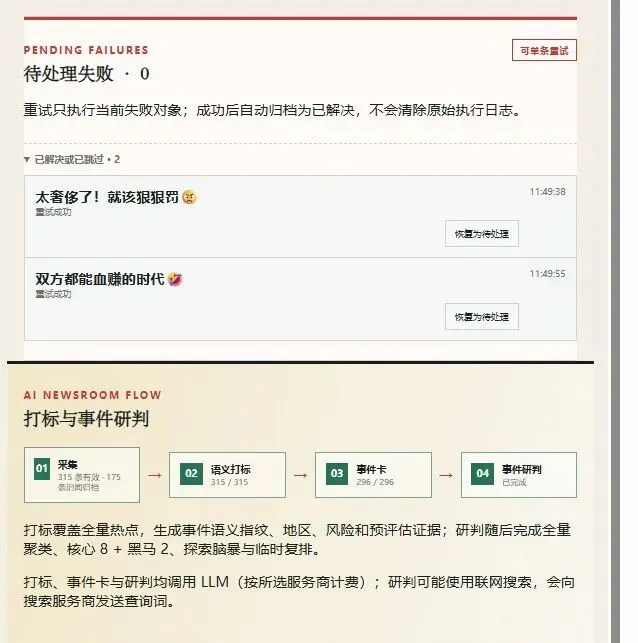
这类功能不太容易让人觉得惊艳。它没有增加一个漂亮的按钮,也没有让模型看起来更聪明。但它减少了最实际的返工:不用因为一条坏数据,把前面半小时的工作再做一次。
我现在对“系统永不出错”这件事没那么执着了。批量流程里总会有网络问题、模型问题和脏数据。更重要的是,出错以后,系统能不能把人带回正确的位置。
04 /信息越多,越要学会停下来
这一个月里,项目补了联网搜索、本地文档检索、来源原文抓取、AI 兴趣仓库发现,以及事件聚类和选题评分。
表面上看,这是在增加信息入口。入口越多,越要回答一个不太舒服的问题:这些材料值得写吗?
我们开始给候选保留来源证据、读者利益、内容支柱、账号匹配和风险信息,也把文章池、通知池和实验池区分开。编辑会里,作者可以补充链接,系统负责抓取并把结果放回事实基座。因为“有一个热点”和“值得为它写一篇文章”之间,本来就隔着判断。
AI 很擅长把东西继续往下生成。它不太擅长替你决定什么应该停下来。
05 /最后做的,还是边界
回头看,最近很多工作都在做边界:插件能调用什么,技能能使用什么能力,模型能修改哪些内容,失败后哪些步骤可以重试,哪些结果必须人工确认。
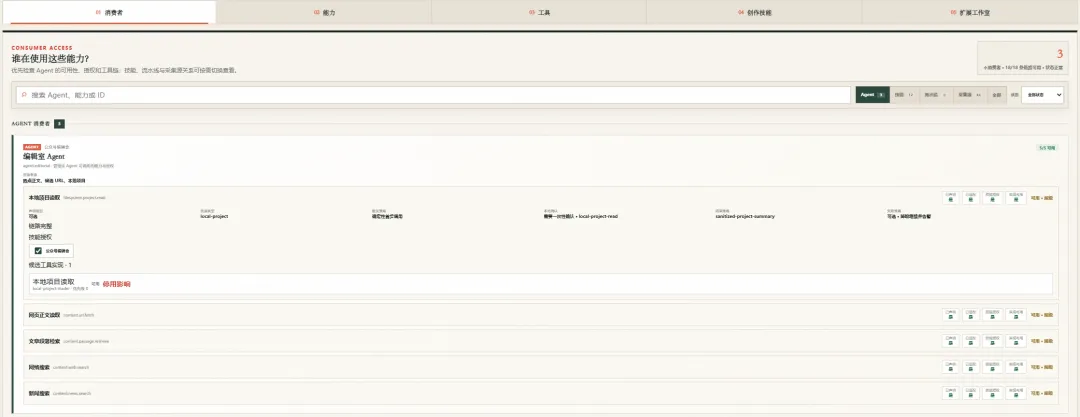
项目也因此增加了能力槽位、插件 Manifest、权限检查、执行审计和兼容性规则。它仍然是本地优先的单用户工作台,完整验证平台还是 Windows 10/11,也不是一个可以直接面向公众部署的 SaaS。
这些限制和门禁检测加上后,反而让我更放心。内容生产里最危险的不是工具有边界,而是工具没有边界,却让人误以为它什么都能负责。
我原本想做一个会写文章的工具。做着做着,发现真正要做的是一套不会轻易把人带沟里的流程:前面帮你找材料,中间逼你做判断,后面尽量把格式、布局和失败处理好。
它还不是一个自动编辑部。作者仍然要看事实,确认观点,也要对来源、版权和发布风险负责。下一阶段也未必是再加一个“智能按钮”,我更想知道的是:这些规则放进真实的内容生产里,能不能真的少让人返工几次。