ARTICLE · 984852
AI开始自己改进自己:腾讯混元Hy4,一个会调参的模型
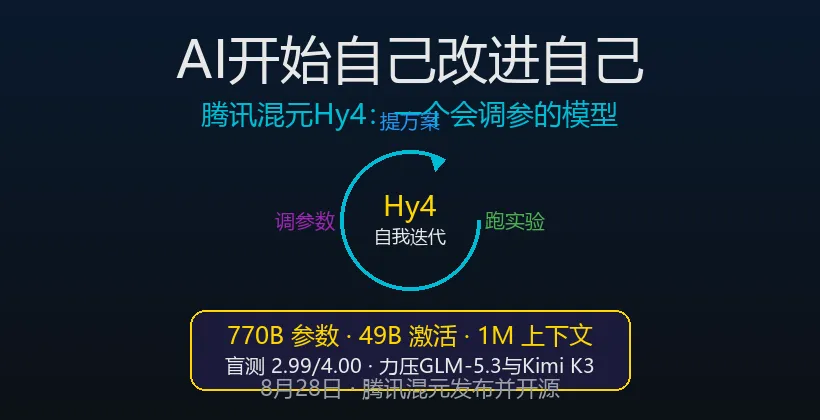
8月28日,腾讯混元发布了新一代大模型Hy4 preview,770B参数、1M上下文。但最值得说的不是参数,而是它干了一件以前模型没干过的事——参与了自身的研发优化。它自己提方案、自己跑实验、自己看结果、自己调下一轮参数。简单说,模型开始自己改进自己了。
先看硬指标:从"通用"到"干活"
Hy4 preview的参数规模相比上一代Hy3跳了一大步:
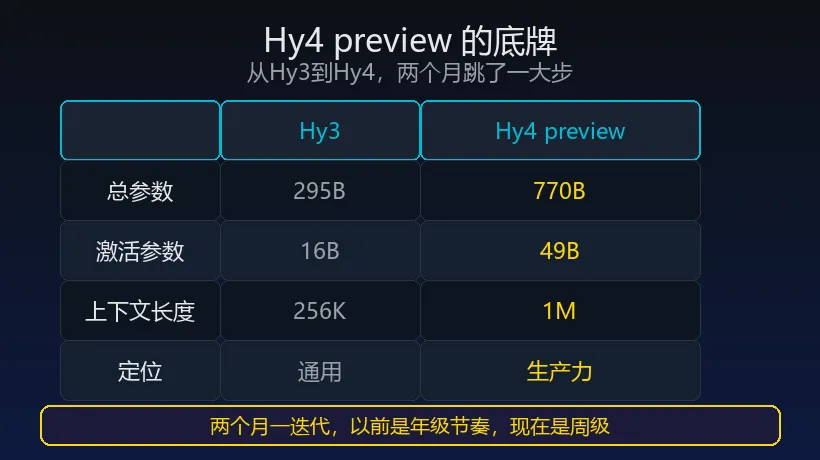
说实话,参数从295B涨到770B,上下文从256K拉到1M,这在今年不算稀奇。真正有意思的是定位变了——Hy3还是个"什么都能聊"的通用模型,Hy4 preview直接锁定了四个干活场景:写代码、做表格PPT、搞游戏开发、跑科学模拟。
说白了,不再比谁聊天更厉害,开始比谁干活更靠谱。
盲测成绩:2.99分,力压GLM-5.3和Kimi K3
腾讯内部组织了163名专家,对203个工程任务做盲测。规则很简单:专家不知道哪个回答来自哪个模型,打分满分4.00。
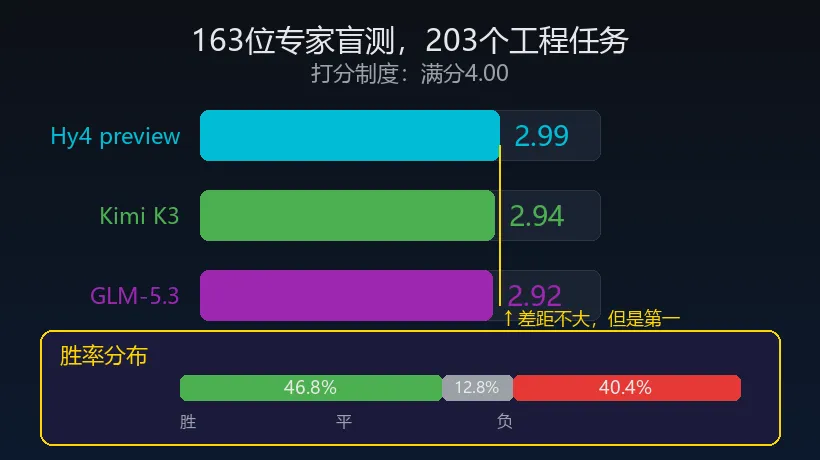
差距不大——0.05分和0.07分。但能排在第一,说明在真实工程任务上,Hy4 preview确实有东西。胜率分布是46.8%胜、12.8%平、40.4%负,不是碾压,但够稳。
更有意思的是科研上的突破:Hy4 preview配合Hyra模型,在三维Blaschke-Lebesgue这个百年几何难题上,把体积下界从0.380799推进到了0.41104,距离最终证明的Meissner四面体猜想只差约2%。在32512原子的磷脂双分子层模拟中实现了2.0倍提速,达到54.9ms/step。
这不是刷分,是真在解题。
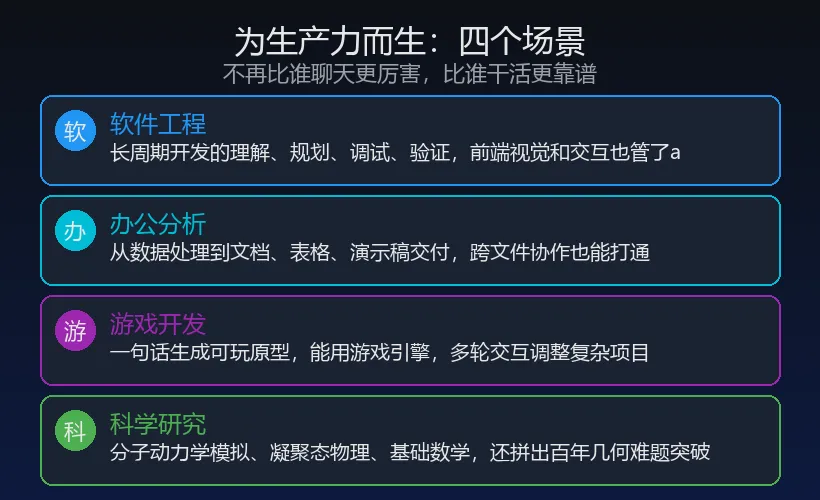
四个场景:不聊虚的,直接干
软件工程:从"写个函数"到"管一个项目"
以前的大模型擅长写单个函数、补几行代码。Hy4 preview强化的是长周期开发的理解、规划、调试和验证能力。也就是说,你给它一个比较大的开发任务,它能理解上下文、规划步骤、发现bug、自己验证结果。前端开发的视觉审美和交互质量也管了。
办公分析:从"帮我写段话"到"帮我交一份报告"
不是帮你润色一段文字就完了。Hy4 preview能从数据分析到文档、表格、演示文稿做完整交付,跨文件协作也能打通。复杂办公环境的理解和金融分析能力都有提升。
游戏开发:一句话出可玩原型
给一句话需求,直接生成可玩原型,能熟练使用游戏引擎(支持通过MCP接入Unreal5和团结引擎)。开发者可以通过多轮交互持续完善复杂游戏项目。
科学研究:真去解百年难题
分子动力学模拟、凝聚态物理、基础数学——这些不是营销话术,是Hy4 preview真正在跑的任务。前面说的百年几何难题突破就是在这里出的成果。
真正的新东西:模型自己调自己的参数
这部分是我觉得整件事最值得关注的地方。
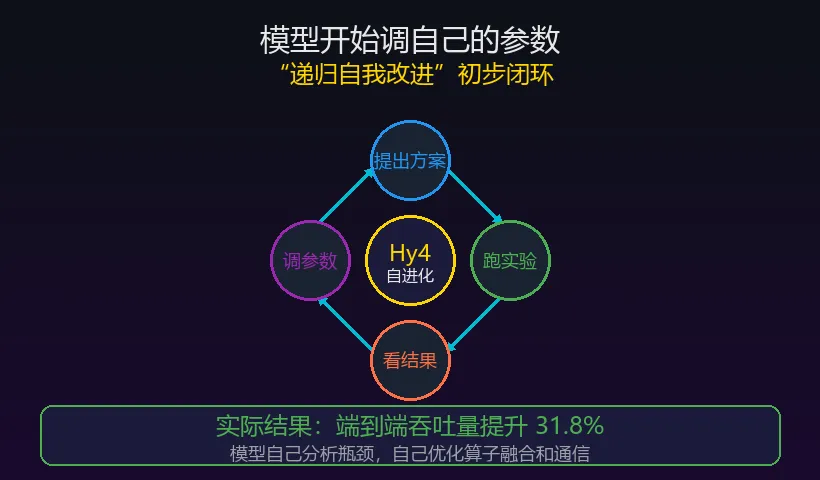
Hy4 preview首次参与了自身研发的全链路过程——训练方法、数据策略、评估体系、底层算子的自动优化。模型自己提出方案、自己运行实验、自己根据结果迭代。实验产生的代码、日志和反馈,进入下一轮探索。
翻译成人话:
以前调模型,是工程师定参数、跑训练、看指标、改参数。现在变成了模型自己提方案、自己跑实验、自己看结果、自己调下一轮参数。这个环转起来了,叫"递归自我改进闭环"。
不只是说说。Hy4 preview还自己分析了推理系统的瓶颈,围绕算子融合和通信优化做了多轮优化,端到端吞吐比基线提升了31.8%。在不同上下文长度和并发度下都稳定有效。
这是第一次有国产大模型在这个方向上跑出了可量化的结果。
老实讲,这个闭环还很初步。腾讯自己也说了,Hy4 preview只是Hy4的早期版本,预训练和后训练都有改进空间,复杂任务会想太久、过度自我验证。但方向对了——模型从"被调"变成"自己调",这件事的意义不在于今天提升了多少,而在于这个环一旦转起来,迭代速度会和以前完全不在一个量级。
定价和开源:不藏着掖着
Hy4 preview已经开源,HuggingFace、GitHub、ModelScope、Gitcode上都有。API定价:
同时,WorkBuddy和CodeBuddy开了两周免费体验。用户在元宝、ima等产品里也能直接用。从2月重建基础设施以来,混元平均每两个月迭代一次大版本。按这个节奏,Hy4的下一版也不远了。
这件事意味着什么
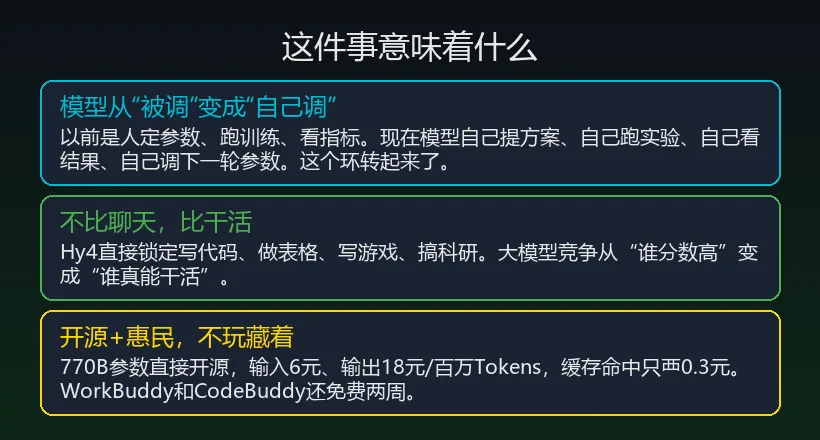
第一,模型从"被调"变成"自己调"。以前是工程师定参数、跑训练、看指标。现在模型自己提方案、跑实验、看结果、调下一轮参数。这个环转起来了。虽然还很初步,但方向对了。
第二,不比聊天比干活。Hy4直接锁定写代码、做表格、写游戏、搞科研四个场景。大模型竞争从"谁分数高"变成"谁真能干活"。盲测不是考聊天,是考203个工程任务。
第三,开源加惠民,不玩藏着掖着。770B参数直接开源,输入6元、输出18元/百万Tokens,缓存命中0.3元。WorkBuddy和CodeBuddy还免费两周。
从今年8月看,大模型的竞争已经不卷参数了。DeepSeek V4 Pro卷智能体能力,Qwen3.8卷全模态性价比,GLM-5.3卷代码效率,现在Hy4 preview卷的是自我迭代。
每家都在找一个不同的突破点。这比大家一起刷分有意思多了。
写在最后 以前说AI迭代快,是工程师迭代得快。现在开始变成AI自己迭代自己——虽然只是迈了第一步,但这一步踩下去,后面的路就不好说了。 大模型从"帮你干活"到"帮自己干活",可能就是这几个月的事。 |
图片来源:腾讯混元官方发布 / 人民网 / AIBase / 环球网