ARTICLE · 986673
10 秒 AI 视频,我花 120 元买了条教训:贵的工具不一定更好
一个 10 秒钟的视频,AI 跑了一整夜。
朋友找我帮忙:一张中国地图,几个人从不同城市出发,最后汇聚到同一个地方。需求很简单,10 秒以内。
我想都没想,直接丢给了手头最新、最贵的 AI 工具组合。
结果第二天才拿到成品。
第一次:等了两天两夜
当时我用的组合是 Claude Code(Anthropic 的 AI 编程助手)+ SuperPower(一个把多个 AI 工具串起来的自动化平台)+ GPT 5.6 Sol。
让它自己跑。结果跑了两个晚上,第三天拿到成品,出品质量很高,几乎一次成型(虽然后面我想微调一下,鉴于耗时太久放弃了),给大家看下效果。
但是你体会下:一个 10 秒钟的视频,AI 跑了 40 多个小时,这个时间成本未免也太大了。
所以我去看它到底在忙什么,发现问题主要有两个:
一是流程太长。 SuperPower 的工作流是一层套一层,中间还夹着多轮调用。我把架构图放出来,你就能看到它绕了多少圈。
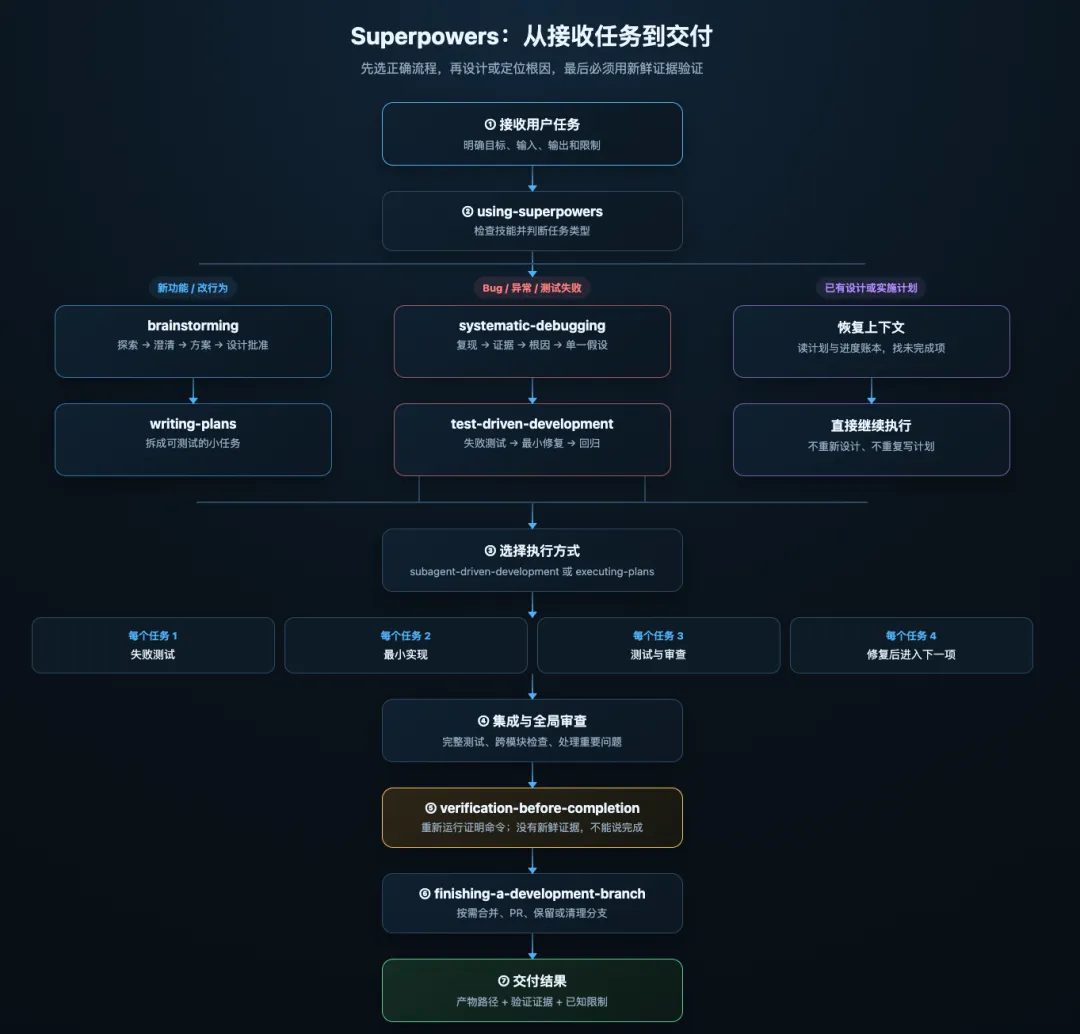
二是上下文爆了。 SuperPower 的工作流嵌套了好几层,每轮调用都要把工具返回、历史记录和推理过程塞进上下文。GPT-5.6 Sol 虽然标称有 100 多万的上下文窗口,但实际跑起来,三层嵌套一叠加,上下文还是爆了三次。爆一次就停一次,停了就得重新接上去继续跑。
说人话就是:AI 同时要记住的东西太多了。它要记着我的原始需求、每一层工具返回的结果、它自己每一步想了什么,再加上 SuperPower 一层套一层的工作流。这些东西堆在一起,AI 的"记事本"就写不下了,只能停下来清空,重新从头接上。所以中间反反复复爆了三次。
回头看,这次失败的根本原因不是 AI 不够强,而是我把高 reasoning 档位的重模型 + 嵌套工作流,用在了一个本可以轻量解决的 10 秒视频任务上。
就这样,反复折腾,第三天我早上才拿到第一版,也是最终版,实在是懒得让他改了。
第二次:换了个思路,2 小时搞定
后来我换了自己本地的 OpenClaw(我自己在用的本地 AI 工作流平台),用的是 DeepSeek V4 Flash(一个轻量、便宜的推理模型)。
它 5 分钟左右就出了第一版,调整了五版最终得到了我想要的效果。
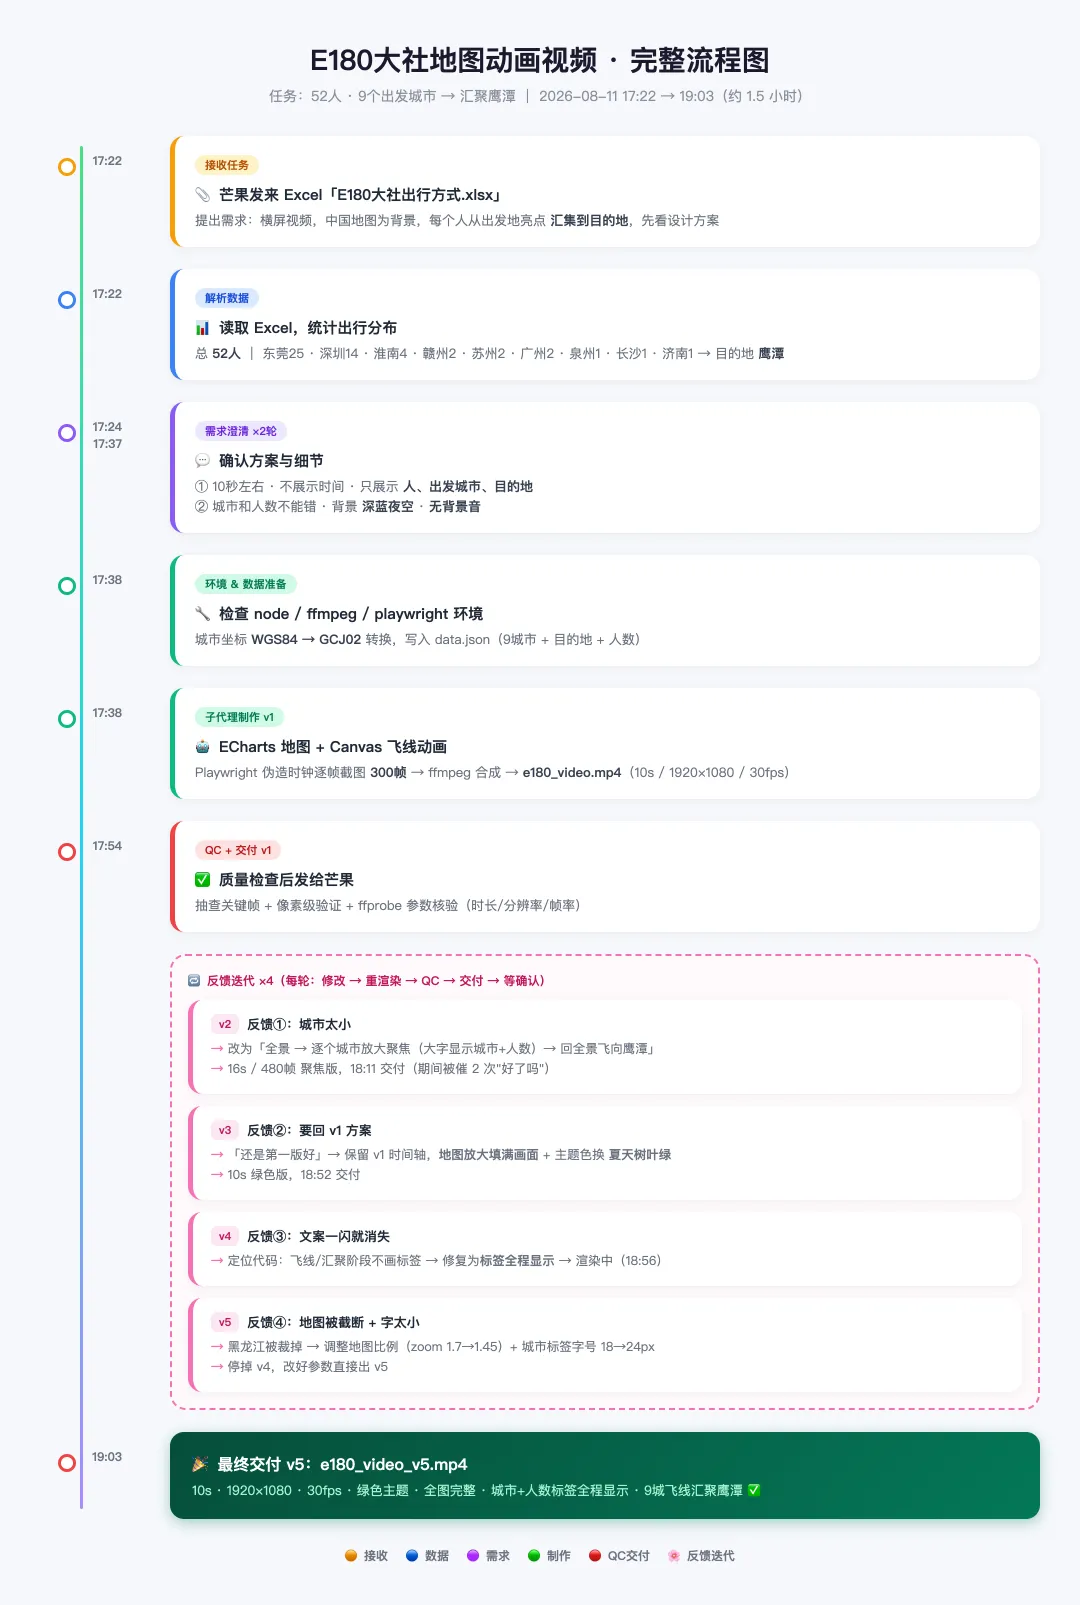
当然,前期也不是直接开干。它先跟我确认了需求,又做了规划设计,最后才出图。
前后一共改了 5 版,总共花了大概 2 个小时,拿到了最终结果。
以下是openclaw+DeepSeek V4 Flash工作的整体流程图
两者对比太明显了:
成品其实都 OK。但第一次那个,时间成本和钱都太高了。
这件事给我的三条教训
1. 工具不是越新越贵越好,匹配度才是第一优先级
同一个 10 秒视频,SuperPower + GPT 5.6 Sol 能跑一天一夜,DeepSeek V4 Flash 两小时就能交差。
贵的模型强在复杂推理和长程规划,但你的任务如果只是"生成一段 10 秒地图动画",它大概率在杀鸡用牛刀。
2. 复杂任务,先跑一版轻的 MVP
第二次不是一上来就堆资源,而是先用 DeepSeek V4 Flash 这种轻量模型跑出第一版,验证方向对了,再迭代。
轻量方案的好处是:便宜、快、错了也不心疼。方向确认之后,再决定要不要上重模型。
3. 给 AI 任务设一个止损时间
我现在给自己定了一条规则:
如果一个任务让 AI 跑了超过 2 小时还没结果,我就停下来重新跟它确认一遍。
确认三点:
1. 这个方案是不是最合适的?
2. 框架是不是太重了?
3. 能不能换一个更轻的模型或工具先跑一版?
别像我第一次那样,让 AI 闷头跑了 40 多个小时,最后才发现成本根本扛不住。
最后想说
现在 AI 工具更新得特别快,人人都想追最新、最贵的模型。但其实很多时候,选对工具比追新模型更重要。
花小钱、用对工具、早点拿到结果,比花大钱、等一天、还要不断修 bug 靠谱得多。
你最近用 AI 有没有遇到过「明明用了最贵的模型,结果反而更慢更糟」的事?欢迎评论区聊聊。
咱们一起少花钱、少熬夜。
— END —
卖芒果的杂货铺
AI时代的好东西,一件一件摆上货架
👆 关注我,不错过上新