ARTICLE · 988805
本地AI实测:Qwen3.8 Flash Next 老显卡从必崩到满速
先说结论
moe-l2 发新版本了(v0.7.0,GitHub 上是 bins-v0.7.0)。这版做了三件事:
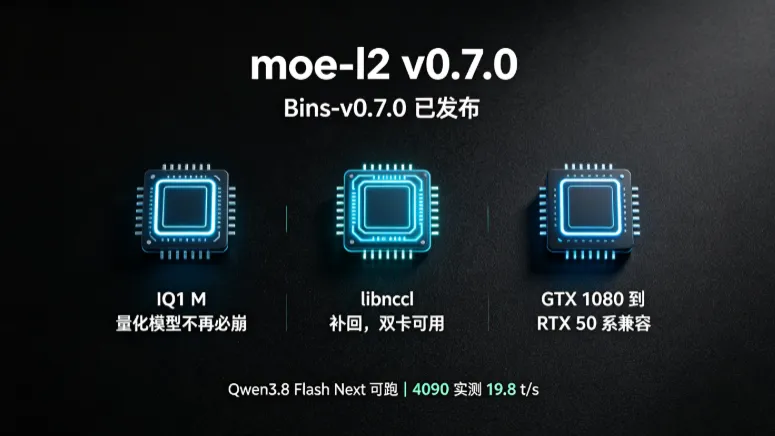
① 修了一个让新模型必崩的 bug——IQ1_M 量化模型(Qwen3.8 Flash Next,即 Qwen4exp 125B)之前一加载就崩,现在能跑了,4090 实测 19.8 t/s。(IQ1_M 是一种压得很狠的量化格式,文件小,但很多内核不支持它,属于"能省空间、不一定能跑"的类型。)
② 把多显卡支持加回来了。之前发的包把 libnccl 弄丢了,双卡用不了;这版补上,双卡跑 74.5G 大模型的路重新通了。
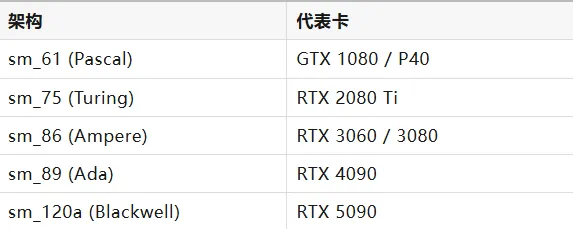
③ 保持全系列 N 卡兼容。一个二进制覆盖 GTX 1080(sm_61)到 RTX 50 系(sm_120a),不用按卡编译。
这个 bug 是怎么发现的
8 月底 Qwen 出了 Qwen3.8 Flash Next(125B,MoE,512 专家/层,文件里叫 Qwen4exp),用了很小众的 IQ1_M 量化。很多人(包括评论区的 Mason)都在问"这个能不能跑"。
我拿到手一跑——直接崩。llama.cpp 的 MMQ 内核不支持 IQ1_M 这种量化格式,加载阶段就 GGML_ABORT(核心转储)。(MMQ 是 GPU 上算矩阵乘法的内核路径,可以理解为"GPU 干活的那套程序",不是所有格式它都认识。)
排查过程比较硬核,简单说就是:
新模型崩了先查"量化类型支持",再查"维度假设"——我一开始以为是 512 专家/层这种大维度的问题,实际是 IQ1_M 在 MMQ 内核里根本没实现 用 gdb 抓崩溃现场: SIGABRT(断言失败)而不是SIGSEGV(越界)——这个信号就指明了方向:不是内存问题,是"这个格式我根本不支持"修复方案:IQ1_M 改走 MMVQ 内核(它支持 IQ1_M)+ 大 batch 拆块循环
改完 4090 实测:
三模型 × 3 轮全跑完,输出全部正常,0 崩溃。cache 命中 97.3%(32768 槽)。
有意思的是:顺手把 Qwen3.6 和 DS 也带快了——多架构重编(CUDA 12.8)本身有性能红利,之前 2080 Ti 上就验证过一次(12.25 vs 7.88 t/s,+55%)。
多显卡支持加回来了
之前 v0.6.x 的包少了 libnccl.so.2,导致 --split-mode layer/row/tensor 多卡模式用不了——双卡用户(比如评论区那双 V100 的梁先生)只能看着。
这版重新编译时把 NCCL 支持打开,libnccl.so.2 打包进去。双卡显存聚合跑更大模型的路重新通了——比如双 16G 卡跑 74.5G 的 Qwen3.8 Flash Next。
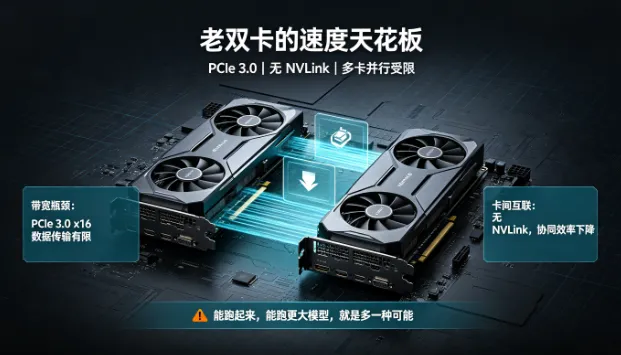
说句实在话:多卡并行受 PCIe 带宽和卡间互联限制,老双卡(PCIe 3.0、无 NVLink)跑不出新平台的速度,天花板客观存在。但"能跑起来、能跑更大模型"这一条,对洋垃圾党来说就是多一种可能。
顺带说明:老显卡(P100 这类)的情况
评论区有人提了 P100(Tesla 老专业卡,sm_60 架构)。说实话,这个架构目前还没适配——现在包里覆盖的是 sm_61 起步(GTX 1080 那一代)。P100 是 sm_60,cubin 不通用,直接跑会报 no kernel image。
适配本身不难:编译时架构列表加一个 60 就行。下个版本计划里排着,你要是手头有 P100 或者洋垃圾服务器,可以先关注,等适配包出来直接换。
老显卡兼容范围
一个二进制,全系列 N 卡通用:
编译配置:CUDA 12.8 + AVX2(不需要 AVX512,老 CPU 放心)+ GGML_BACKEND_DL=ON。
⚠️ 三条限制,先说清楚:
CUDA 12 运行时要求 NVIDIA 驱动 ≥ 570,驱动太老的先升级 P100(sm_60 专业卡)暂未适配,下版本计划里排着 Windows/WSL2 实机验证还没补,等 3060 环境跑完再更新
怎么升级
pip install -U moe-l2# 升级到 0.11.0moe-l2 download-bins# 拉取 bins-v0.7.0(1.7GB,自动)moe-l2 start --model model.gguf --gpu
PyPI 版本 0.11.0,GitHub release bins-v0.7.0,moe-l2 download-bins 自动指向新包。
一点实话
这次发版的验证环境是 2080 Ti + 4090(双机实测),老卡(比如 3060)和 Windows/WSL2 的实机验证还没补。按我之前的规矩,发版前应该把目标机都跑一遍,这次时间紧直接发了——如果你手头正好有 3060 或者 Windows 环境,跑完有问题欢迎来 issue 或者评论区说一声,我每条都看。
下个版本计划里排着:老显卡(P100 这类 sm_60 专业卡)适配、WebUI 管理界面、原生 Windows 程序。评论区的需求我都记着。
评论区聊聊:你手上是什么显卡?跑过最重的模型是哪个?
↑ 关注我,每周更新本地 AI 实操,只写跑通了、省了钱的。