ARTICLE · 989052
用 AI 审 GMP 文档是什么体验?我做了个本地小工具,还接上了自己的知识库
QA 这个岗位有个挺折磨人的日常,审偏差调查报告。手边堆着 GMP 附录、公司几百份 SOP、还有一堆历史案例,时限还卡在那儿。得逐条核对根因分析有没有挖到底、CAPA 能不能落地验证、数据完整性有没有踩 ALCOA+ 的红线,最后还得在 Word 里留下能追溯的审阅意见。
这活儿真干过才知道累。翻标准翻到手酸是小事,最怕的是条款跟文档对不上,批注写了一堆,回头自己也说不清依据在哪儿。
后来我做了个小工具,叫 DK QMS。文档解析、AI 审核、批注导出全在浏览器里完成,AI 审的时候会去检索一个挂在本机的知识库来取证,不是凭记忆瞎说。这篇就把它的架构、用法,还有一段实测样例都讲一讲。
它到底能干什么
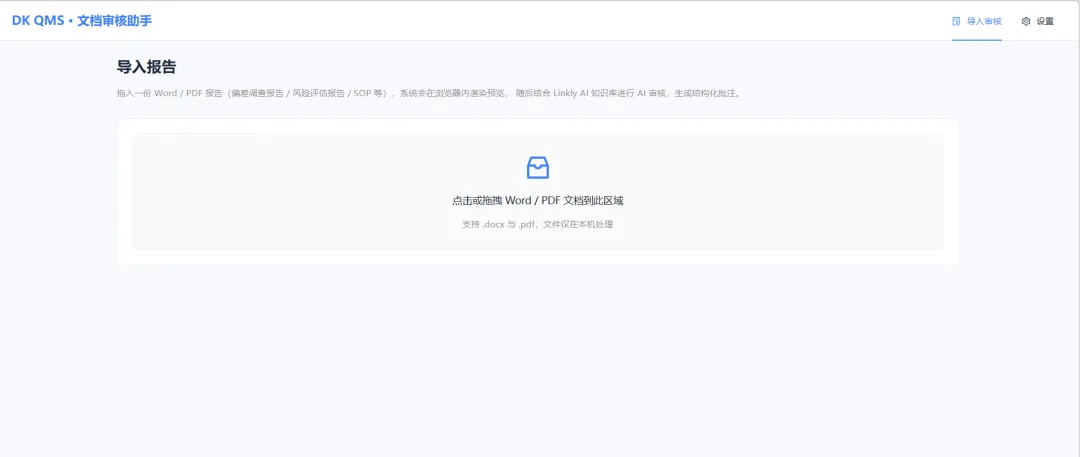
DK QMS 是个制药合规审计工具,QMS 就是质量管理体系的意思,名字起得比较大,因为想做的是一套更大的合规审计体系,现在这个是第一版demo,先从文档审核切入。导入一份 Word 或 PDF 报告,AI 结合知识库自动审阅,最后导出一份带原生批注的新文档。偏差调查报告、风险评估报告、SOP 都能审,只审内容不动版式。
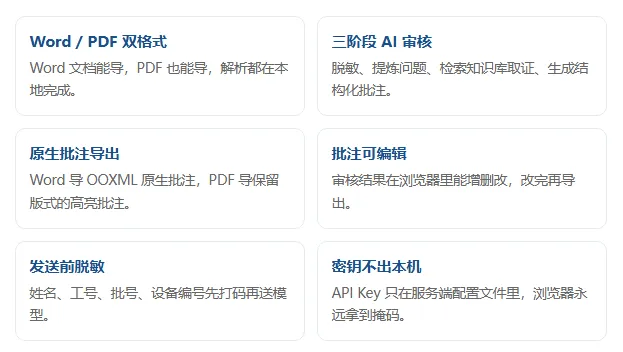
整个处理都在浏览器里跑,数据不出本机,密钥留在服务端,这几条对制药场景来说都是硬要求。
功能架构:纯静态 SPA + 极简代理
架构上我尽量做减法。前端是个纯静态 SPA,解析、审校、导出全在浏览器里;服务端就一个极简 Node 代理,干两件事,转发 LLM 调用、转发知识库检索,顺带托管页面。
为啥这么分?实测下来,模型 API 是支持浏览器跨域直连的,但本机知识库的 MCP 接口不带 CORS 头,浏览器直接就被拦住了。所以知识库这一路必须走代理,LLM 就一起走了,顺带把密钥留在服务端,浏览器永远拿不到明文。
关于本地模型多说几句:文章里出现的 DeepSeek 只是我们做样例测试时临时接的外部模型,演示用的,不代表生产建议。真要在企业里部署,建议接本机的开源模型,比如 Ollama 或者 LM Studio 跑一个。换成本地模型之后,模型、知识库、文档全程都在企业内网,文本不出内网,数据丢失、泄露这些事从根上就不存在。按这个场景的审核量,本地模型的效果完全够用。
图 1 · DK QMS 功能架构:浏览器 SPA + 极简转发代理 + 本地知识库(Linkly AI 搭建)
灵魂:自己攒的本地知识库
这工具最关键的,其实是挂了一个本地知识库。这些内容是我自己攒的,一千多份 GMP 法规标准,加上三千多份从网上收集的 SOP 文档,整理成一个本地知识库,再用 Linkly AI 这个工具搭建起来,通过 MCP 接口暴露检索能力。DK QMS 审核的时候,会真的去知识库里检索对应标准,把条款和原文片段当批注的依据。
你想想看,批注里每条「依据」背后都有一条能查到的检索结果,不是模型脑补的。对制药这种要求批注有出处的行业,这点挺要命。
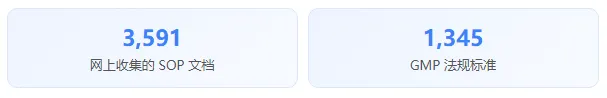
本地知识库的索引规模(list_libraries 实时返回),内容是自己收集的 GMP 法规标准与 SOP 文档。
知识库的范围也不是写死的,启动时自动调 list_libraries 发现可用的库,按库渲染启用开关,勾哪个审哪个。换了知识库内容,界面跟着变,不用动代码。
三阶段审核流程
点「开始 AI 审核」就自动跑,每一步都有进度反馈:
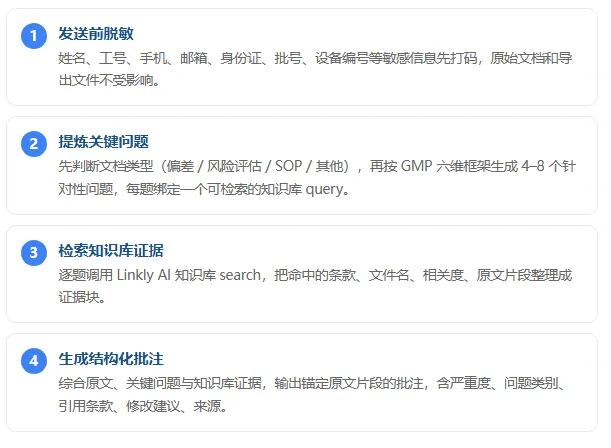
图 2 · 三阶段审核流程(脱敏 → 问题 → 取证 → 批注 → 导出)
审核维度内置了一套 GMP 审核框架,偏差管理、CAPA、风险评估(ICH Q9)、数据完整性(ALCOA+)、文件管理 / SOP、合规与可追溯六个方向。
越用越聪明的经验教训库
还有个我觉得挺重要的点,审核的内容是可以积累的。企业自己的历史偏差报告、批过的风险评估、通过审核的 SOP,都能持续加进知识库。今天审的每份文档、每条被验证有效的批注,都会变成明天的审核依据。
这个积累我做成了一份 Markdown 文件,每次审核完自动把本次的问题和批注追加进去,下次审核新文档的时候先读一遍作为参考。你也可以在文件里手动加自己的审批要求,下次就生效。积累多了,AI 能参考的条款越来越全,提的问题也会更贴企业的实际情况。说人话,这工具会越用越懂你。
双格式原生批注导出
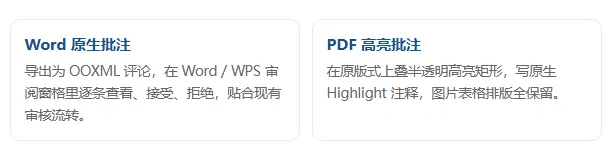
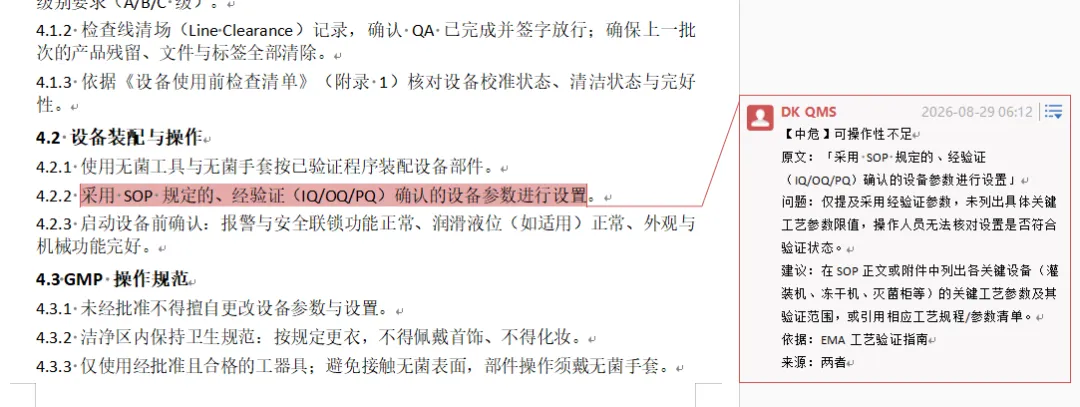
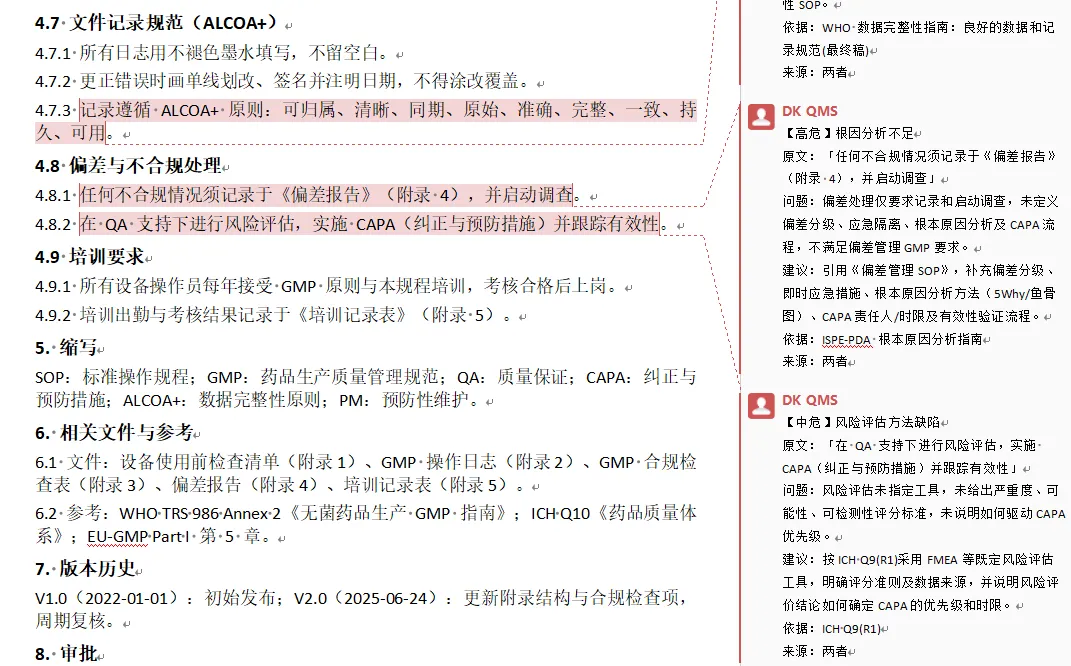
审核结果不是一段评语就完事,是可以写回原文档的原生批注。
隐私与安全设计
制药文档敏感,这块我做了几道防护。文档全程本地处理,不上传任何云端;API Key 只存在服务端配置文件,浏览器拿到的永远是掩码;发给模型和知识库的文本先脱敏,姓名、工号、批号、设备编号自动打码;要是接的是本机模型,从原文档到导出文件全程不出企业内网,连出网请求都没有。
脱敏这层单独说说,它等于在本机处理和模型调用之间又隔了一道。就算文档留在本机,送出去的文本也已经打码了,原始文件保持完整,只有模型和知识库看到的是脱敏后的。
开发时还踩过一个坑,AI 把「设备操作员」「生产主管」这类职位名误判成 [姓名] 占位符,追查了半天才发现是脱敏规则把职位词后面的汉字当姓名打码了,修掉之后就正常了。这类细节,就是工具和通用 AI 问答的区别。
样例实战:无菌注射剂车间机器操作 SOP
光说没用,我拿《无菌注射剂生产车间机器操作 SOP》实测了一遍。结构很标准的 GMP 设备操作 SOP,目的、范围、职责、操作程序、记录规范、培训要求都齐。
说明一下,这份 SOP 是从网上下载的公开资料整理的示例,不是任何企业的真实文件,仅用于功能演示。
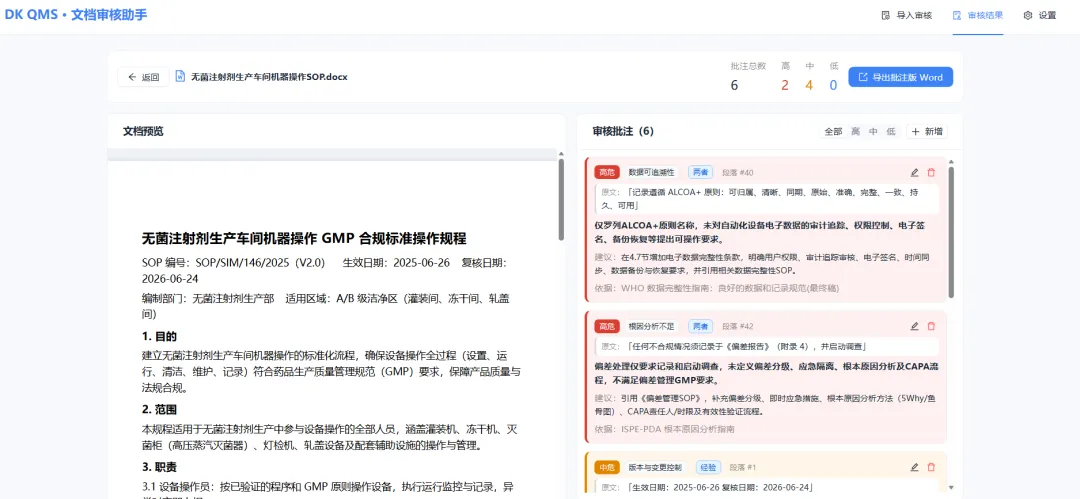
导入点开始审核,AI 先按 GMP 框架提炼问题,再逐题检索 Linkly 知识库取证,最后生成锚定原文的批注。下图是审核结果页的样子,左边文档高亮预览,右边按严重度排的批注列表。
无菌注射剂生产车间机器操作SOP · 审核结果
WORD批注
使用方法
本地单机部署,没有登录、没有云依赖,几条命令就能跑起来。前提是本机装好 Node.js 20+,并且本地知识库的 Linkly AI 服务在跑。
# 1. 获取代码并安装依赖git clone https://github.com/dreamke/DK-QMS.gitcd DK-QMSnpm install# 2. 准备配置(填入模型 API Key 与知识库地址)cp data/config.example.json data/config.json# 编辑 data/config.json,填入模型 BaseURL / API Key / 模型名# 3. 构建前端并启动npm run buildnpm start# 浏览器打开 http://localhost:8787
想省事就用开发模式,一条 npm run dev 同时起前端和代理,前端在 5173,代理在 8787。第一次进先到「设置」填模型 API 和知识库地址,点「列举知识库」验证连通,就能开始导文档了。
配置模型时提醒一句,企业内网部署建议把 Base URL 指向本地模型(Ollama 或 LM Studio),别用外网 API。示例里的 DeepSeek 只是演示。
相关地址
▶ https://github.com/dreamke/DK-QMS
GitHub 开源仓库:源码、README、配置模板
小提示:仓库里只放配置模板,不含任何 API Key 和真实地址,克隆后自己填。文档全程在本机处理,密钥只在服务端配置文件里。
做完这个工具,我自己的感受是,AI 在制药这种行业里不是来替人的,是把人从翻标准里解放出来。文档最后还是人审,但 AI 先把证据链摆齐,人只做判断。
要是你也天天跟 GMP 文档较劲,建议在本地跑起来试试,文档、密钥、审核过程都在自己手里。有问题也欢迎去仓库提,多一个趁手的工具总不是坏事。
以上,既然看到这里了,如果觉得不错,随手点个赞、在看、转发三连吧。谢谢你看我的文章,我们,下次再见。