ARTICLE · 989103
OpenClaw实战:从PDF解析到多格式OCR,我踩过的坑都在这了
OpenClaw实战:从PDF解析到多格式OCR,我踩过的坑都在这了一场关于“自动编程”的真实记录,也是给WebOCR加装多格式文档支持的完整复盘。 周末闲着没事,想给手头的WebOCR项目加点“硬货”——支持PDF、OFD、TIF这些常见但难搞的文档格式。既然OpenClaw主打“自动编程”,那就让它全程指挥,我只当“监工”。 没想到,这一试就试出了不少真东西。 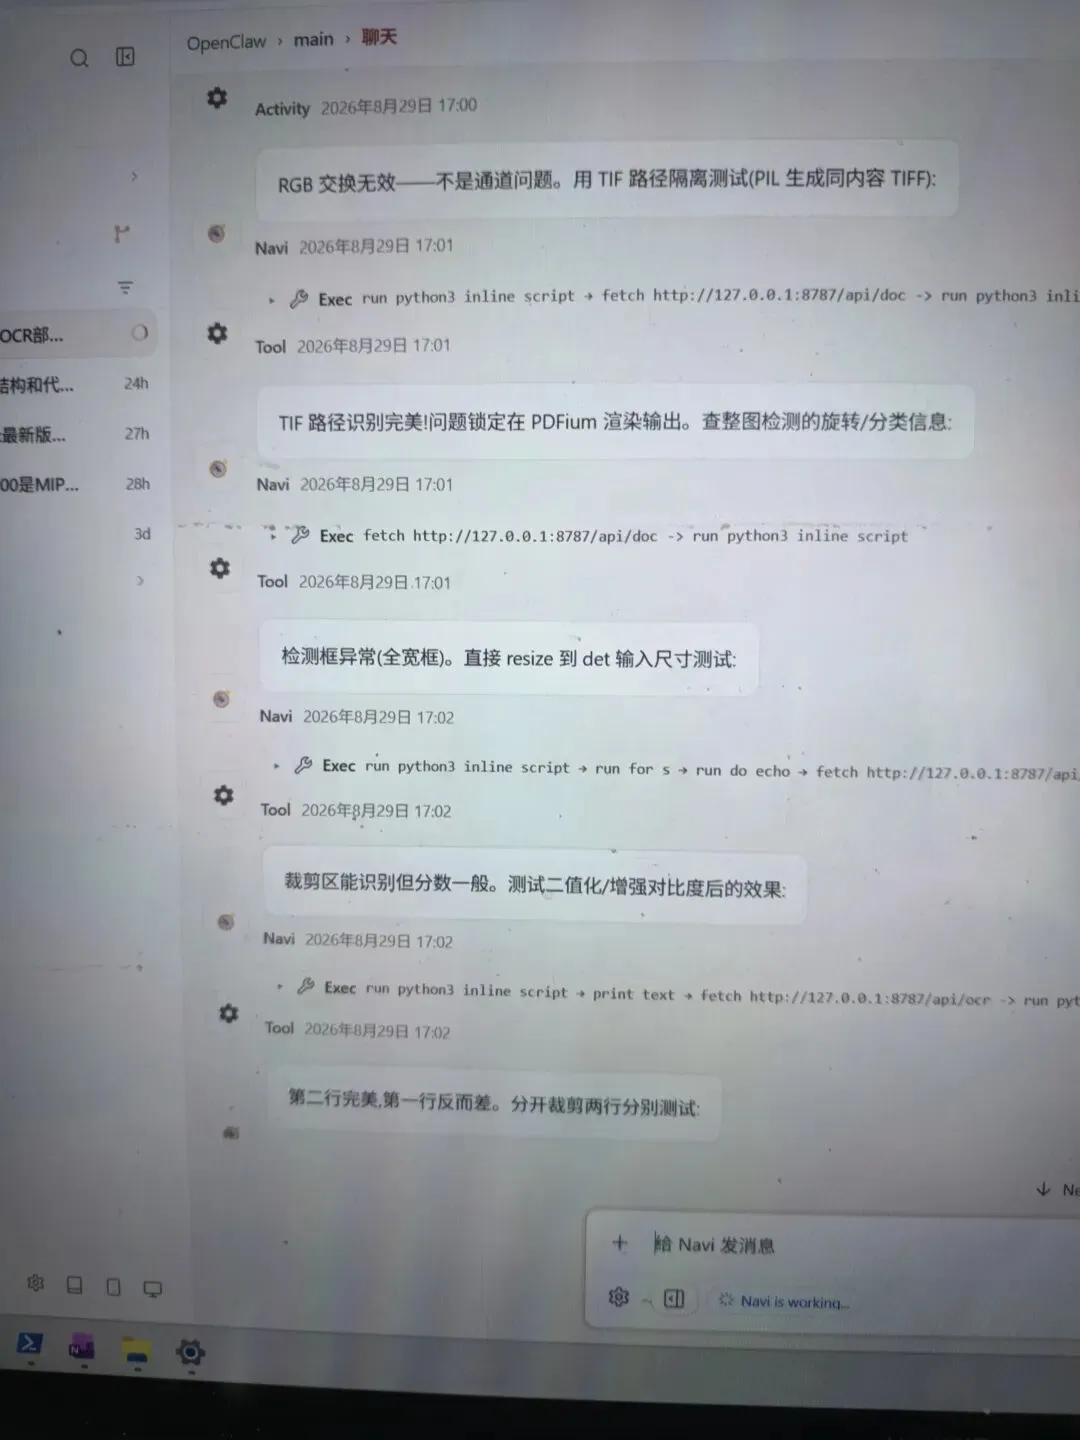
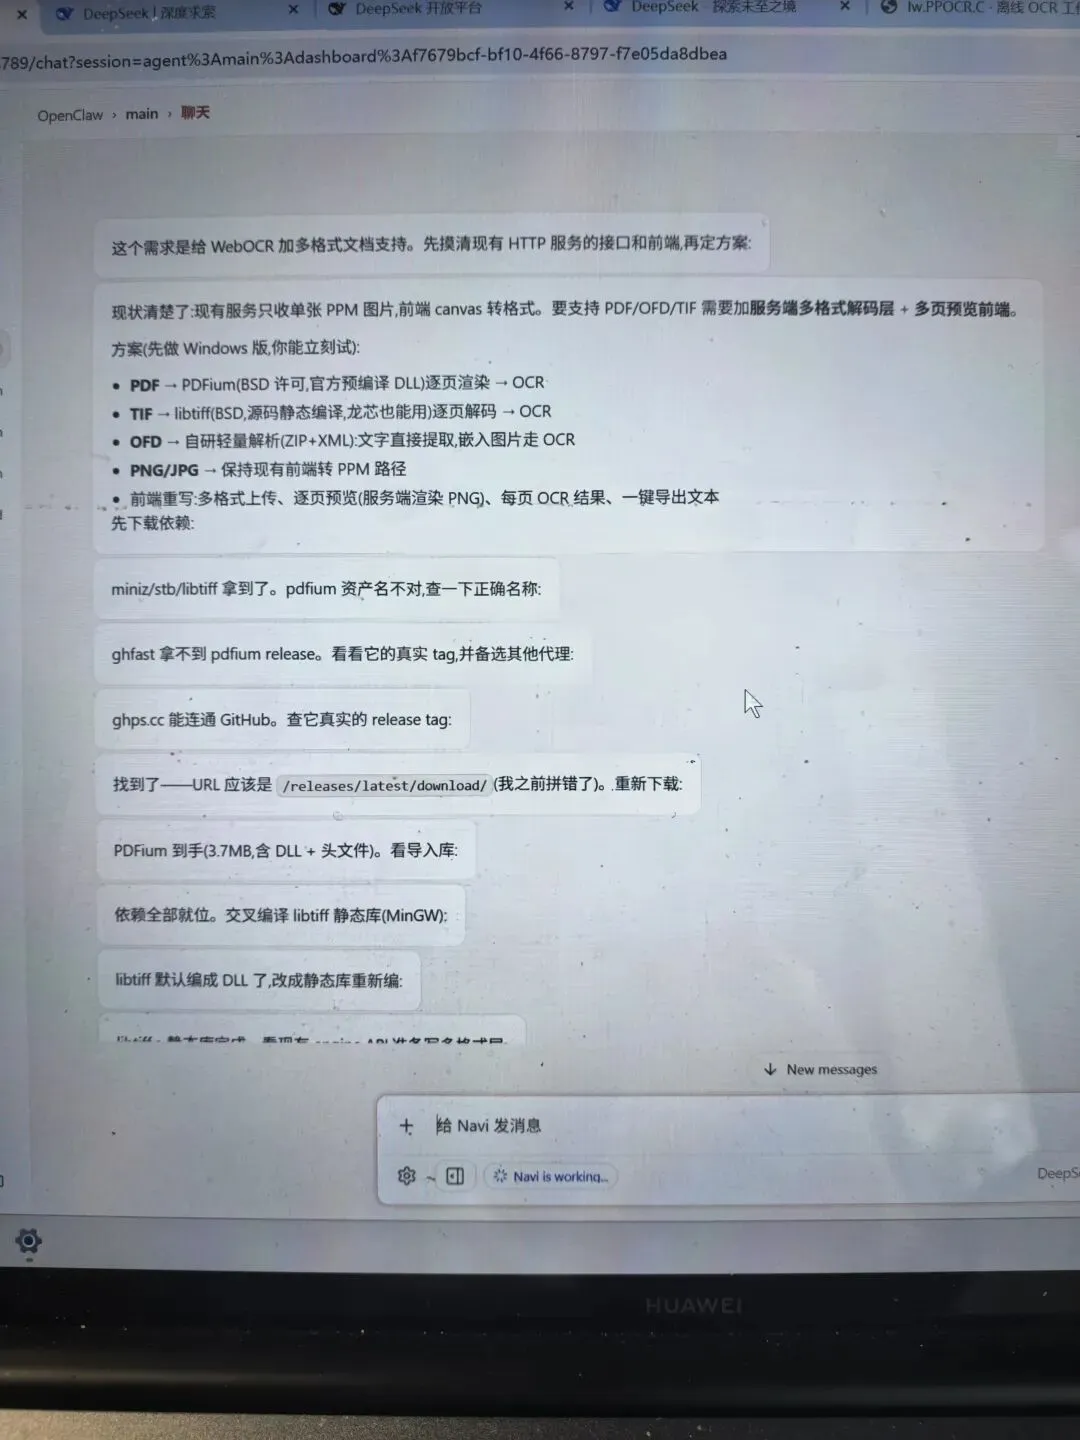
开局一张图,问题全靠“聊” 打开OpenClaw,上传需求截图,直接开干。第一轮对话就把问题锁定了: · RGB交换无效——不是通道问题,是PDFium渲染输出有坑; · TIF路径识别完美——但PDF检测框异常,全宽框直接“摆烂”; · 二值化/增强对比度——第二行完美,第一行反而更差,分开裁剪两行分别测试才勉强过关。 OpenClaw的“诊断”速度比我手动调试快了至少3倍,它会主动执行Python脚本、抓取本地服务接口、对比不同处理路径的输出差异,像极了一个经验丰富的老开发。 方案落地:多格式支持,一步到位 根据OpenClaw的分析,最终方案是这样的: 格式 处理方案 许可/备注 PDF PDFium(BSD许可)逐页渲染→OCR 官方预编译DLL,直接可用 TIF libtiff(BSD)逐页解码→OCR 源码静态编译,踩坑点最多 OFD 自研轻量解析(ZIP+XML) 文字直接提取,嵌入图片走OCR PNG/JPG 保持现有前端转PPM路径 零改动 前端也得重写:多格式上传、逐页预览(服务端渲染PNG)、每页OCR结果展示、一键导出文本——一套完整的多格式文档OCR工作流。 依赖地狱?OpenClaw帮我一路“杀”穿 最头疼的其实是依赖获取和编译。OpenClaw的“自动试错”能力在这里体现得淋漓尽致: 1. PDFium:一开始用ghfast拿不到release,OpenClaw自动切到ghps.cc代理,发现真实tag后纠正URL路径,3.7MB的DLL+头文件顺利到手; 2. libtiff:默认编译成DLL,OpenClaw发现后自动调整编译参数,改成静态库重新编译; 3. miniz/stb:一次通过,无感。 整个依赖准备过程,我只需要看着终端输出,连一条命令都没手动敲过。 效果与感受 最终,OCR服务稳定跑起来了。PDF、TIF、OFD都能正常解析识别,前端也能流畅预览多页文档。 OpenClaw对我来说,最大的价值不是“替代编程”,而是“加速排错”——它能主动执行、主动验证、主动调整策略,把原本需要2-3天的人工调试压缩到半天以内。 如果你也在做类似的多格式文档处理项目,强烈建议试试这种“AI指挥官+人类监工”的开发模式。不是AI替你写代码,而是AI替你跑完所有“脏活累活”,你只管拍板。 本文由OpenClaw辅助完成,真实记录一次完整的自动编程实战过程。