ARTICLE · 989106
AI一天能写100版,谁来审?药企该重做“内容放行系统”
内容生产突然变快了,很多团队却没有真的变快。相反,医学、法务与合规审阅(业内常称MLR review)的队列越来越长:同一个核心信息被改写成十几个版本,每个版本都要找依据、核适应症、查限定语;临时热点刚追上,审批窗口已经过去;为了赶时间,一线又开始绕回旧课件和私下改图。
IQVIA在2026年7月关于“从自动化到监督”的文章中提出,AI加速内容创作与个性化后,药企面临的新问题是:审阅流程能否在不牺牲合规的情况下跟上。这个判断值得中国药企重视。
AI时代真正稀缺的,可能不再是内容产能,而是可信内容的放行产能。
一、原来的审批流程,是为“一套课件”设计的
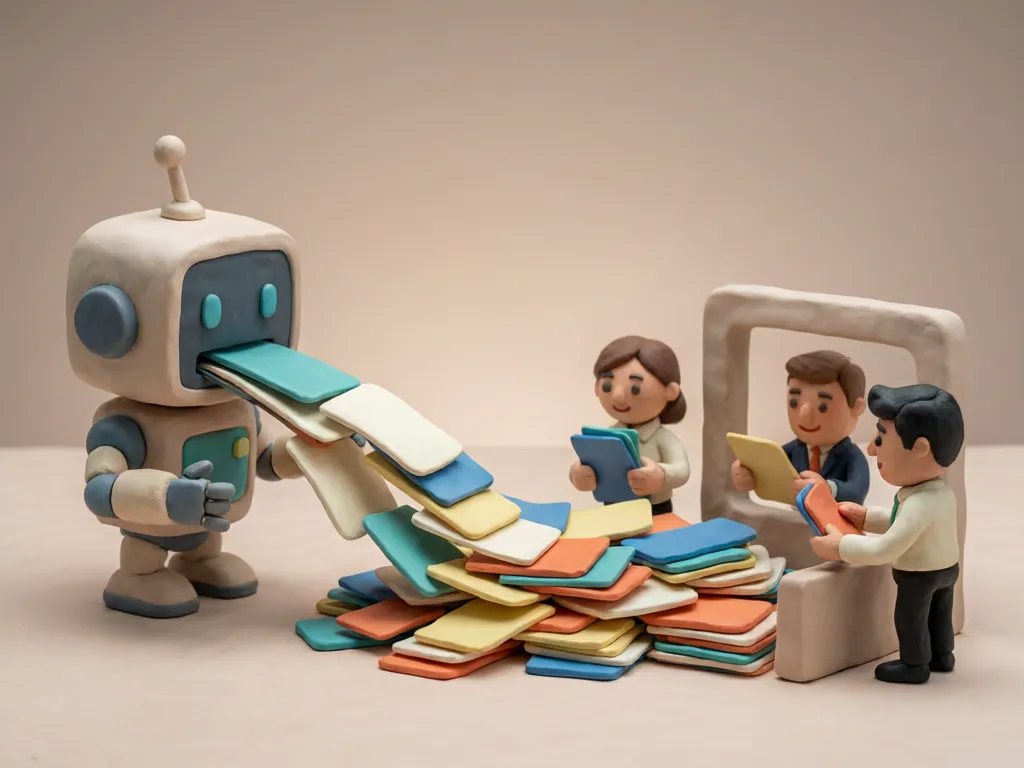
很多企业的内容流程仍然是串行的:市场部提需求,代理公司出稿,医学部核科学性,法务看表述,合规看场景,品牌团队再改视觉;任何一处修改,都可能把文件送回上一轮。
这套流程在内容数量有限时尚可运行。可AI把“一份材料”变成了一个版本族:长文可以变成短文、会前预习、会后摘要、拜访卡片、患者问答和线上直播脚本;同一句信息还会因为医生层级、疾病阶段和渠道限制而出现不同表达。
如果仍把每个版本都当成一份全新的孤立文件,审阅量会按版本数增长。团队看到的是“AI节省了写作时间”,审批端感受到的却是“待办翻倍”。
更麻烦的是,版本越多,差异越隐蔽。一个限定词被删掉,一项研究结果从特定人群被改写成普遍结论,一段患者教育文案无意间滑向疗效承诺,都可能发生在看似微小的自动改写里。
所以,问题不只是增加几个审阅人员,而是原来的流程单位错了:过去审的是文件,未来更应该审“可复用的医学主张、证据和使用条件”。
二、先建“获批主张库”,再让AI做组合
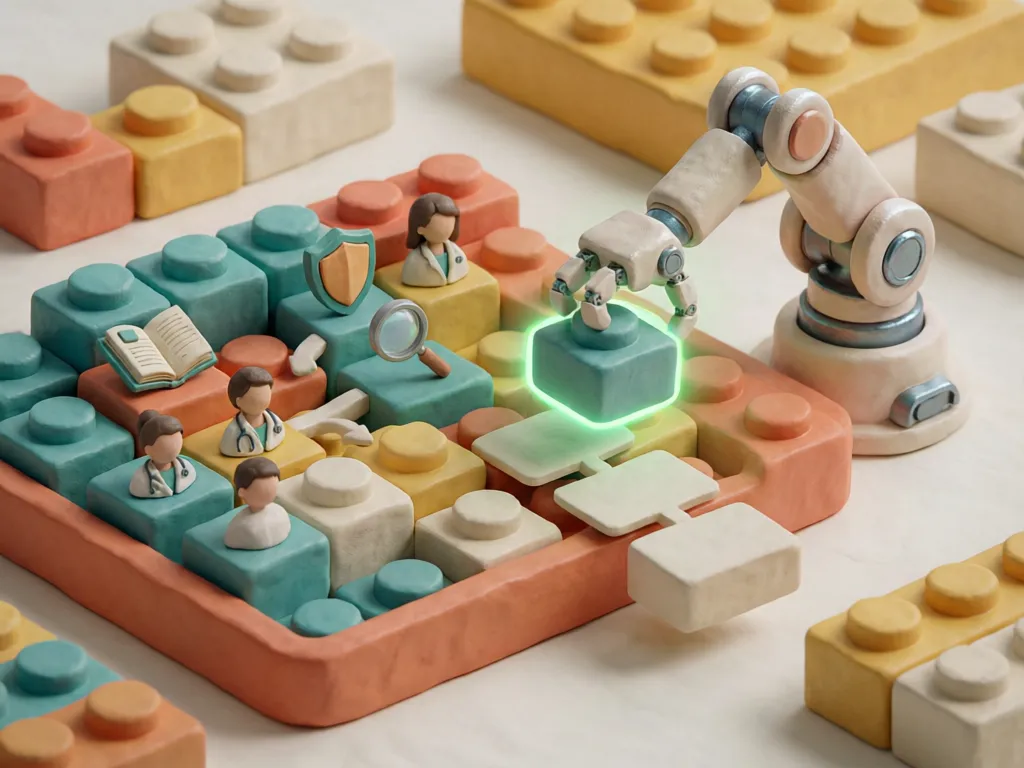
药企常说要建内容中台,但不少中台本质上只是文件仓库:里面有成千上万份PDF和PPT,却很难回答三个问题——这句话依据哪一页?允许用于什么受众和渠道?什么时候需要重新审阅?
更实用的底座应当是“获批主张库”。每条主张至少绑定六类信息:
标准表述,以及不能省略的限定语; 对应文献、说明书或权威指南的具体位置; 适用的产品、适应症、人群与疾病阶段; 可使用的受众、渠道和材料类型; 批准时间、失效时间与责任人; 禁止搭配的表达、图形或比较方式。
这会把审阅从“每次从头读一遍”变成“确认用了哪些已批模块、改动在哪里、是否触发新的风险”。对医学团队而言,时间可以从机械核对转向真正需要判断的地方。
三、不是所有修改,都该排同一条队
今天不少企业的MLR流程有一个效率陷阱:一张把横版改成竖版的图片,与一篇加入新研究结论的文章,可能进入相近的审批链路。结果是低风险修改挤占专家时间,高风险内容又无法获得足够审阅。
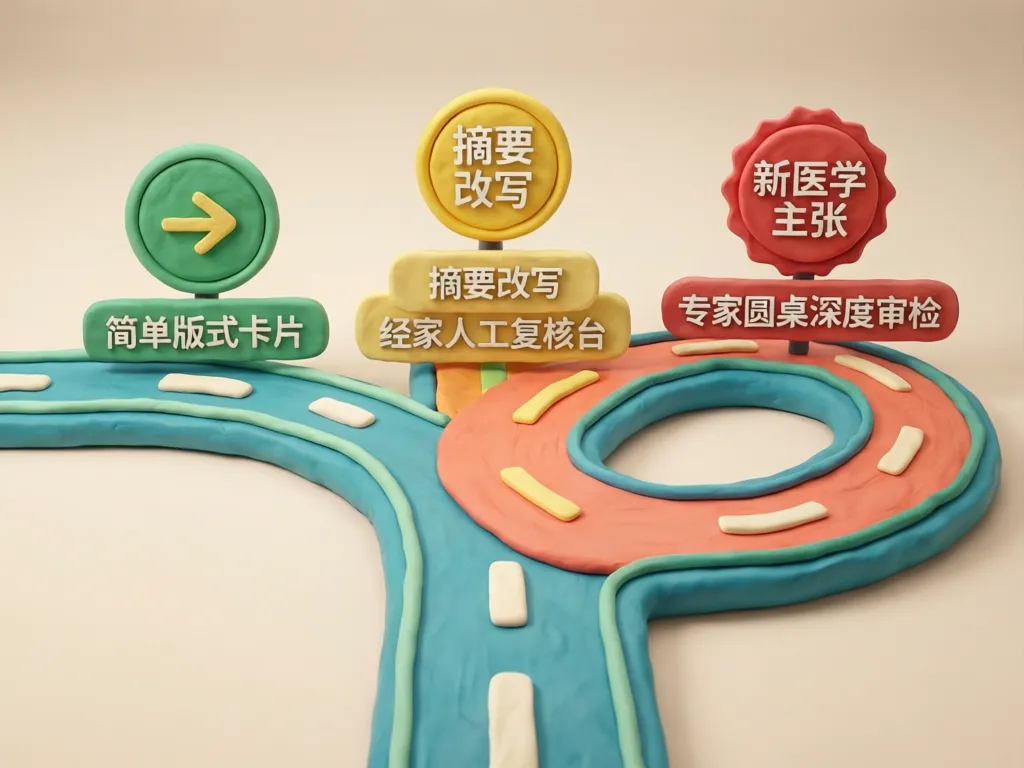
更合理的做法是按“变化风险”分流。
绿色通道可以包括:使用已批准文本、未改变含义的版式调整、到期前的同渠道复用。系统自动比对差异,完成必要的品牌和渠道检查。
黄色通道可以包括:摘要压缩、受众切换、患者语言改写、图表重绘。AI先标出删除的限定语、数字和比较关系,再由对应专业角色复核。
红色通道则包括:新增疗效或安全性主张、超说明书讨论、竞品比较、新数据发布、涉及个体化治疗建议的表述。这类内容不能因为“AI生成得很像”就走快速审批,必须回到完整的医学、法务与合规判断。
风险分流不是降低标准,而是把有限注意力放到真正可能改变医学含义和合规边界的修改上。
四、让AI先做“机械检查”,人来承担判断责任
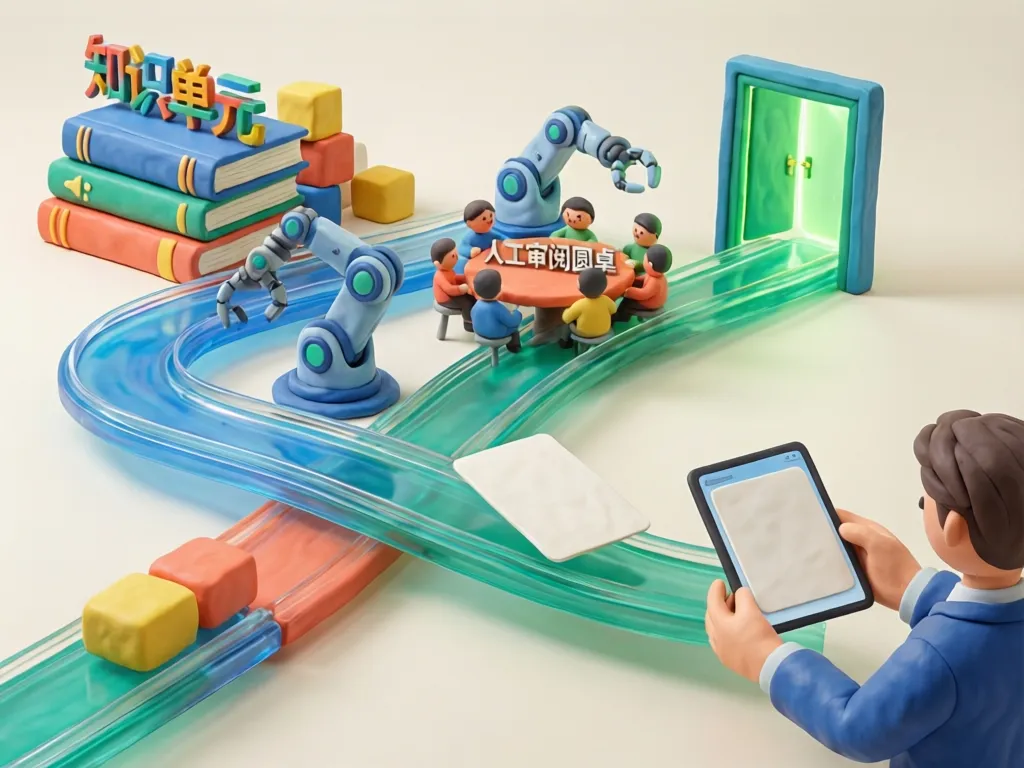
AI适合承担的,是高频、规则明确、可回看的检查:
第一,做版本差异比对,提示新增、删除和改写了哪些医学表述;第二,检查引用是否存在、数字是否与来源一致、限定语是否保留;第三,识别绝对化用语、未经批准比较、潜在超适应症表达和面向患者的不当承诺;第四,检查图片中是否出现未经批准的药品名、品牌名或错误文字;第五,为每次修改生成清晰的变更摘要。
但AI不能成为最终批准人。它可能把语义相近误判为医学等价,也可能没有理解一个词在特定治疗领域里的风险。最终责任仍应落在具备授权的医学、法务、合规和药物警戒角色上。
因此,系统设计不能只追求“自动通过率”,更要记录:模型依据了什么规则、引用了哪个版本、谁复核了哪一处、最终为何放行。AI的价值不是制造一个黑箱式的“合规分数”,而是让人更快看见真正需要判断的差异。
五、内容团队的KPI,也该从“产量”换成“可用率”
AI最容易制造的假繁荣,是内容数量迅速上升。一个月产出300条,不代表一线更容易找到合适材料,也不代表医生愿意看。
新的内容运营看板至少应关注四组指标:
首次通过率。 反映需求定义和主张调用是否准确,而不是鼓励审阅者少提意见。
批准周期与等待时间。 区分内容实际处理时间和在不同角色队列中的停留时间,才能找到真正瓶颈。
复用率与使用率。 哪些获批主张被多个渠道安全复用,哪些内容批准后从未被一线调用。
到期与撤回响应。 当说明书、指南或安全信息变化时,能否迅速定位受影响的所有版本并停止使用。
对市场部和代理公司而言,这意味着能力重心从“多写几版”转向“把需求定义清楚、正确调用证据模块、减少无意义变体”。对医学部而言,也不再只是最后把关,而要前置参与主张库与规则设计。
六、可以从一个治疗领域、三类内容开始
重做内容放行系统,不必先采购一个庞大平台。企业可以先选一个内容量大、更新频繁的治疗领域,做90天试点。
第一阶段,盘点近一年高频使用的主张与来源,清理过期、重复和互相冲突的版本;第二阶段,给主张加上适应症、受众、渠道、有效期和限制条件;第三阶段,只选择三类高频材料,例如代表拜访卡、会后摘要和患者教育页,建立绿色、黄色、红色分流规则;第四阶段,让AI生成差异报告和引用核对结果,但保留人工最终批准;第五阶段,比较试点前后的首次通过率、平均等待时间、返工次数和实际使用率。
这个试点的目标不是证明AI能替代多少人,而是验证一件更重要的事:企业能否在内容增多的同时,让每一条对外信息仍然可解释、可定位、可及时更新。
结语:快,不是多生成;快是少返工
生成式AI已经把内容生产的门槛降得很低。接下来拉开药企差距的,不是谁能一键写出100个版本,而是谁能把可信的医学信息,以合适的形式,在合适的时间送到合适的人手里。
这需要的不是更大的“内容工厂”,而是一套新的内容供应链:主张有来源,版本有关系,修改有分级,审批有责任,过期能召回。
当这些底层能力建立起来,AI才能真正帮助市场、医学和合规团队提效。否则,写得越快,排队越长;版本越多,风险越难看见。
药企下一轮要扩的,不只是内容产能,而是可信内容的放行产能。
本文为“医药学术营销观察”,仅供行业观察与内容策划参考;涉及医学、法规与合规事项,请以官方文件、批准资料及企业内部审查要求为准。