ARTICLE · 991941
AI 时代,普通人最该建立的不是软件,而是自己的数据库
AI 时代的个人长期主义
AI 时代,普通人最该建立的
不是软件,而是自己的数据库
真正能带走的,不是某个工具,而是关于自己的长期数据
个人经历、关系与决策汇入同一个可迁移的数据底座。
每一轮 AI 热潮都会让人焦虑:是不是该学提示词、学编程、学知识库,尽快做出一个最好用的软件?这些东西当然有价值。但对普通人来说,还有一件更基础、也更值得长期投入的事:把关于自己的高质量信息保存下来。
模型会更新,软件会消失,平台会更换。真正难以替代的,是你的经历、能力、处境、关系和判断历史。它们如果长期积累下来,就会成为任何一代 AI 都可以使用的个人数据资产。
你不一定要拥有最强的软件,但你可以拥有一套最了解自己的数据底座。
一、真正稀缺的,不是 AI 的知识,而是它对你的了解
今天的通用 AI 知道很多世界知识,却天然不知道你是谁。它不知道你做过哪些项目、真正擅长什么,也不知道你此刻受到哪些时间、家庭、财务和身份条件的限制。
比如你问:“我要不要转去新能源行业?”没有个人背景时,AI 只能给出行业前景、岗位类型和风险提示。答案可能没错,却很难真正替你缩短决策。
如果它知道你做过电力电子项目,不能接受长期出差,可以承受半年收入波动;还知道你的同学在设备厂、前同事认识储能公司的技术负责人,并且你过去曾因只看风口、忽略岗位匹配而做错过一次选择,同一个问题就会得到完全不同的分析。
通用 AI 给出的是世界的平均答案;个人上下文,才能把平均答案变成你的答案。
二、个人数据库,至少应该包括三个方面
1. 关于你自己
这里不只是年龄、学历和简历,还包括你的能力、偏好、资源、现实约束、当前目标,以及这些东西如何变化。真正有价值的往往不是一个静态结论,而是变化轨迹:你以前如何看待某个职业,现在为什么改变;你以为自己擅长什么,后来哪些经历证明或推翻了它。
2. 关于你周围的人
普通通讯录只记录姓名和电话。关系数据库还应记录:你们如何认识、共同做过什么、对方擅长什么、最近一次互动是什么、你答应过什么、下一次联系有什么自然理由。
它的价值不是把人当成资源,而是帮助你记住关系、兑现承诺,也让 AI 看见你容易忽略的间接连接。也许某位同学不在目标行业,但他的供应商恰好与目标公司合作;某位两年未联系的前同事,可能认识正在做相关项目的人。
3. 关于发生过的事和做过的决定
一段经历真正能够被复用,需要留下完整链条:发生了什么,当时掌握了什么信息,有哪些选项,为什么这样判断,结果如何,后来怎么看。
如果只记录“做了什么”,AI 无法学习你的判断。如果把理由、置信度和结果一起保存,时间就会慢慢形成一套只属于你的决策数据集。你会看见自己在哪些情况下判断准确,又在哪些情况下容易被情绪、惯性或外界意见带偏。
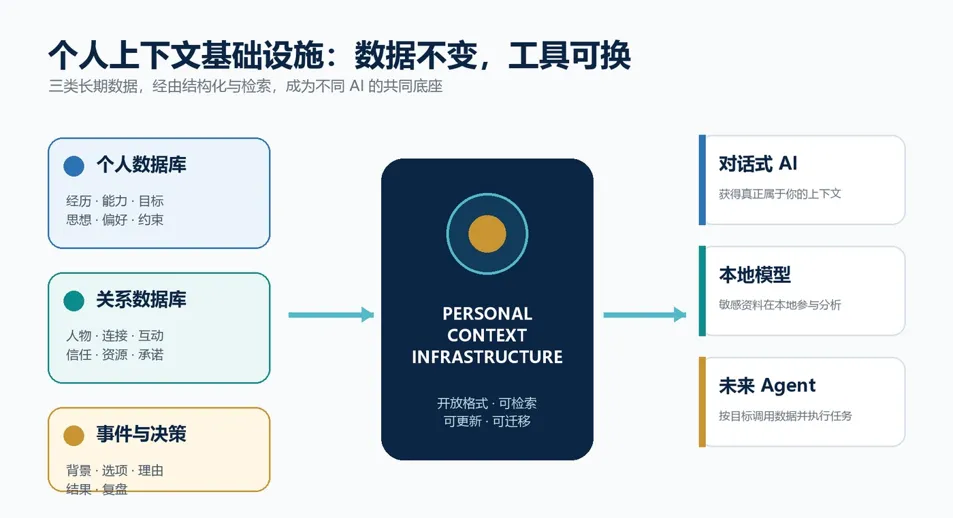
三类长期数据共同构成个人上下文基础设施。
三、这套数据最重要的价值,是可以迁移
如果你的记忆只存在某个平台的聊天记录里,它并不完全属于你。平台可能改版,检索方式可能受限,账号也可能迁移。更稳妥的做法,是把重要信息保存在自己掌控的开放文件中,把 AI 当作读取和分析这些资料的工具。
今天可以交给 ChatGPT 整理,明天可以让 Claude 阅读;对隐私要求更高时,可以交给本地模型;未来的 Agent 也可以根据目标主动检索这些资料。上层工具不断变化,底层关于你的数据保持稳定。
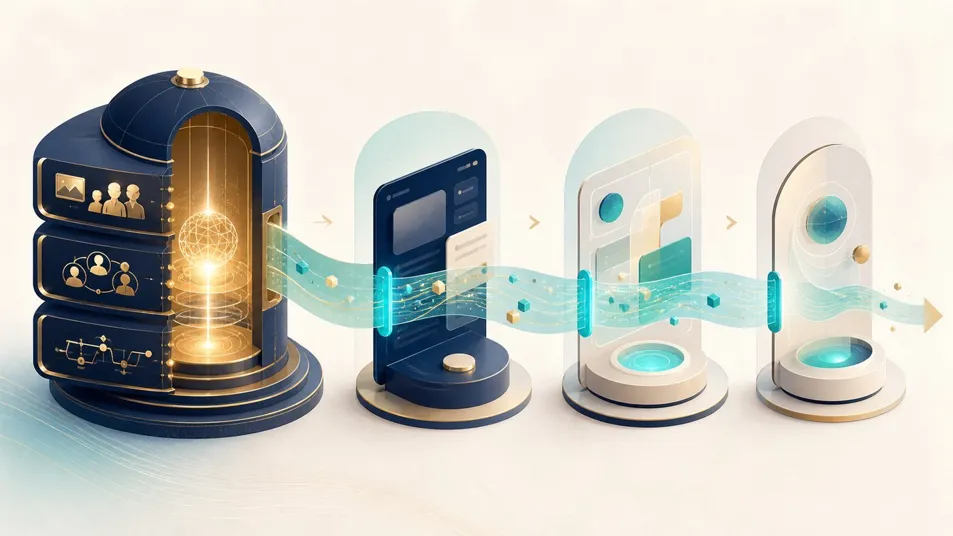
工具不断更新,个人数据核心保持稳定并持续迁移。
模型是消耗品,个人上下文是资产。前者越换越快,后者越积累越值钱。
所谓可迁移,不等于一开始就要建立复杂系统。几个普通文件夹、一些 Markdown 或 Word 文件,就足以开始。重要的不是数据库技术有多先进,而是内容是否持续产生、是否可信、是否方便更新。
四、不要先做一套系统,先让它完成一次真实工作
最容易失败的方式,是一开始就想把整个人生都整理完。更好的起点,是选一个此刻真正需要解决的问题,让这套数据先完成一次工作。
例如,你正在考虑职业方向,就只准备三份材料:一页个人情况,写目标、能力和现实约束;一页相关人物,写可能提供信息的人和你们的关系;一页决策记录,写目前的选项、依据,以及过去类似选择的结果。
然后把这三份材料交给 AI,请它比较不同路径、指出缺少的信息,并提出下一步最值得验证的问题。你不必先建数据库,也不必先学技术。只要这次分析确实帮助你看清了一个问题,你就已经得到第一份成果。
一个最小的起步动作
1. 选一个当前真实问题,例如职业选择、项目复盘或重要关系维护。
2. 只整理与这个问题有关的个人、关系和决策信息。
3. 让 AI 做一次分析,并请它明确指出还缺哪些上下文。
4. 把缺口补回文件中,留下这次判断及以后回看的日期。
做完一次,你会知道什么信息真正有用;再做第二次,结构自然会出现。个人数据库不是先设计出来的,而是在一次次真实使用中长出来的。
结语:未来的分水岭,可能是谁拥有更好的“自己”
AI 会越来越强,也会越来越便宜。当模型能力逐渐普及时,人与人之间的差别,未必主要来自谁更会操作某个软件,而可能来自谁拥有更完整、更可信、更能被机器理解的个人上下文。
一个人如果能够持续记录自己的经历,更新对能力的认识,维护重要关系,保存决策的理由与结果,他就在建设一种很少被看见、却会不断复利的资产。它让过去不只是回忆,让关系不只是通讯录,也让每一代新的 AI 都不必从零开始认识你。
最强的个人 AI,不一定来自最强的软件;它更可能来自最了解你的数据底座。