ARTICLE · 993892
AI漫剧如何解决长剧本、角色一致性与视频质量问题?
AI漫剧如何解决长剧本、角色一致性与视频质量问题?之前的文章,我们聊了AI漫剧工具如何从0到1搭建,从剧本上传 → 资产管理 → 分镜文本 → 分镜视频,把一条原本依赖人工的内容生产链路变成多个Agent的协作。 做了一个AI漫剧工具后,发现最难的根本不是“生成视频”(上) 做了一个AI漫剧工具后,发现最难的根本不是“生成视频”(中) 做了一个AI漫剧工具后,发现最难的根本不是“生成视频”(完结) 但真正开始跑剧之后,就会遇到一些细节问题: 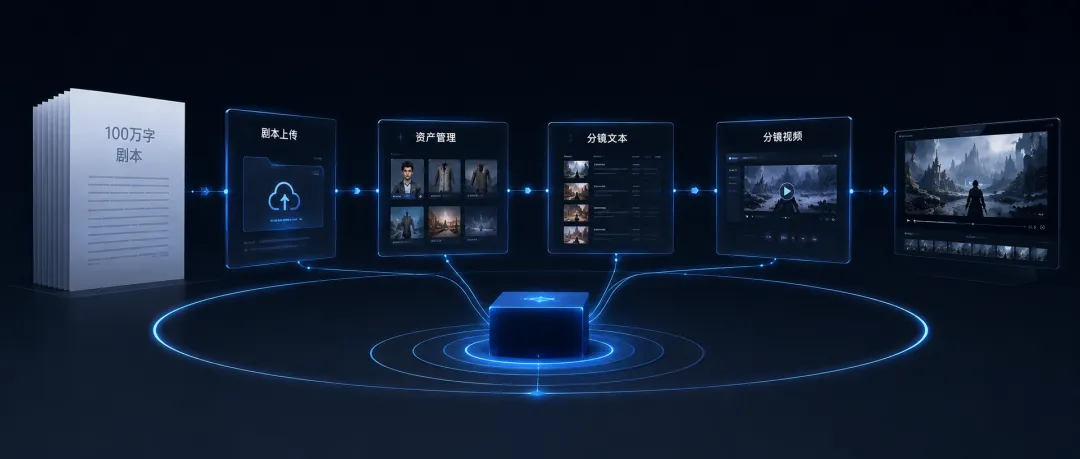
稳定地讲同一个故事 今天,我们不聊虚的,就聊聊在实际操盘AI漫剧工具时,那些最让人头秃的细节是怎么解决的。 现在很多大模型的Context已经非常长,百万Token级别的模型也越来越常见。所以从“模型能不能读”这个角度,答案可能是:能。 可是,如果你真这么干,就是在给自己挖坑,会产生一堆的问题: 这就好比让一个过目不忘的人一口气读完一本百万字小说,然后立刻让他默写某个片段,他大概率会串台。 丢100万字给模型,最直接的后果就是到了第三十集,AI可能已经忘了主角在第一集设定是个左撇子。 
直接理解VS结构化记忆 在产品层面,我的解法是:全剧记忆+结构化资产记忆+当前镜头上下文。 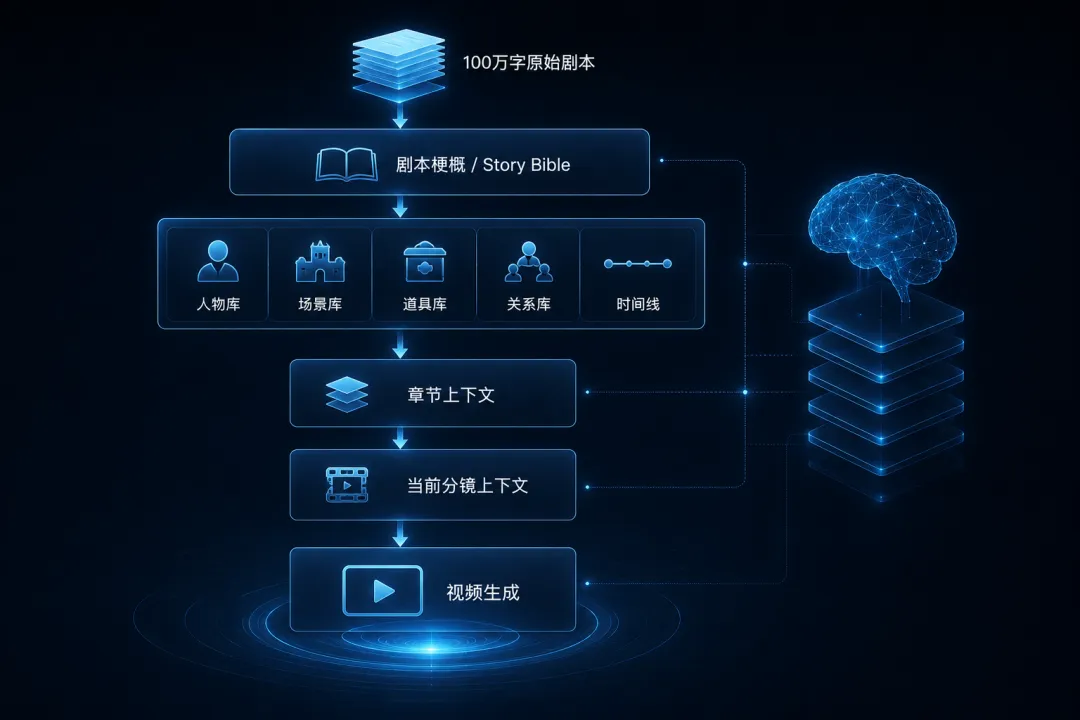
全剧记忆+结构化资产记忆+当前镜头上下文 主要负责回答:这个故事到底讲了什么? 包括:世界观、主线剧情、章节结构、人物关系、时间线、核心冲突、重要剧情节点。 这一层可以理解为整个故事的Story Bible。 把故事里的关键对象单独管理:角色、场景、道具、关系、状态、事件…… 比如: 这些信息不应该每次都让模型重新“猜”。 把全局记忆和结构化资产记忆搞定后,到了第38个镜头,模型真正需要的可能只有:当前章节 + 当前场景 + 出场人物 + 前后剧情 + 人物状态 + 对应Reference。 所以,长上下文解决的是“能不能装下”,而记忆架构解决的是“能不能真正用好”。 剧本里最常遇到一个问题:角色长大了,或者黑化了,怎么处理?如果把这些全部当成不同角色,后面人物关系会越来越乱。同时,AI会在剧情连贯性上彻底懵逼,它不知道这两个人其实是同一个。 我们设计借鉴了UI设计里的Design Token思路:一个Character ID,多套Visual Version。 例如:张三 = R001
这样,“张三是谁”属于Identity层,“张三现在长什么样”属于Visual层。当剧本出现:“黑化后的张三走进大殿。”,系统直接调用:R001 - V3。 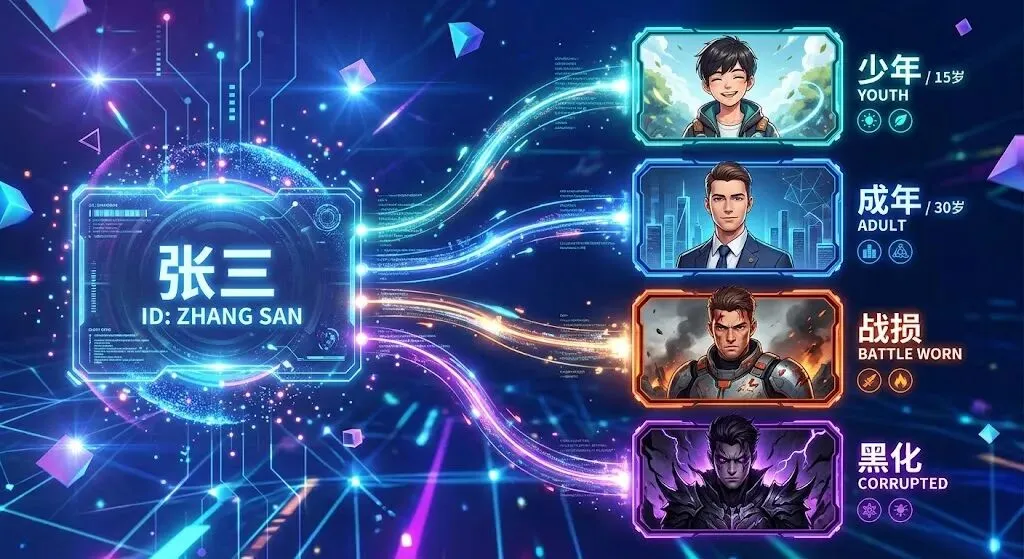
一角色多状态 做AI产品很容易掉进一个坑:模型效果不好 → 加Prompt。还不好?继续加。再不好?再加。最后形成一个几千字的“超级Prompt”。 结果就是:模型根本不知道应该听哪句话。其实:Prompt不是越长越好,而是越明确越好。一个稳定的Prompt,需要符合以下特点: 不要让一个Agent同时负责:理解剧情 + 提取人物 + 生成图片Prompt + 判断人物关系 + 检查逻辑。 这相当于让一个产品经理同时当:产品、设计、研发、测试、运营、老板。最后大概率是啥都做不好。 告诉模型:你负责什么;也告诉它:你不负责什么。 比如资产提取Agent只负责:识别角色、场景、道具,并生成结构化描述。不要让它顺手把分镜提取了。 通过固定字段、枚举值,限制模型的自由发挥。比如提取角色时,不让模型自由描述“这个人物长什么样”,而是提前定义好字段:角色名、性别、年龄、身份、外貌特征、状态等,每个字段都有明确要求。 这样,模型就不是在“写作文”,而是在“填表”,也方便后续其他Agent直接调用。 现实世界最麻烦的不是“正常情况”,而是:剧本没写、信息冲突、无法判断等异常情况。 所以Prompt里要明确:不知道就返回UNKNOWN,不要自己编。这一点非常重要。因为AI产品最怕的不是“不知道”。而是:一本正经地胡说八道。 有些规则很难单纯靠文字讲清楚,这时候可以给:正确案例、错误案例、边界案例。让模型知道什么叫“对”。 但也不要疯狂堆案例,否则又回到了第一个问题:Prompt自己先把Context吃光了。 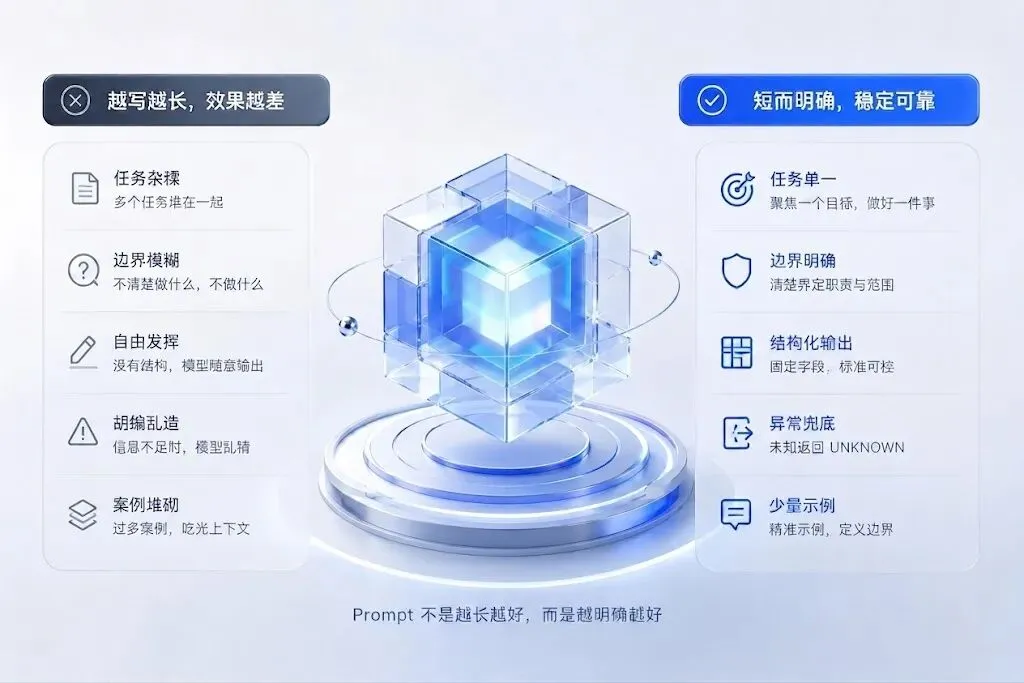
稳定可靠的Prompt 这也是AI产品和传统软件产品一个很大的区别: 视频质量的提升不能只靠“换一个更强的模型”或者“再抽几次卡”。而是应该从资产、Prompt、Reference、模型和生成策略五个方面入手。 比如一个主角要出现在几十个镜头里,如果每次生成视频都让模型重新理解“一个30岁左右、黑色短发、穿深色夹克的男人”,那角色漂移几乎是必然的。更合理的方式,是先生成并确认角色标准图、场景标准图,再将这些资产作为后续生成的基础。 简单来说,就是先确定“这个人到底长什么样”,再让他去演戏,而不是每个镜头都重新“捏一个人”。 “男主愤怒地离开房间”这句话,人类很好理解,但对模型来说信息其实远远不够。人物怎么动?是猛地起身,还是缓慢转身?镜头是全景还是近景?摄像机跟拍还是固定?情绪通过表情体现,还是通过动作体现? 实际生成时,更有效的方式是把人物、动作、表情、环境和镜头语言拆开描述,即结构化描述。例如,不只是告诉模型“男主离开”,而是明确:男主先皱眉看向对方,停顿两秒,随后转身快步走向门口,镜头从侧后方跟随推进。 这样做的目的不是把 Prompt 写得越长越好,而是减少模型的自由发挥。 很多一致性问题,单靠文字描述很难解决。这时候参考图就很重要。 比如角色进入一个固定办公室场景,除了使用角色资产,还可以把已经确认的场景图作为 Reference,甚至直接使用上一镜的尾帧作为下一镜的首帧参考。这样做不能保证 100% 一致,但至少能明显降低“换人、换衣服、换场景”的概率。 尤其是连续剧情镜头,参考图本质上就是给模型增加一个明确的视觉锚点。 这是实际生产中非常重要的一点。 比如“男主从桌前起身,推开椅子,快步走到窗边,拉开窗帘,回头看向女主”,这一连串动作全部塞进一个 5 秒视频里,模型很容易在中间任何一个环节出问题:椅子突然消失、手部变形、人还没走到窗边镜头就已经切过去。 更好的办法是拆成多个镜头:起身推椅子一个镜头,走向窗边一个镜头,拉开窗帘并回头一个镜头。 如果第二个镜头效果不好,只需要重生成这一个镜头,而不是整段视频全部推倒重来。 实际生产里,没有哪个视频模型能把所有类型的镜头都做得最好。 有的模型擅长人物表演和细微表情,有的模型适合大幅度动作,有的模型在镜头运动上更稳定。如果一个产品只提供“一个模型打天下”,最终用户只能不断抽卡。 更合理的方式,是根据镜头类型选择模型:对话镜头优先稳定性,动作镜头优先运动表现,复杂运镜则选择镜头控制能力更强的模型。 这一点其实特别重要,没有标准,就只能凭感觉判断成功与否,凭感觉优化。所以,我把视频质量拆成几个维度: 这样审核就从:“这条视频感觉不太对。”变成:“人物一致性通过,镜头通过,但动作合理性不通过。”只有知道问题出在哪,才能针对性地去优化。 所以,提升 AI 视频质量,不是找到最强的视频模型,而是建立一套能够约束模型、修正模型的生产流程:资产标准化 + 分镜拆解 + 参考图约束 + 模型适配 + 审核 + 优化。 当发现第38个镜头人物不对时,这时候要问的不是:“为什么模型这么垃圾?” 而是:问题到底出在哪一层? 一个完整的视频生成链路其实是: 剧本 ➡️ 剧情解析 ➡️ 资产 ➡️ 分镜 ➡️ Prompt ➡️ 参考图 / 首帧 ➡️视频模型 ➡️ 最终视频 当视频出现问题时,要从结果往前回溯: 视频模型参数 ➡️ Prompt ➡️ 参考图 / 首帧 ➡️分镜 ➡️ 资产 ➡️ 剧情 ➡️原始剧本 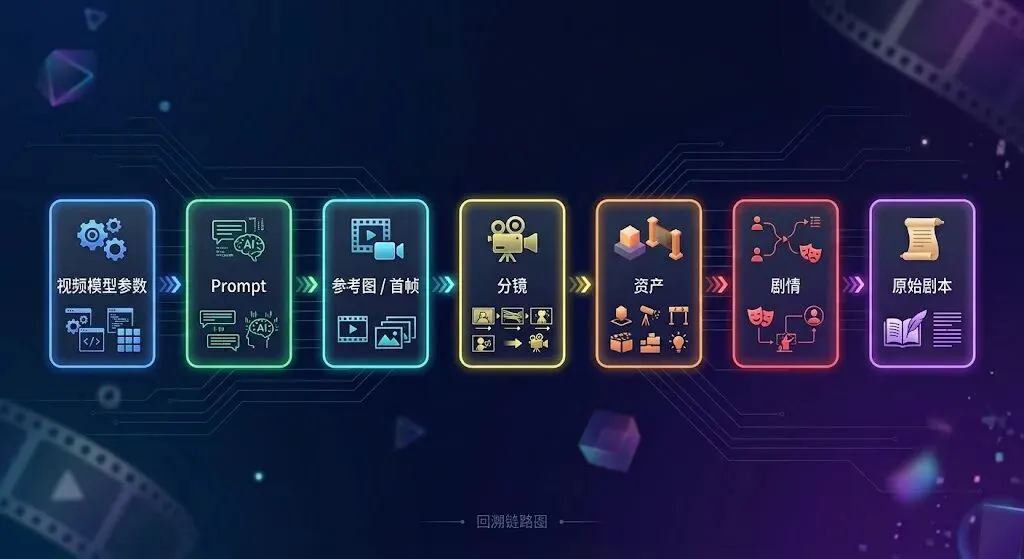
回溯链路 所以,在AI漫剧工具里,一定要非常重视AI生成Trace。每一个生成结果,都应该记录完整的生成路径。 例如:第38个镜头,除了视频本身,系统还需要记录:视频模型参数、使用的Prompt、参考图和首帧、分镜、参考图对应的资产、分镜对应的剧情、对应的原始剧本内容等等。 只有知道问题发生在哪里,才知道下一步该如何优化。 模型越强,产品经理就越不能只盯着模型。因为模型决定的是“能力上限”,而真正决定产品能不能落地的是:上下文怎么管理、记忆怎么沉淀、任务怎么拆、结果怎么校验、错误怎么回溯。 还是那句话,AI漫剧真正要解决的,从来不是:“AI能不能生成一条好看的视频?”而是:“AI能不能连续生成1000个镜头,而且这1000个镜头讲的始终是同一个故事。”这才是AI内容生产从“玩具”走向“生产力”的分水岭。
100万字的剧本,该如何处理?
同一个角色到了第38个镜头,脸还能不能是同一张脸?
少年时期的张三和成年后的张三,是不是当成一个资产处理吗?
如果视频出了问题,该如何查找问题?
1.100万字剧本,真的能直接扔给大模型吗?
token成本高:超长上下文,成本极高;
信息召回不准:文本太长,容易出现幻觉或遗漏;
长程一致性差:前期设定与后期剧情距离太远,容易出现人物设定、时间线、世界观前后矛盾;
Agent协作效率低:不同 Agent 重复理解原始剧本,无法充分复用前置 Agent 的分析结果;
上下文更新困难:修改某一章节后,如果依赖完整剧本重新处理,成本和效率都很差;
1.全局记忆
2.结构化资产记忆
角色:李玄、苏晚、王掌柜
场景:京城、客栈、王府
道具:轩辕剑、和氏璧、灵珠
3.当前镜头上下文
2.甄嬛与钮祜禄·甄嬛:多状态角色的“马甲”管理
状态 | Visual Version |
|---|---|
少年 | V1 |
成年 | V2 |
黑化后 | V3 |
3.Prompt越写越长,效果反而越来越不稳定
1.任务最好单一
2.明确边界
3.尽量结构化
4.给异常情况留出口
5.用Few-shot告诉模型边界
传统系统里,代码怎么写,结果基本是确定的;
大模型是概率系统,所以,AI产品设计必须天然考虑:不确定性、异常、重试和兜底。
4.如何提升视频质量
1.先把资产做稳定,再谈生成
2.Prompt不能只写剧情,要写清楚镜头
3.用 Reference 把关键内容“钉住”
4.复杂镜头不要硬生成,要学会拆
5.不同镜头,用不同模型
6.建立一套“质量标准”
人物一致性:脸、发型、服装、身体比例有没有变化?
动作合理性:人物动作有没有穿模、肢体畸变、动作断裂?
镜头质量:构图、景别、运镜是否符合分镜要求?
场景一致性:背景、光影、空间关系有没有突然变化?
剧情一致性:人物有没有做出不符合剧情和人物状态的动作?
整体观感:有没有明显的AI痕迹和影响观看的问题?
5.出了Bug算谁的?建立可观测的Trace链路