ARTICLE · 993982
RAG 评测怎么做?把文档切一半当考卷,我的土办法竟是工业标准
2026.08.31 | 全文约 4300 字 | 5 节 + 数据附录
最近我的很多活都是 AI 干的,如何验收让我想了很多办法。最后用了模型训练的思路:出题、判分、把错题变成规则——用的是训练的方法。
更意外的是,这套办法居然是工业标准,而全行业最会出考卷的那个人,偏偏反着来。
§01 · 笨办法
01我的笨办法,在工业里长这样
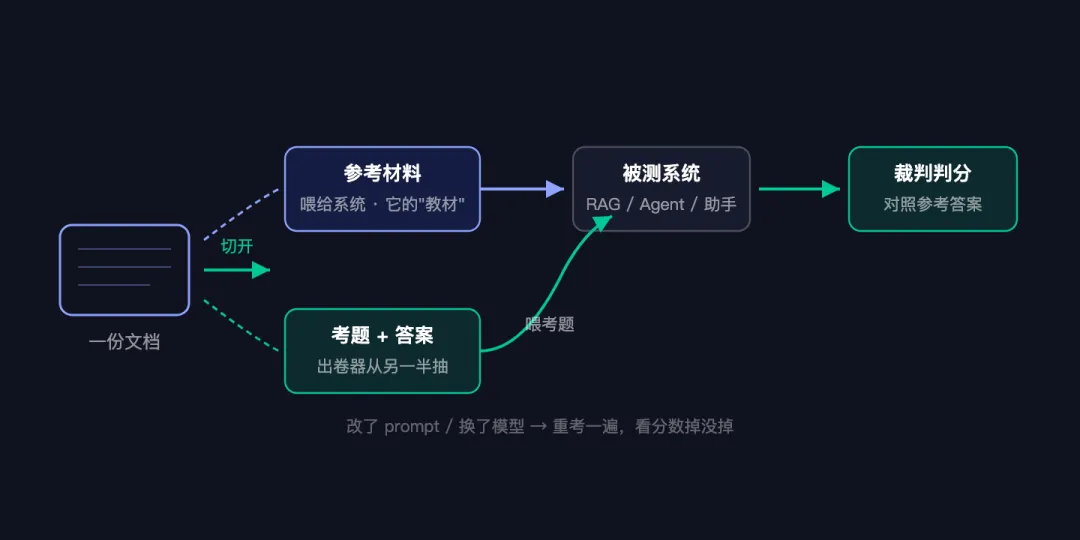
先把 RAGAS 这套标准流程讲清楚,你就知道这套流程跟"半份试卷"是同一个东西。
第一步切块:知识库文档切成小块,块的大小决定考题粒度。第二步出题:让一个生成模型对每个块产出"问题加参考答案"——这里有个讲究,RAGAS 会把简单的事实题升级成多跳推理题、加条件题,防止整张卷子都是"某功能在哪一章"这种送分题。第三步过滤:裁判模型给每道题打分,砍掉烂题——工业惯例是让裁判先写出理由再给分,理由给了思考空间,分数反而更准。第四步考试:被测系统作答,检索到的内容一并记录。第五步回归:改了提示词、换了模型,重考对分。
检索段: Context Recall(该找到的找到没)// + Context Precision(排位准不准)生成段: Faithfulness(答案从材料来的吗)// + Answer Relevancy(对不对题)
四个指标各管一段,"没找到"和"找到了没答好"不会混在一个分数里糊弄你。
CAVEAT · 坑是现成的
RAGAS 内置的出题模板是英文的,中文知识库直接用会出"翻译腔考题",得自己重写;合成的考题天然偏事实性,所以严肃的项目都会保留一个人工校验的小子集当锚——纯合成的分数只用来做回归对比,不当绝对水平。
一句话:我的笨办法没问题,这办法是正经工业实践。问题出在下一层。
§02 · 拆题的人
02姚顺雨为什么不这么出题
姚顺雨是全行业最会出考卷的人。他博士期间参与做的几个 benchmark,WebShop、SWE-bench,现在都是行业标准。但你去看他出题的方式,会发现他跟 RAGAS 是反着的:RAGAS 从教材里合成考题,他从现实里拆考题。
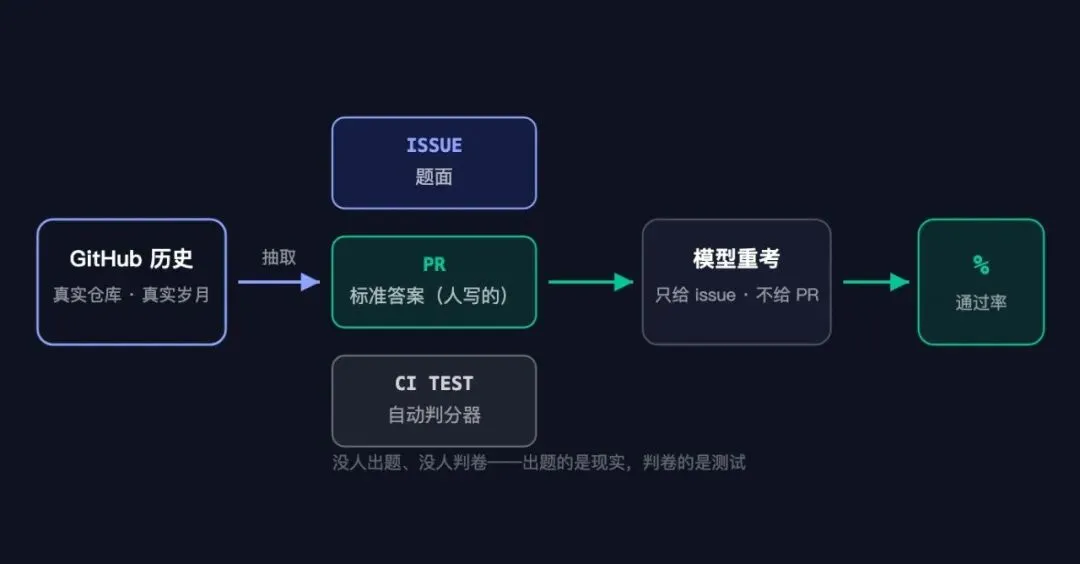
拿最有名的 SWE-bench 说。这个基准考 AI 修 bug 能力,出题流程五步,全程没有一个人工出题:第一步选仓库,挑了 12 个高星 Python 开源项目,django、sympy 这类真实工程;第二步配对,收集有对应修复 PR 的 issue——题面是 issue 正文加当时的代码快照,答案就是程序员后来提交的那段修复代码;第三步筛选,只保留"测试能判"的——硬条件是存在修复前失败、修复后通过的测试,没有自动判分器的题直接扔;第四步成题,2,294 道,每道题一个独立容器;第五步判分,跑两组测试——该修好的修好没有,以及有没有顺手改坏别的地方,改坏一处这道题就不算过。
他不是出考卷,他是把人类已经答过、已经批改过的试卷,拆出来让模型重考。
GitHub 上每天发生的事,天然是一个三元组:issue 是题面,程序员的 PR 是标准答案,CI 测试是判分器。没有一道题是编的,全是现实世界发生过的。
还有一个细节我特别喜欢,藏在他的构造代码里:判卷老师上岗前要先考试。SWE-bench 有个校验步骤,拿标准答案喂给判分器,判不出满分的题目直接剔除。后来 OpenAI 又对整套题做了人工重新校验,剔除含糊题,留下 500 道确认无误的子集,成了行业真正引用的版本。大部分公司的内部评测,连判分器对不对都不验。
他后来还做了个 τ-bench,考 AI 客服,判卷用了一个我特别欣赏的设计叫 pass^k:同一个任务连跑 k 次,全部成功才算过。这跟 pass@k(k 次里成一次就算过)相反——pass@k 奖励灵光一现,pass^k 奖励不失手。
66%单次成功率 95% 的系统,八连任务全过的概率——三分之一概率翻车
92%单次 99% 才能达到的八连全过率——"差几个点"差了一个档次
2,294道 SWE-bench 真实考题,全部来自 12 个开源仓库的真实历史
他把"聪明"和"可靠"分开了——demo 惊艳靠前者,敢交钥匙靠后者
没人出题——出题的是现实,判卷的是测试
§03 · 分界线
03分界线:你在考什么
那到底该听谁的?RAGAS 从教材出题,姚顺雨从现实拆题——我的笨办法站哪边?
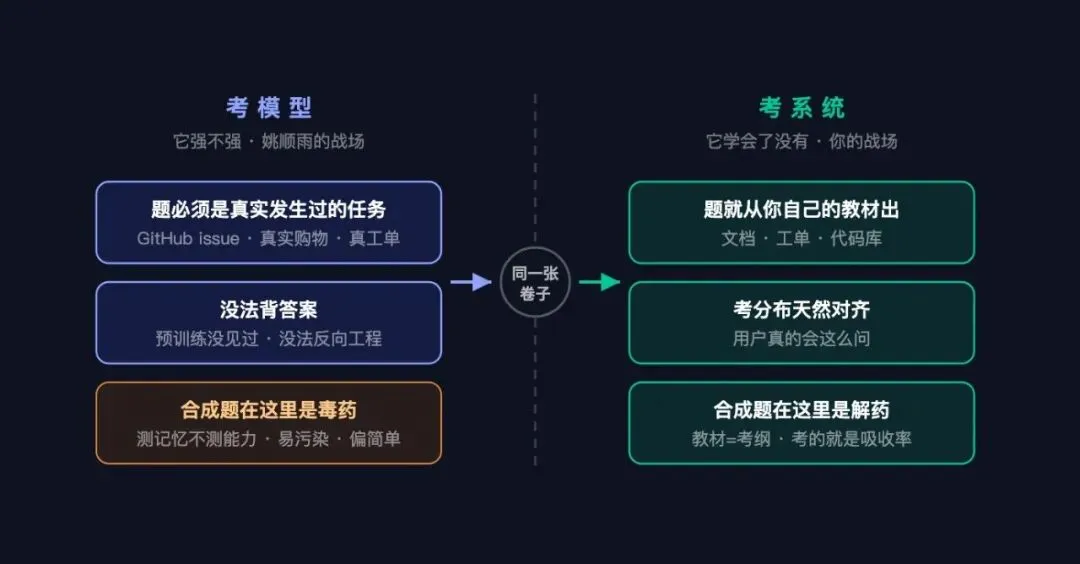
站哪边取决于你在考什么。这是整篇文章我最想讲清楚的一张框架:考模型,和考系统,是两个物种。
考模型,是问"这个 AI 强不强"——那是姚顺雨的战场,模型厂的战场。这种考试里,拿合成题当能力排名的依据是毒药:题从教材里出,考的是"有没有读到"而不是"会不会";预训练可能见过类似题,污染分数;出题的模型倾向生成简单的事实题,出不了真难题。所以他必须用真实任务——GitHub 上真实发生的 issue 难背,现实世界没法系统性刷题。
考系统,是问"我这个搭好的东西学会了没有"——我的战场,也是每一个在自己业务里用 AI 的人的战场。这种考试里,合成题反而是解药:你被测对象的教材就是公司那批文档,从教材出题,考的恰恰是"配了这些材料之后他吸收了没有";而且题目分布天然对齐——用户真的会这么问。
INSIGHT
判断标准就一句话:教材和考纲的边界重合,题目才合法。模型的教材是整个互联网,你出的任何合成题对他都太窄;你自建系统的教材就是那几个文件夹,从文件夹出题,天经地义。
我那个笨办法之所以撞上了 RAGAS 而不是撞上 SWE-bench,不是巧合——因为我要考的是"我的系统",不是"模型本身"。想到这一层,土办法突然就有理论地位了。
§04 · 生意
04这条分界线上有一门生意
再往深一步:考系统这一侧,市场正在打开,而且逻辑很硬。
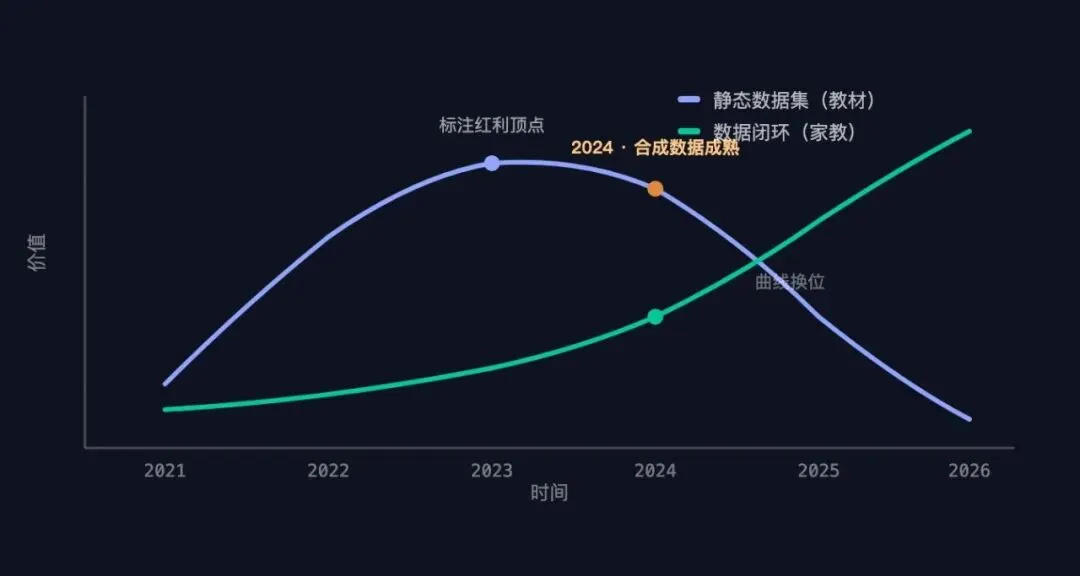
先看反面,为什么"卖训练数据"不是好生意。2021 到 2023 年,那是数据标注公司的黄金时代,模型能力的瓶颈卡在数据上,人类写的示范是必需品,卖铲子的赚翻了。然后买方学会了自产,三件事同时发生:合成数据成熟了——强模型生成训练材料喂给要训的模型,质量追平人类标注,成本近零;自动判分成熟了——代码有天然判卷老师(测试跑通即得分),数学有可验证的答案,强化学习直接对着自动奖励练;递归自改进来了——模型被请进自己的数据生产线,自己提方案、跑实验、定数据策略。
当买方能以近零边际成本生产等质量商品,卖方的价格必然坍塌。
Scale AI 的轨迹是这条曲线的最新样本——估值冲上百亿级,大客户纷纷自建、转向合成,核心成员最后被 Meta 成建制挖走。客户不仅不买铲子了,客户把铲子铺买空了。
什么防得住合成替代?模型可以合成"数据",但合成不出"你们家用户的真实分布"——生成的题目再漂亮,分布不是你的分布,考了等于白考。真实交互是唯一造不了假的原材料。所以升值的不是"数据"这个名词,是回路:持续从真实使用中回收反馈、持续出题判卷、跟业务绑死的闭环。卖训练集是卖教材,会被复印、后来机器自己会写;闭环是当家教,跟着学生每次考试重新出题,学生越学越离不开。
现在把三条线拼起来:全球 AI Agent 数据服务已经是个 66.3 亿元的盘子,企业 Agent 的采纳率一年半里从 17.3% 冲到 40.3%,每家上了 Agent 的公司都面临同一个问题——换了模型、改了提示词,怎么知道是变好了还是变坏了?公开的榜单又测不出你家的场景。答案只剩一个:自己出卷。从自己的文档、工单、代码库生成一套私有评测集,每次迭代跑回归。
复印机会让教材归零,家教跟着学生越教越深
把 TDD 的红绿循环,卖给企业。
§05 · 手艺
05你可能早就在出卷了
最后把话说回每个用 AI 干活的人。
对照一下:写代码先写测试的人,做的事就是在出卷——测试就是奖励函数,红绿循环就是训练循环。每次让 AI 干完活都人工验收一遍的人,就是在判卷。踩过的坑沉淀成规则、下次自动检查,这就是在做负样本回流。这些事很多人天天在做,只是没从这个角度看过。
区别只是规模:姚顺雨在模型厂给模型出卷,几亿用户替他判卷;一个在自己业务里用 AI 的人,在自己的系统前面出卷,自己是唯一的判卷老师。原理是同一句话——你考核什么,他就长成什么。这句在模型厂是技术判断,落到自己桌上,是手艺。
我的笨办法没变,还是那半份试卷。变的是我知道了这份试卷的来历:一边连着开源框架的标准流程,一边连着一门正在打开的生意,中间站着一个从现实里拆考题的人。
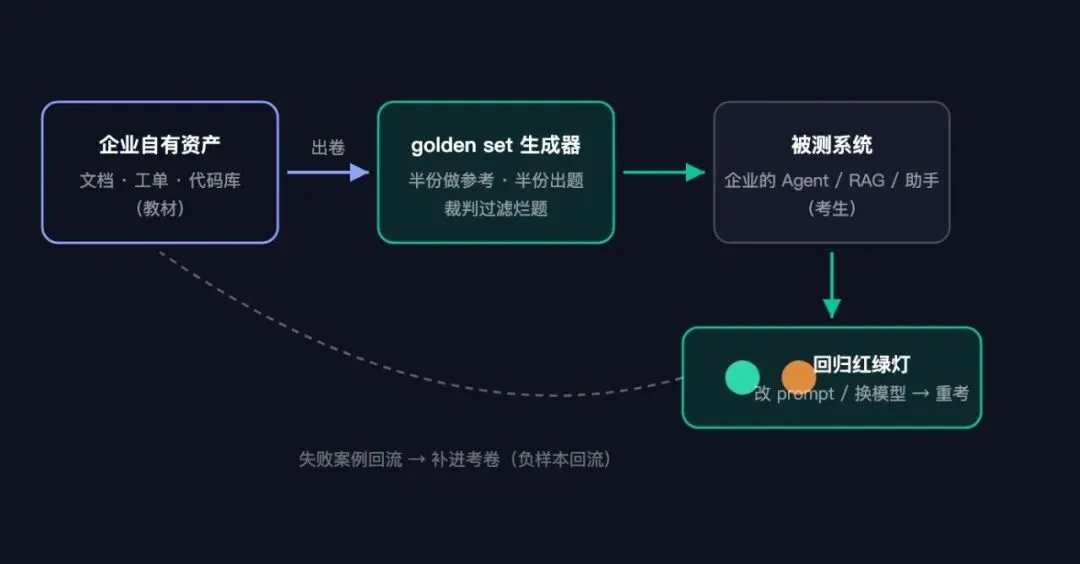
每次迭代必考,你是判卷老师
土办法走到头,都是有来历的。
$trace --status>exam in progress. you are the grader.
文中事实均来自下方所列公开资料;数据服务市场与采纳率数字为行业报告口径。
APPENDIX · 参考来源
01RAGAS 文档与 HuggingFace RAG 评估教程(huggingface.co/learn/cookbook)
02SWE-bench 论文:Can Language Models Resolve Real-World GitHub Issues?(arXiv:2310.06770)
03SWE-bench Verified(OpenAI,2024)
04τ-bench: A Benchmark for Tool-Agent-User Interaction(ICLR 2025)
05沙利文《全球及中国 AI 数据服务市场发展白皮书 2026》
06沙丘社区《2026 企业级 AI Agent 应用最佳实践报告》
07上海创智学院:最强智能体真实生产场景评测分析
08极客公园:汤道生×姚顺雨对谈