ARTICLE · 995110
源码分享 | 智能法律问答助手:让每一条法律回答都"有据可查"
“ 本文分享基于 RAG 的法律咨询服务系统的内容,感兴趣的可以关注公众号或加微信 kxswx001 联系我”
大家好,我是行走的猿,欢迎阅读本篇文章!如果您觉得对文章内容感兴趣,别忘了点击下方【行走的猿】关注下公众号,以便随时获取更多精彩内容。
本文分享一套用 RAG(检索增强生成)技术构建的法律垂直领域智能问答系统。你问它一个法律问题,它先翻法律条文库找到相关法条,再基于这些真实法条回答你——每一条法条都能点开看原文,让 AI 的每一句法律回答都有"出处",显著降低幻觉率。
项目介绍
本项目是一个面向法律垂直领域的RAG(Retrieval-Augmented Generation,检索增强生成)智能问答系统,基于《中华人民共和国刑法》《民法典》等已构建好的法律条文库,对用户提出的法律问题给出带条文引用的结构化回答。
为什么要做这个项目
通用大模型回答法律问题,有两个让人不安的问题:
幻觉:可能编造不存在的法条编号 不可溯源:无法验证"依据呢"
法律是强严谨领域。"看起来对"的回答最危险——一次错误,代价可能是一桩本不该输的官司。
本项目用RAG 三层架构解决:
检索层:回答前先检索相关法条 生成层:把真实法条作为上下文喂给 LLM 溯源层:解析引用编号 [1][2],前端渲染为可点击的"引用来源"卡片
系统分两个端,共享同一套后端:
用户端(普通用户)
自然语言提问,比如"借钱不还怎么办" 几秒后得到四段式回答:适用情形 → 法律依据 → 风险提示 → 结论建议 每条法律依据下方一张"引用来源"卡片,点击可看原文弹窗 支持多轮对话、自动命名、流式输出、可手动停止
运维端(管理员)
上传法律文档(PDF / DOCX / TXT / MD) 一键重建索引,新法条立刻可用 检索调试:分别跑 BM25 / 向量 / 混合 / Rerank,对比 Top-N 压缩调试:模拟长对话,观察 token 变化 LLM 配置:运行时切换模型、调温度、测试连通性 用户管理
核心能力特性
[n] 编号 → 后端解析 → 前端可点击卡片 | |
系统角色
角色定义
role=user | ||
role=admin |
权限矩阵
鉴权流程
用户登录 → bcrypt 校验密码↓签发 access token(2h)+ refresh token(7d)↓前端存 localStorage↓后续请求 Header:Authorization: Bearer↓后端 @jwt_required → @admin_required 双重校验
项目结构
后端结构(Flask 四层架构)
backend/app/│├── api/ ← 路由层:只负责 HTTP│ ├── user/ ← chat.py (SSE) / session.py│ ├── ops/ ← document / retrieval / llm /user/ dashboard / debug│ └── auth.py│├── services/ ← 业务编排层:把”剧本”串起来│ ├── chat_service.py ← 问答主流程│ ├── ingest_service.py ← 文档入库│ └── compress_service.py│├── core/ ← 核心引擎:纯 Python,不依赖 Flask│ ├── retriever.py ← 混合检索 + RRF│ ├── llm.py ← 通义千问封装│ ├── embeddings.py ← 向量化封装│ ├── vector_store.py ← Chroma 持久化│ ├── bm25_store.py ← BM25 索引│ └── ...│├── models/ ← 数据层:SQLAlchemy 模型└── utils/ ← 工具层:文件解析、法条抽取
为什么这样分?
api 层 只接 HTTP,以后换 gRPC 也只动这一层 services 层 是"剧本"——一套完整业务流程在这里编排 core 层 是"工具箱"——纯函数、可测试、可复用 models 层 是"数据形状"
这种分层让代码像积木一样可拆可拼。加新功能在 services 加剧本;换搜索引擎在 core 换工具。
前端结构(Vue + Element UI)
frontend/src/│├── views/ ← 页面│ ├── user/ ← Login.vue / Chat.vue / Profile.vue│ ├── ops/ ← Dashboard / DocumentUpload / Index / DebugMemory / LlmConfig / UserList│ └── NotFound.vue│├── store/ ← Vuex 状态管理│ └── modules/ ← user.js / chat.js / ops.js│├── api/ ← axios 封装├── router/ ← 路由 + 全局守卫├── layouts/ ← UserLayout / OpsLayout└── utils/ ← request.js / auth.js / markdown.js
前端核心是views/user/Chat.vue——这一个文件承载了流式接收、引用渲染、会话切换、自动滚动、停止生成等所有对话体验细节。
技术栈
后端
前端
{code, message, data} | ||
四个最关键的设计
① 混合检索 + RRF 融合
法律问题既要"语义相似",也要"关键词精准",所以两路并跑:
用户问题├─→ BM25 检索(关键词精准)──→ Top-20 ─┐│ ├─→ RRF 倒数排名融合 ──→ Rerank ──→ Top-8└─→ 向量检索(语义相似)────→ Top-20 ─┘
BM25 用 jieba 分词后建倒排索引,抓"第 203 条""逃税罪"等专有名词快狠准 向量检索 用通义千问 Embedding,把问题和法条都变成 1024 维向量 RRF 把两路排名按倒数排名融合,无需调权重,无监督、效果稳 最终 Top-8 喂给 LLM,既不超上下文,又保证召回质量
② SSE 流式输出 + "先证据后内容"
event: session → 后端告诉前端”这是哪个会话”event: evidence → 引用证据(LLM 还没开始生成,证据先返回)event: delta → LLM 一个 token 一个 token 地推event: done → 结束
"先证据后内容"是有意为之——用户看到 AI 第一个字之前,引用卡片已经亮起来。
这 200ms 的心理体验差异,比优化任何 UI 细节都明显。
前端用 fetch + ReadableStream + TextDecoder 拼装 SSE 协议,配合 AbortController 实现"中途停止"按钮。
③ 历史压缩(记忆管理)
多轮对话 token 会爆炸。我加了 compress_service:
每轮写消息时累计估算 token 超过阈值(默认 LLM 上下文窗口的 60%)自动触发压缩 压缩策略:保留最近 N 条原文 + 之前的合成 summary
这样既不丢上下文,又控制成本,AI 还能"记得"早期的关键信息。
④ RBAC 双角色权限
普通用户( role=user):仅可访问/user/*管理员( role=admin):额外可访问/ops/*
双重校验:
前端路由守卫: meta: { requireAuth, requireAdmin }后端装饰器: @jwt_required+@admin_required
任何人绕过前端直调 API,都会被后端拦下。
实现效果
用户端:
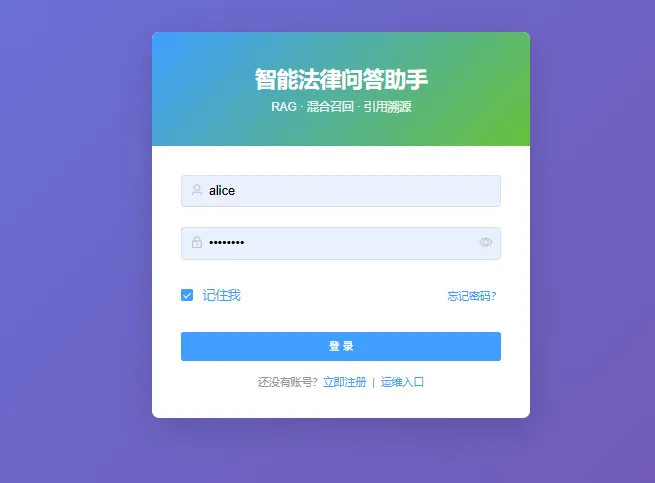
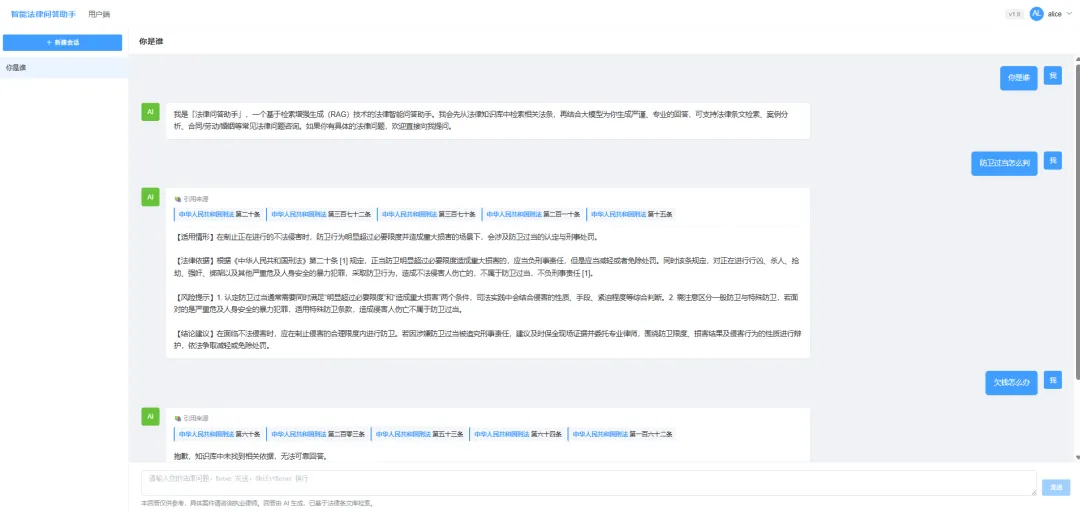
左侧会话列表,置顶的永远在最上面
右侧对话区,AI 消息左对齐、用户消息右对齐
每条 AI 回复下方,引用卡片像"脚注"一样排开 点击卡片,弹出法条原文详情
运维端:
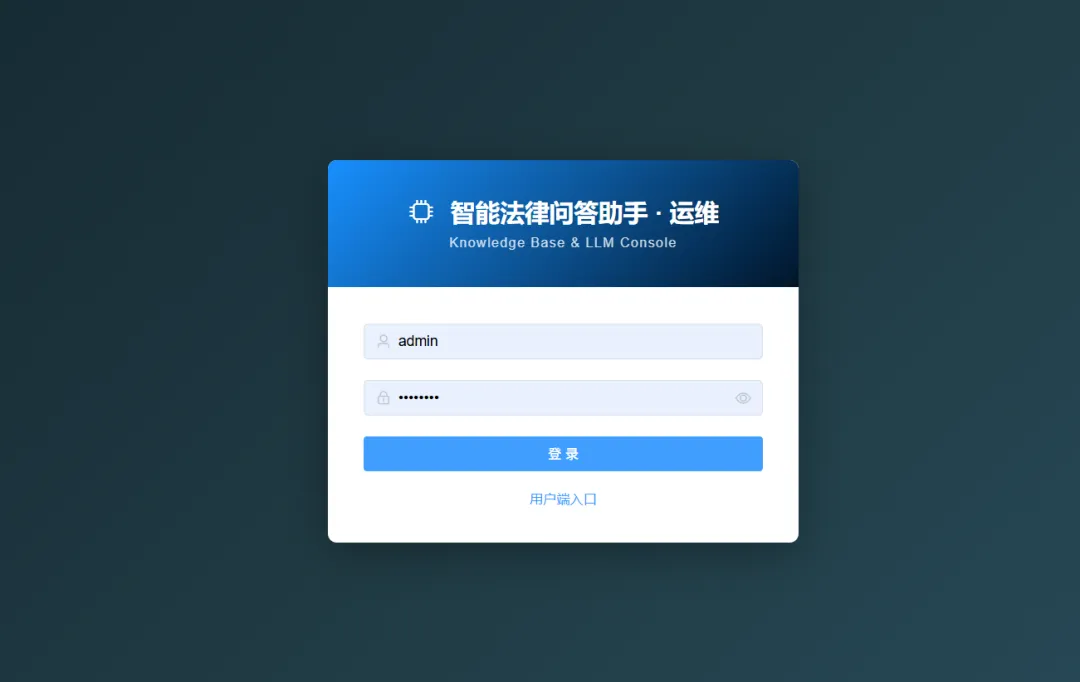
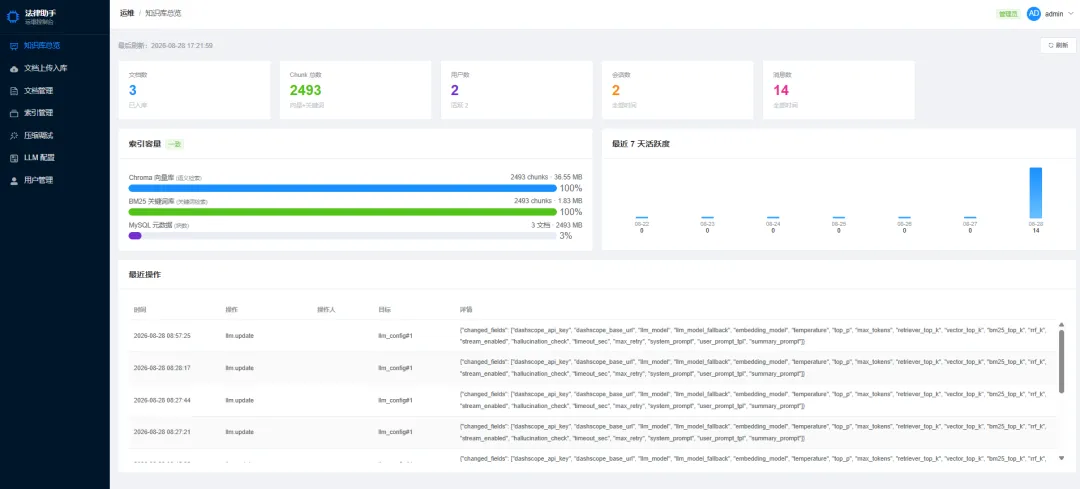
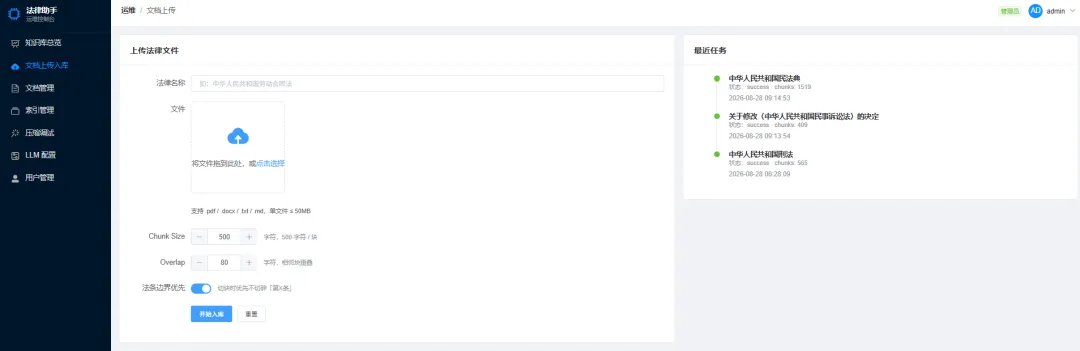
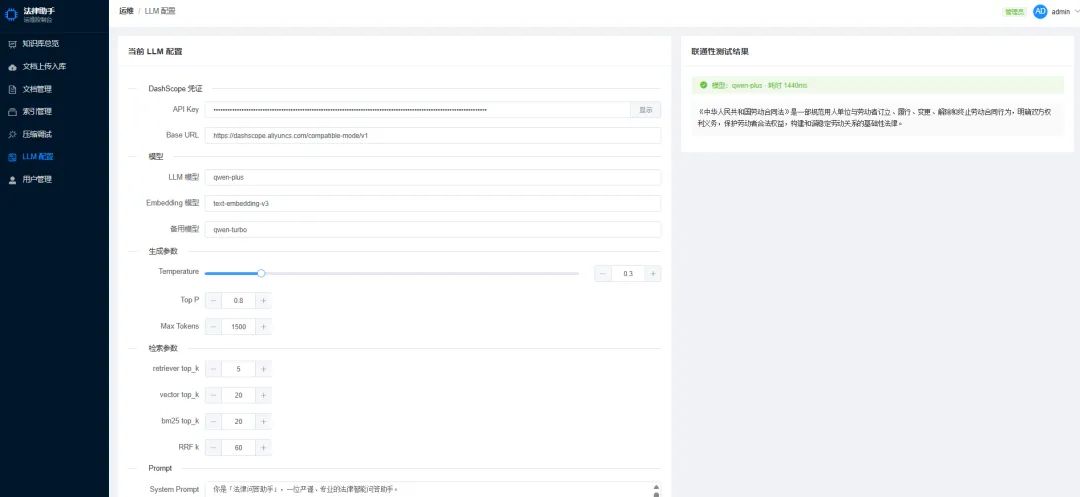
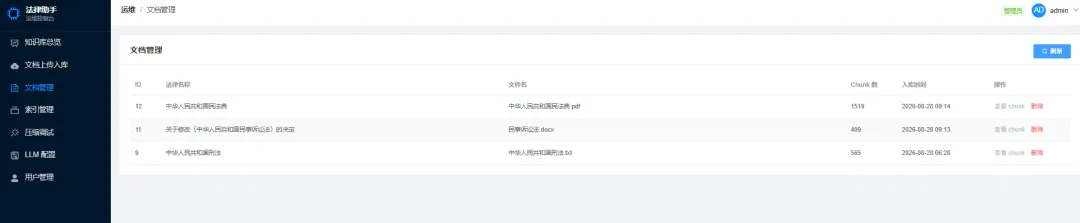
知识库总览:统计卡片 + 趋势图 文档上传:拖拽上传、实时进度条 检索调试:四路结果对比展示 压缩调试:token 变化曲线 LLM 配置:模型下拉、参数滑块、连通性测试
项目特点总结
可溯源:每条法条都能点开看原文 易扩展:上传新文档 + 重建索引即可 可调试:检索/压缩/LLM 全链路可观测 可中断:流式输出 + 手动停止 可压缩:长对话自动压缩,控制成本 可分层:api / services / core / models 职责清晰
学习之所以吃力,是因为你正在把自己推向一个新的高度,而不是停留在原地。
我们一起来学习吧~~

行走的猿,专注分享编程经验,深入聚焦Java、Python技术;分享编程干货,分享项目源码,助力毕业设计。
需要的同学可以微信联系我
喜欢就点个关注吧!