ARTICLE · 997587
从源码理解 Pi-05-Tool Calling:AI 的一句 JSON 怎样变成真正的文件和 Shell 操作?
05|Tool Calling:AI 的一句 JSON 怎样变成真正的文件和 Shell 操作?
模型说“我要读取 package.json”,和磁盘真的被读取,是两回事。
前者只是一段数据:工具名叫 read,参数里有一个文件路径。模型运行在远端 API 后面,它不能直接调用你电脑上的 fs.readFile(),更不可能隔着网络启动本地 shell。真正碰文件、创建进程的是 Pi 这个宿主程序。
麻烦都藏在两者之间:Pi 怎么知道 read 是哪个函数?模型少传了参数怎么办?命令退出码不是 0 算调用成功还是失败?执行结果为什么还要发回模型?更现实的一问是:既然模型能请求 bash,谁来限制它能做什么?
本文基于 Pi revision 2509b5c037d366979f2febfce4174b88aeaadc6a,日期为 2026-08-18。追踪当前 interactive CLI 使用的 AgentSession + Agent + agent-loop.ts 路径。不同 Provider 怎样表示 tool call 留到下一篇,这里从 Pi 已经归一化的数据结构开始。
先纠正一句常见说法
“模型调用了工具”是方便交流的简称。更准确的说法是:
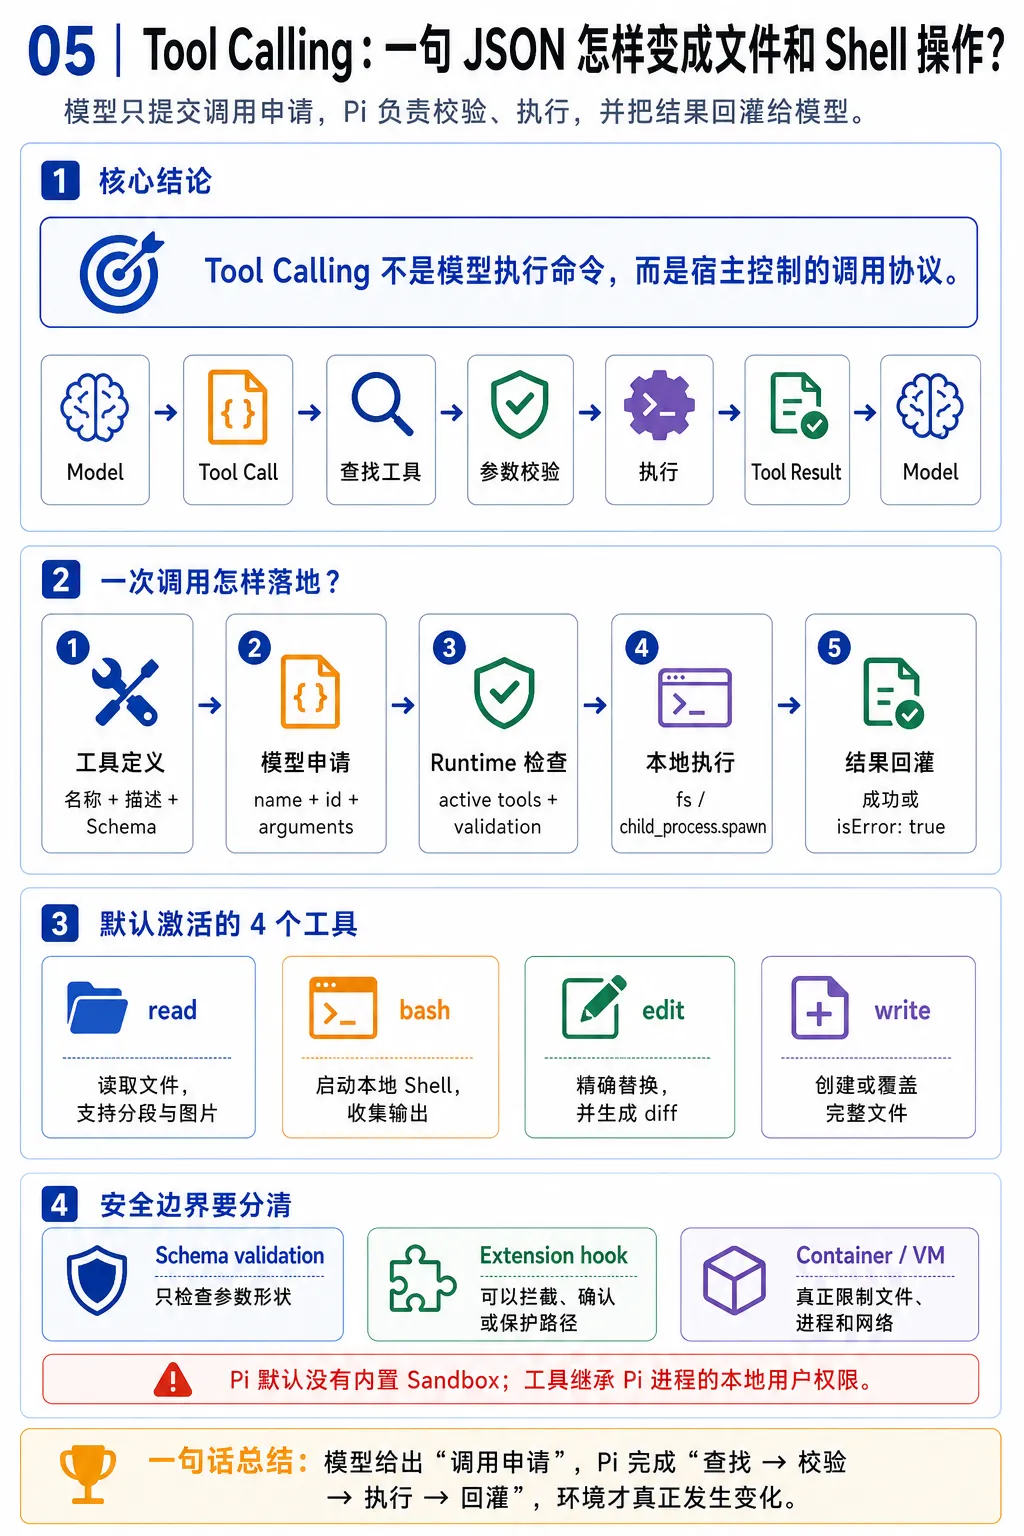
模型提交调用申请→ Pi 验证申请→ Pi 执行本地代码→ Pi 返回执行回执
可以把三个对象记成:
Tool Definition = 说明书Tool Call = 申请单Tool Result = 回执
说明书告诉模型有哪些能力、每个能力接收什么参数;申请单由模型生成,只包含名字、调用 ID 和参数;回执由宿主生成,记录成功内容或错误。模型没有系统权限,权限始终属于运行 Pi 的进程。
标题里的“一句 JSON”也要稍微打个折扣。OpenAI、Anthropic、Google 的原始协议并不完全一样,参数还可能分多个 streaming chunk 到达。进入 Agent Core 时,pi-ai 已经把这些差异归一化成统一的 ToolCall:
interface ToolCall {type: ”toolCall”;id: string;name: string;arguments: Record;}
本篇说的 JSON,指的就是这层 normalized data,而不是某一家 API 的原始报文。
三层代码,各管一段
顺着源码看 Tool Calling,最容易把工具定义、Agent Loop 和文件操作揉成一团。当前 Pi 实际把它们放在三层:
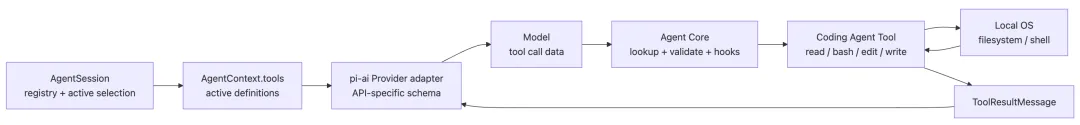
@earendil-works/pi-ai 定义统一的 Tool、ToolCall 和 ToolResultMessage,Provider adapter 负责把它们翻译成厂商协议。
@earendil-works/pi-agent-core 不关心文件怎样读取。它处理的是通用调度:按名字找工具、校验参数、执行、捕获错误、发事件、包装结果。
@earendil-works/pi-coding-agent 才知道什么叫 read、bash、edit 和 write。真实的 fs/promises 与 child_process.spawn() 都在这一层。
这里还有个源码阅读上的小陷阱:Pi 并没有一个名为 ToolRouter 的核心类。AgentSession 用 Map 管完整工具表与 active selection;到了 agent-loop.ts,当前可用工具就是 AgentContext.tools 数组,路由动作是一句按 name 的 .find()。架构上存在“注册和路由”,不代表源码里一定要有一个同名对象。
模型当前到底能看到哪些工具?
当前 checkout 共有七个内置工具:
read, bash, edit, write, grep, find, ls
但默认激活的只有四个:read、bash、edit、write。grep、find、ls 可以通过 --tools、settings 或 SDK 打开;默认情况下,模型也可以通过 bash 运行相应 shell 命令。
这个区别很重要。“已经注册”不等于“本轮可调用”。AgentSession._refreshToolRegistry() 会合并 builtin、Extension 与 SDK custom tools,setActiveToolsByName() 再把选中的 AgentTool[] 写进 agent.state.tools。如果 Extension 注册了同名工具,当前 registry 还允许它覆盖 builtin。
Agent Loop 构造 Provider context 时只带 active tools:
return {systemPrompt: context.systemPrompt,messages: llmMessages,tools: context.tools,};
所以 active selection 同时影响两头:模型请求里只声明这些工具,执行时也只在这些工具中查找。一个工具即使存在于完整 registry,只要没有 active,就不会因为模型猜对了名字而突然获得执行资格。
Tool Definition 不只是函数名
看 packages/agent/src/types.ts 的 AgentTool,一项可执行工具至少包含:
name + description + parameters + label + execute()
还可以提供 prepareArguments() 和 executionMode。Coding Agent 自己的 ToolDefinition 又增加了 system prompt 提示片段和 TUI renderer,随后由 wrapToolDefinition() 适配成 Agent Core 认识的 AgentTool。
以 read 为例,它的参数不是随便一个 object:
const readSchema = Type.Object({path: Type.String(),offset: Type.Optional(Type.Number()),limit: Type.Optional(Type.Number()),});
这份 schema 有两份工作。
发请求时,Provider adapter 把它转成厂商需要的 function/tool schema。比如 OpenAI-compatible API 接收 function parameters,Anthropic 接收 input_schema。模型据此知道 path 必填、offset 和 limit 可选。
调用回来后,Runtime 还会用同一份 schema 做本地校验。即使 Provider 宣称支持 strict tool schema,宿主也不能把模型输出当成可信输入。API 兼容性、流式拼接、模型行为都可能产生不符合 contract 的参数。
Schema 解决的是“形状对不对”,不是“操作安不安全”。一个合法的 { command: "..." } 仍然可能是危险命令,这一点后面单独说。
跟一遍真实的 read 调用
假设 Provider 最终交给 Agent Core 的 block 是:
{”type”: ”toolCall”,”id”: ”call_42”,”name”: ”read”,”arguments”: {”path”: ”packages/coding-agent/src/core/tools/read.ts”,”offset”: 1,”limit”: 80}}
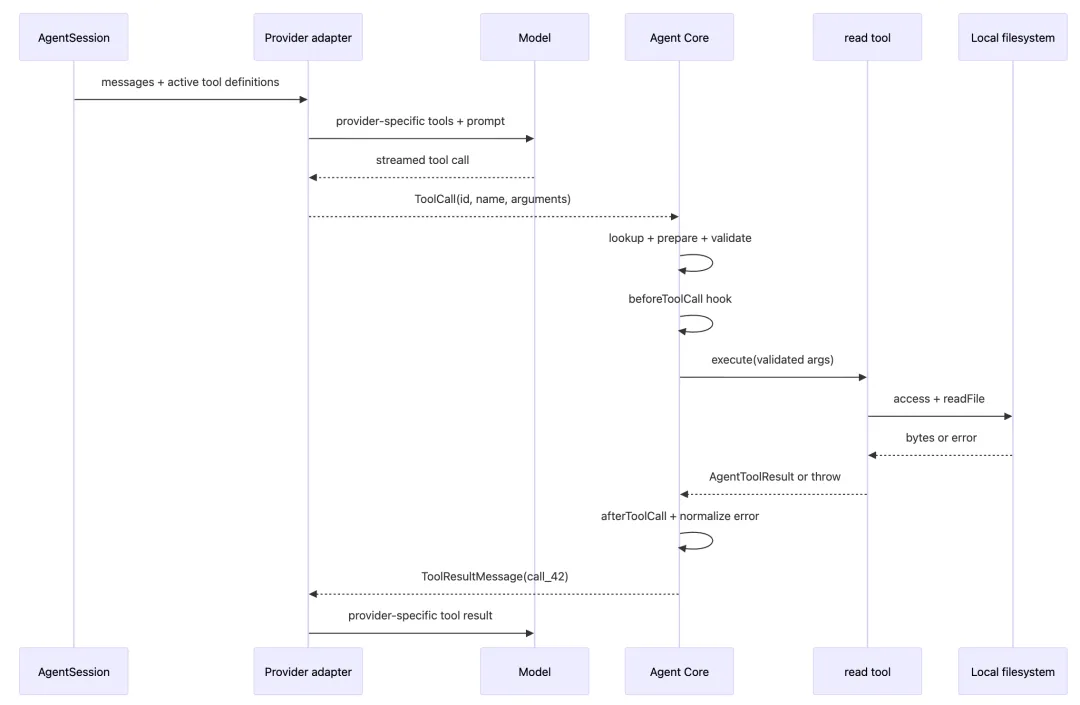
它变成文件内容,要经过下面这条链:
先按名字找,而且只找 active tools
入口在 packages/agent/src/agent-loop.ts 的 prepareToolCall():
const tool = currentContext.tools?.find((t) => t.name === toolCall.name,);if (!tool) {return {kind: ”immediate”,result: createErrorToolResult(`Tool ${toolCall.name} not found`),isError: true,};}
找不到不会去全局反射一个同名函数,也不会把模型提供的名字拼进 eval()。Runtime 直接生成错误回执。
这一步看起来普通,却是 Tool Calling 最重要的控制权之一:模型只能选择宿主事先交给它的能力,不能自己创造执行器。
有兼容预处理,再做 schema validation
找到工具后,可选的 prepareArguments() 先运行。当前内置 edit 用它兼容一些真实模型行为:把旧版顶层 oldText/newText 折进 edits[],把单个 edit object 包成数组,也尝试解析字符串化的 edits。
预处理之后,packages/ai/src/utils/validation.ts 的 validateToolArguments() 才接手。它 clone 参数,清理 optional field 中不合适的 null,按 schema 尝试类型转换,再用 TypeBox 编译出的 validator 检查。失败信息会带字段路径和收到的原始参数。
这套流程比一句 schema.parse(args) 稍微宽容,因为模型偶尔会把数字写成字符串,或者给可选字段填 null。但宽容有明确终点:转换后仍不满足 schema,就不执行工具。
校验异常也不会直接炸掉整个 Agent Loop。prepareToolCall() 把它捕获成 isError: true 的 tool result。模型下一轮能看到“缺少 path”或“字段类型错误”,然后重新申请。
Extension 可以在执行前拦截
schema 通过后,Agent Core 调用 beforeToolCall。Coding Agent 在 AgentSession._installAgentToolHooks() 中把它接到 Extension 的 tool_call event。
这给产品层留下了一个策略入口。例如 Extension 可以检查 bash.command,要求用户确认;也可以保护某些路径,返回:
{ block: true, reason: ”Protected path” }
当前 contract 还允许 handler 原地修改已校验参数,后面的 handler 和 execute() 都会看到修改值。不过修改后不会再次跑 schema validation。这个能力面向受信任的本地 Extension,不应该误解成 Runtime 自动提供的权限系统。
还有一个偏安全的细节:tool_call handler 如果抛错,Coding Agent 会阻断执行,而不是忽略 Extension 故障后继续碰环境。
到 execute(),本地副作用才真正发生
通过前置阶段后,executePreparedToolCall() 才调用:
prepared.tool.execute(prepared.toolCall.id,prepared.args,signal,onUpdate,);
read 的 execute() 会解析相对或绝对路径,检查可读性,再调用 fs/promises.readFile()。文本支持从 1 开始的 offset 与 limit,默认从文件头返回,并受行数和字节数上限约束;文件太大时,结果会告诉模型从哪个 offset 继续。图片则会处理成 image content,供支持视觉输入的模型使用。
也就是说,从模型视角看,它“读了文件”;从操作系统视角看,是本地 Node.js 进程用自身权限打开了文件。
bash 为什么不只是 exec(command)
bash 的 schema 很小:必填 command,可选 timeout。真正的实现却要处理 Coding Agent 才会遇到的问题。
createLocalBashOperations() 先解析当前平台的 shell 配置,再通过 child_process.spawn() 创建子进程。stdout 和 stderr 都进入同一个 output accumulator;AbortSignal 会触发进程树终止;可选 timeout 到期也会杀进程。默认没有超时,除非调用参数给出。
输出不能无限塞回上下文。当前实现保留最后一段输出,因为编译器和测试命令最有用的错误经常出现在尾部。超出行数或字节限制时,完整输出会写入临时文件,返回文本附上路径。这比静默截断好得多:模型至少知道自己看到的不是完整日志,也有机会继续读取原始输出。
非零 exit code 会让工具抛错,已有 stdout/stderr 和 Command exited with code N 一起进入错误文本。这里“抛错”不是让进程崩溃,而是在 Tool contract 中标记执行失败,交给 Agent Core 统一包装。
文件修改还多了一层并发保护
write 很直接:创建父目录,然后创建或覆盖整个文件。edit 更保守:每个 oldText 必须在原文件中唯一,多项 edit 必须互不重叠,而且都基于同一份原始内容匹配。任一 edit 失败,不应只写入前半批修改。
但 Agent Core 默认允许一条 assistant message 中的多个工具并行执行。如果模型同时发出两个针对同一文件的 edit,两个执行器都先读旧内容,再各自覆盖,后完成的那个可能吞掉前一个结果。
Pi 没有因此把所有工具全改成串行。edit 和 write 进入 withFileMutationQueue(),按解析后的文件路径排队:同一个文件的 mutation 串行,不同文件仍可以并行。能解析到同一 realpath 的符号链接别名也共用 queue。
这个设计处理的是很具体的竞争,而不是泛泛追求“线程安全”。粒度太大,多个独立文件修改会白白等待;粒度太小,同文件会丢更新。按文件路径串行是两者之间的折中。
Tool Result 为什么必须回到模型?
工具成功后返回 AgentToolResult;工具抛错后,Agent Core 也会创建一个 error result。可选的 afterToolCall 随后运行,Coding Agent 用它接 tool_result Extension event,并在结果写入 transcript 前规范化图片。
createToolResultMessage() 最终组装的消息包含:
role: ”toolResult”toolCallId: ”call_42”toolName: ”read”content: [...]isError: falsetimestamp: ...
还可能有 details、usage 和动态工具信息。content 是模型下一次判断最需要的反馈,details 更适合 UI、日志与 Session 使用,不能假设每个 Provider 都会把内部 details 原样发送给模型。
toolCallId 则负责配对。一次 assistant response 可以同时请求多个工具,光看 toolName 不足以判断哪个结果对应哪次调用。
Loop 把 ToolResultMessage 追加进 currentContext.messages,下一次模型请求就会包含:
AssistantMessage(tool call: call_42)ToolResultMessage(toolCallId: call_42, file content)
没有这一步,工具只是在本地打印了一段日志,模型依然不知道文件内容,更不可能据此决定下一步 edit。Tool Result 是 Agent 反馈闭环中的正式消息,不是 UI 附件。
错误同样如此。路径写错、oldText 不唯一、测试退出码非零,都可能是可恢复的中间状态。把失败明确标成 isError: true 再回灌,模型可以换路径、缩小匹配范围或分析测试输出。若遇到模型输出被 token limit 截断且其中带 tool call,Pi 更进一步:整批调用都不会执行,而是生成错误结果,让模型重新发出完整参数。一个被截断但碰巧还能解析的路径或命令,不值得冒险执行。
Schema validation 不是 sandbox
到这里必须把安全边界说清楚。
Pi 的官方安全文档明确写着:没有内置 sandbox。Built-in tools 和 Extensions 都以启动 Pi 的本地用户权限运行。read、edit、write 的路径可以是相对路径,也可以是绝对路径;默认实现不会自动把访问锁死在 cwd 内。bash 启动的也是普通本地 shell。
所以至少要区分三层:
tool_call | ||
Pi 的取舍很直接:它是本地 coding harness,要调用真实工具链,也不把一个残缺的进程内限制包装成可靠安全边界。代价是用户必须知道它拥有多大权限。对不可信仓库、无人值守任务,或你不准备持续观察的生成代码,应该把整个 Pi 或工具执行放进 container、VM、micro-VM 或 policy-controlled sandbox,只挂载任务真正需要的目录和凭据。
这也解释了 Tool schema 为什么必要却不充分。它能拦住 { timeout: "abc" },拦不住 { command: "合法但危险的命令" }。
如果自己写一个最小版本
下面是教学化简版本,不是 Pi 的真实实现。它省略了 Provider streaming、并行批次、Extension hooks、abort、参数 coercion、输出截断和事件:
async function executeCall(call: ToolCall): Promise {const tool = activeTools.get(call.name);if (!tool) {return errorResult(call, `Tool ${call.name} not found`);}try {const args = validate(tool.parameters, call.arguments);const result = await tool.execute(call.id, args);return {role: ”toolResult”,toolCallId: call.id,toolName: call.name,content: result.content,isError: false,timestamp: Date.now(),};} catch (error) {return errorResult(call, String(error));}}
这个版本已经保留了不可再删的边界:只从 active registry 查找、本地校验不可信参数、由宿主执行、错误也返回 correlated result。
如果继续做成真正的 Coding Agent,我会按风险依次补:取消与超时、危险操作策略、输出上限、同资源并发控制、事件与审计。至于漂亮的 TUI renderer,可以晚一点;它不会改变执行边界。
本篇总结
模型产生的是 ToolCall数据,真正的文件与 Shell 操作由本地 Pi 进程执行。当前默认 active tools 是 read、bash、edit、write;Runtime 只按名字查找 active tools。同一份 schema 既描述模型可调用的参数,也用于本地 validation;工具错误会变成 isError: true的结果回到模型。Agent Core 管调用协议,Coding Agent tools 管 fs/spawn副作用;edit和write还按文件路径串行 mutation。Schema 不是权限边界。Pi 默认没有内置 sandbox,真正隔离要靠可信策略层与 OS/container/VM。