ARTICLE · 999040
接口文档写不好,联调两行泪(高级篇):上线之后,性能测试与分组压缩
接口文档写不好,联调两行泪(高级篇):上线之后,性能测试与分组压缩
摘要:基础篇解决"文档怎么写得像样",进阶篇解决"文档怎么活得长久",高级篇解决"文档怎么扛得住"。接口一多,文档就慢——性能测试、接口分组、分组压缩三板斧,让文档扛过生产流量。
"文档比接口还慢。"
测试同学丢过来一句吐槽的时候,我是不信的。直到打开 Swagger 页面——300 多个接口平铺在一个列表里,页面转了快 10 秒才出来,翻到"订单"模块要再等两秒。
那一刻我意识到:文档也是生产服务。接口多了、流量大了、文档大了,它一样会卡、会慢、会拖垮体验。今天这篇高级篇,聊三件事:怎么测文档服务的性能、接口多怎么分组、分组之后怎么压缩。这是系列最后一篇——基础篇让文档"能用",进阶篇让文档"长寿",本篇让文档"扛得住"。
1. 性能指标速览:QPS / P95 / P99 怎么看
聊性能,先统一语言。六个核心指标,一张表说清:
| P99 决定最差体验 | ||
P99 比平均值重要得多。"平均延迟 100ms"这句话可能藏着 10% 的请求要 2 秒——而那 10% 的用户体验,决定团队口碑。看报告时先看 P99,再看错误率,最后才是均值。
还有一个容易忽略的步骤:压测前先定合格线。没有目标的压测只是"跑个数据"。用 SLO(服务目标)说话:比如"P99 < 300ms,可用性 99.9%",再用 Apdex 指数(用户满意度评分,0.94 以上算优)量化"用户是否满意"。目标定了,压测结果才有对错。
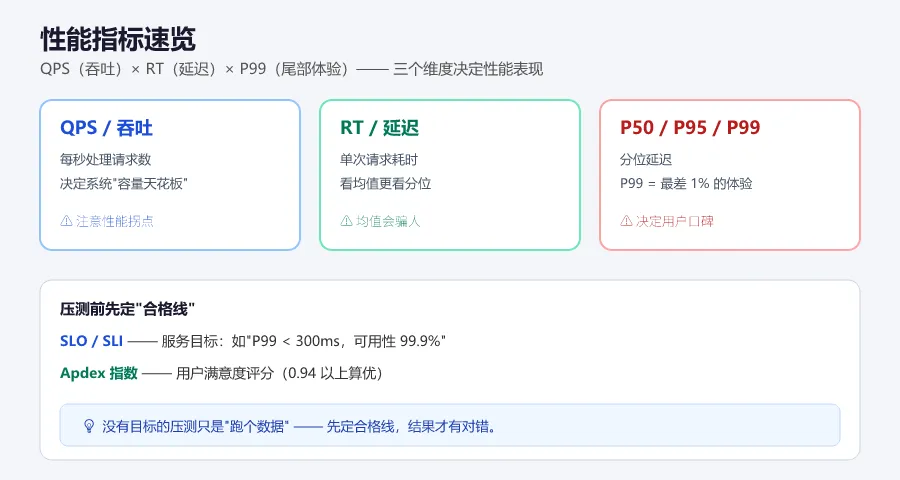
📷 图 1|性能指标关系图:QPS(吞吐)× RT(延迟)× P99(尾部体验)三个维度共同决定性能表现;P99 决定最差体验,错误率决定生死。压测前先定 SLO/Apdex 合格线。
2. 文档为什么慢:大文档膨胀链路
文档变慢,通常不是某一环的锅,而是一条链路层层放大:
接口数量 ↑ → OpenAPI JSON 体积 ↑ → UI 全量拉取 ↓ ↓ 渲染卡顿 / 弱网超时 / 服务端序列化耗时 ↑500 个接口 + 复杂 schema,生成的 OpenAPI JSON 轻松超过 2MB。Swagger UI 每次打开都要全量拉取这份 JSON 再渲染——首屏 10 秒就是这么来的。如果文档还做了服务化(进阶篇的 Redis 锁场景),生成、缓存、分发每个环节都在叠加开销。
有个体感数据值得记住:2MB 的 JSON,在 4G 网络下裸传约 1.5 秒;gzip 后约 400KB,传输缩到 300ms;如果只返回一个分组……后面第 4 节讲。
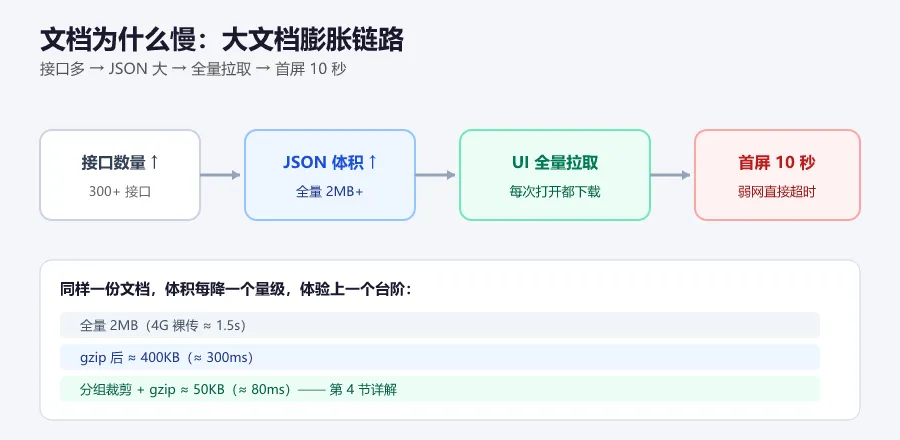
📷 图 2|文档加载链路:浏览器 → CDN → 文档服务 → 全量 JSON(2MB+)。体积每减一个量级,加载时间就上一个台阶——优化的杠杆就在"体积"上。
3. 分组机制:接口多,拆开管理
优化体积的第一步不是压缩,是分组——因为分组是后面一切优化的前提。
OpenAPI 的 tags 本来就是按业务模块分组的字段,大多数团队却没用起来:300 个接口平铺,导航靠滚轮。分组带来的三个收益:
导航清晰:前端/测试按模块找接口,不用翻全量列表 权限隔离:不同团队只看自己负责的分组(配合裁剪实现) 按需加载:只加载当前分组 → 这正是压缩的前提
分组粒度建议:单组接口数 ≤ 30。组太大,"大组"又变回"大全量",分组就失去了意义。
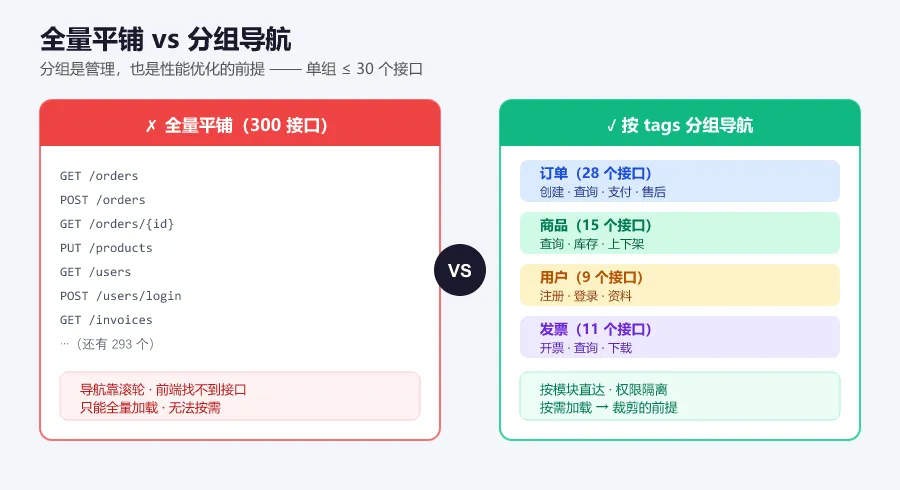
📷 图 3|全量 vs 分组:左边 300 接口平铺(滚轮地狱),右边按订单/商品/用户分组(导航清晰)。分组是管理,也是性能优化的前提。
4. 分组压缩三板斧【核心章节】
分组之后,三招把文档体积打下来:
第一板斧:gzip / brotli(HTTP 层压缩)
最便宜的一招——Nginx 加两行配置,JSON 文本压缩率 70%~85%:
gzipon;gzip_types application/json application/yaml;gzip_min_length1k; # 小于 1k 不值得压# brotli(需模块 + HTTPS + 现代浏览器,压缩率更高)brotlion;brotli_types application/json application/yaml;注意
gzip_min_length:小 JSON 压缩的开销可能大于收益,设个阈值。
第二板斧:JSON 裁剪(Slicing,内容层压缩)
gzip 只压缩"传输",不减少"内容"。真正把 2MB 打成 200KB 的是按分组裁剪——只返回调用方需要的分组。
defslice_openapi_by_tag(doc: dict, tag: str) -> dict:"""按 tags 裁剪 OpenAPI 文档,保留引用链""" paths = {p: ops for p, ops in doc["paths"].items()if tag in {o.get("tags", [""])[0] for o in ops.values()ifisinstance(o, dict)}} refs = collect_refs(paths, doc["components"]) # $ref 传递闭包return {"openapi": doc["openapi"], "info": doc["info"],"paths": paths,"components": {"schemas": refs}, # 只保留被引用的模型 }裁剪边界(最容易翻车的三处):
$ref 传递闭包:订单引用商品、商品引用分类——裁剪"订单"时,商品、分类都要带上,否则前端拿到残文档。引用链要算传递闭包,不是只取一层。 跨组共享 schema:公共模型(如 ApiResponse、分页结构)建议单独维护一份,各组裁剪时都保留。预生成 vs 动态裁剪:动态裁剪灵活但每次请求都要算;预生成分组文档(构建时按组生成好)性能最好——多实例生成时,正好复用进阶篇的 Redis 分布式锁防并发覆盖。
第三板斧:缓存(体验层压缩)
同样的文档,别让每个用户都重新生成一遍:
CDN:静态文档放 CDN,边缘节点直接命中 ETag / Cache-Control:配合 If-None-Match做条件请求,文档没变就返回 304Redis 缓存:文档服务化场景,生成一次、缓存多次
⚠️ 缓存一致性是这里最大的坑:接口改了文档不更新,比"文档慢"更致命。方案:文档版本号变化 → 主动失效缓存 → CDN purge,别依赖"等它自己过期"。
三层叠加的效果,一张表看明白:
| ~80ms |
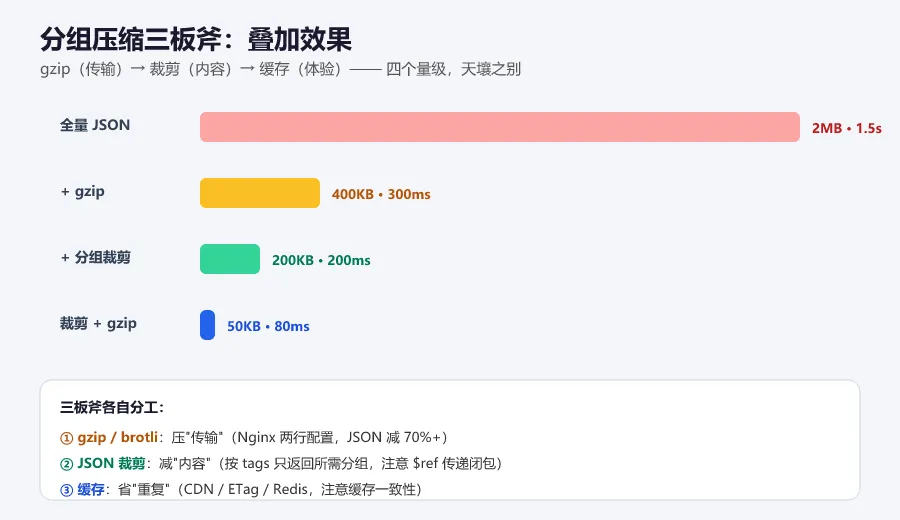
📷 图 4|压缩三板斧叠加效果:全量 2MB/1.5s → gzip 400KB/300ms → 裁剪 200KB/200ms → 裁剪+gzip 50KB/80ms。四个量级,体验天壤之别。
金句:压缩不是技巧,是文档对带宽的尊重。
5. 压测实战:工具选型与场景设计
优化做完,要证明有效——上压测。
工具怎么选,看团队和技术栈:
一条 wrk 命令就能摸底:
# 并发 100,压 30 秒,测 swagger.json 接口wrk -t8 -c100 -d30s --latency https://api.example.com/v3/api-docsk6 更适合进 CI(脚本 + 阈值断言):
import http from'k6/http';import { check } from'k6';exportconst options = {stages: [{ duration: '1m', target: 200 }], // 1 分钟内爬到 200 并发thresholds: {http_req_duration: ['p(99)<300'], // P99 必须小于 300ms },};exportdefaultfunction () {const res = http.get('https://api.example.com/v3/api-docs?tag=orders');check(res, { 'status 200': (r) => r.status === 200 });}压测场景设计(比工具更重要):别只压一个接口,按真实使用方式设计:
swagger.json 全量接口,测基线 | |
?tag=orders 裁剪接口,对比优化效果 | |
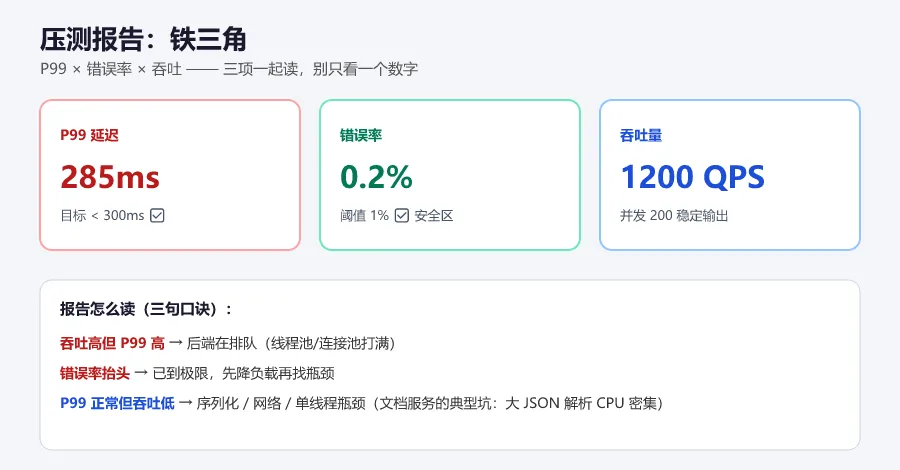
📷 图 5|压测报告样例:P99、错误率、吞吐量三项是报告的"铁三角";吞吐高但 P99 高 = 后端排队;错误率抬头 = 已到极限。
金句:压测不是证明"够用",是找到"哪里会挂"。
6. 优化闭环:瓶颈定位 → 优化 → 回归
压测报告出来,怎么读、怎么改?三步闭环:
读报告:P99 高 = 后端处理慢?吞吐低 = 网络或序列化瓶颈?错误率抬头 = 接近上限? 定位瓶颈:火焰图 + CPU profiling 找热点。特别提醒文档服务的坑——大 JSON 的序列化/反序列化是 CPU 密集,2MB JSON 每次解析都是实打实的 CPU 开销,往往瓶颈不在业务代码,在序列化。 优化回归:改一处压一次,数据说话。再把压测接进 CI 做性能回归门禁:P99 相对基线恶化超过 10% 就阻断合并——性能问题和 bug 一样,要堵在合并前。
7. 发布后监控:测完不算完
压测是"体检",发布后的监控是"24 小时心电监护"。测完就撒手,优化效果没人验证,等于白测。
用 Prometheus + Grafana 给文档服务建一套看板:
指标:QPS、P99、错误率、缓存命中率 告警阈值:P99 > 500ms、错误率 > 1%、缓存命中率 < 80% 触发告警 监控对象:swagger.json 接口、Swagger UI 页面、分组裁剪接口、缓存层
一条告警规则示例:
groups:-name:docs-servicerules:-alert:DocsP99Highexpr:histogram_quantile(0.99,sum(rate(docs_http_duration_bucket[5m]))by(le))>0.5for:5mlabels: { severity:warning }annotations: { summary:"文档服务 P99 超过 500ms" }至此闭环成立:压测发现上限 → 上线后监控确认实际表现 → 数据反哺下一轮优化。文档服务从此不是"黑盒",而是可观测的生产组件。
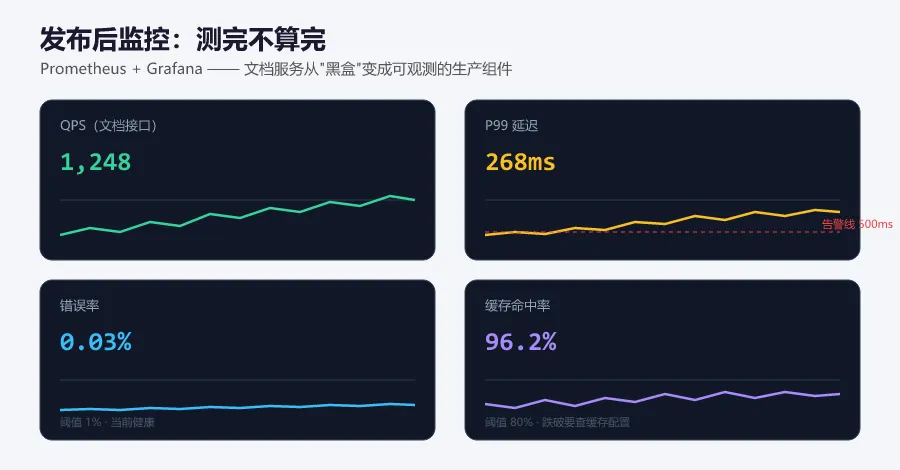
📷 图 6|监控看板:QPS / P99 / 错误率 / 缓存命中率四块面板;命中率跌破 80% 往往意味着缓存配置出问题——这个指标最容易被忽略。
附:避坑清单(收藏这条)
❌ 只测接口不测页面 → Swagger UI 渲染也是性能的一部分 ❌ 裁剪后 $ref 断裂 → 前端拿到的是残文档 ❌ 缓存策略写死 → 接口改了文档不更新 ❌ 压缩开销大于收益 → 小 JSON 不值得 gzip ❌ 压测环境与生产差异大 → CPU/网络配置不同,数据失真 ❌ 全 200 就以为没问题 → 不看 P99 和错误率 ❌ 测完就撒手 → 发布后不监控,优化效果无人验证
金句:文档也是生产服务,流量来了不等人。
写在最后
三篇连载到这里收官:
基础篇:让文档"能用"——规范选型、参数、模型、错误码 进阶篇:让文档"长寿"——CI 校验、版本管控、Redis 锁 高级篇:让文档"扛得住"——性能测试、分组、压缩、监控
从"写得好"到"活得久"到"扛得住",一条完整的文档工程链路。文档从来不是"生成的副产品",而是需要像产品一样运营的生产服务。
互动一下:你压测过自己的文档服务吗?遇到最离谱的性能问题是什么?评论区聊聊。
关注后回复 "swagger",领取《性能测试模板 + 压测脚本》下载链接(含 wrk/k6 命令、SLO 模板、Prometheus 告警规则)。
系列预告:番外篇《接口文档永不脱节:契约测试实战》——用 Schemathesis 和 Pact,让文档和代码在测试层面强制同步。
点赞 / 在看 / 转发,让文档工程化卷起来。