ARTICLE · 1000958
AI 测试必知 4 大核心技术:Function Calling、Skills、MCP、RAG 一次讲透(建议收藏)
如果你想入行AI测试,面对满屏的“Function Calling”“MCP”“Skills”等一头雾水,这篇文章就是为你准备的。不需要机器学习背景,只要懂一点接口测试和Python,就能看懂80%。
很多测试工程师第一次接触AI项目时,最懵的不是“模型准不准”,而是——这些新名词到底是什么?它们和传统测试有什么关系?我该测什么?
今天我用最直白的话,把AI测试中最核心的四个基础技术讲清楚:Function Calling、Skills、MCP、RAG。每个都从“是什么、怎么工作、测试关注点”三个角度展开,看完你就能和算法、开发平等对话。
一、Function Calling:让大模型“会调用工具”的开关
1. 它解决什么问题?
传统大模型(比如早期的ChatGPT)只能“说人话”,不能“办人事”。你问它“今天北京天气怎么样”,它要么瞎编,要么说“我没有实时数据”。
Function Calling(函数调用)就是给大模型装上一双手——当它判断需要外部工具时,会输出一个结构化的“调用请求”,而不是直接回答。开发拿到这个请求去执行真实函数(查天气API、查数据库、发邮件),再把结果喂回给模型,模型最终生成自然语言回复。
2. 技术原理
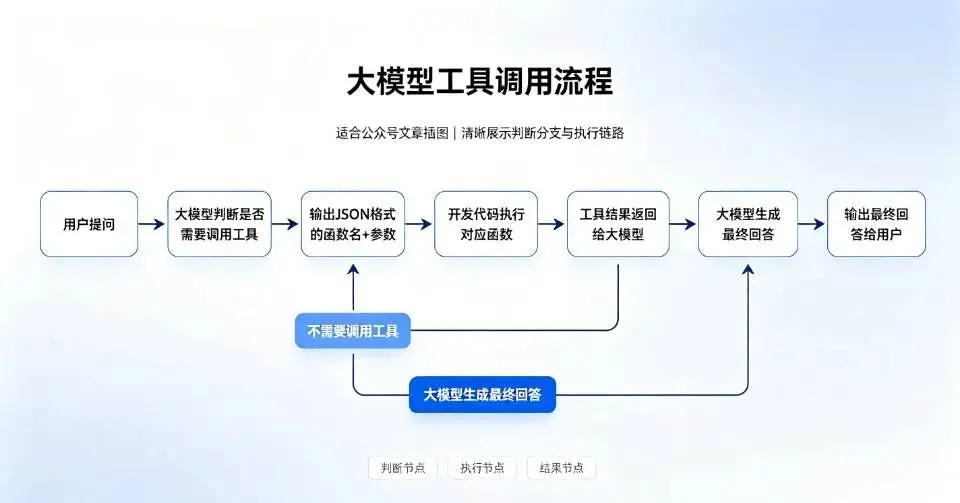
关键点:模型本身不执行函数,它只负责“说要调哪个函数、传什么参数”。真正执行的是你的后端代码。
3. 测试工程师要关注什么?
·①参数准确性:模型提取的参数对不对?比如“帮我订明天下午3点的会议室”,它输出{"time": "2026-09-05T15:00:00"},时区、格式、字段名是否与函数定义一致?
·②边界与异常:用户说“订个会议室”但没说时间,模型是输出缺参错误还是瞎填一个默认值?
· ③工具选择:有多个相似函数时(比如查天气有get_weather_by_city和get_weather_by_coords),模型选对了吗?
· ④安全:模型会不会调用不该调的函数?比如用户说“帮我删库”,它真的输出drop_database()?
一句话总结:Function Calling 测试的核心是验证“模型意图→结构化指令”的准确性,类似传统测试里的“接口参数校验”,但输入是自然语言。
二、Skills:把提示词、工具、流程打包成“技能包”
1. Skills是什么?
你可以把Skill理解成一个可复用的AI能力单元。比如“客服工单处理”这个Skill,里面包含了:
① 一段系统提示词(告诉模型你的角色和规则)
②若干可调用的Function(查工单、改状态、发通知)
③固定的执行流程(先查工单→判断类型→决定是否转人工)
用户或开发者只需说“用客服工单Skill处理这条消息”,大模型就会按照Skill里定义好的逻辑自动执行,不需要每次重新写提示词。
2. 它的本质和流程
本质:把“提示词工程 + Function Calling + 流程编排”打包成一个模块,降低使用门槛,提高一致性。
典型流程:
①加载Skill定义(提示词、可用工具、步骤)
②用户输入触发Skill
③模型按照Skill内的指令逐步决策,调用工具
④输出最终结果
3. 测试关注点
·① Skill激活条件:什么情况下应该触发这个Skill?会不会误触发?
· ②流程分支:如果工单类型是“退款”,流程和“换货”不同,模型能否走对分支?
·③ 工具组合:Skill内部调用了多个Function,它们之间的数据传递是否正确?例如查工单返回的order_id能否正确传给“申请退款”函数?
· ④稳定性:同一个输入多次执行,结果是否一致?Skill的提示词是否容易被用户“越狱”绕过规则?
测试心得:Skills很像传统测试里的“业务流程测试”,只不过执行者从代码变成了大模型。你需要设计多分支的测试用例,覆盖正常流、异常流、边界流。
三、MCP:AI世界的“USB接口标准”
1. MCP是什么?为什么最近这么火?
MCP(Model Context Protocol,模型上下文协议)是Anthropic提出的一个开放协议,目标是让大模型能统一、安全地连接各种外部工具和数据源。
在MCP出现之前,每个大模型应用都要自己写对接代码:接数据库要写SQL连接器,接文件系统要写文件读取器,接浏览器要写自动化脚本……每个工具都要单独适配,重复造轮子。
MCP定义了一套标准接口,就像USB:任何工具只要按照MCP协议封装成“MCP Server”,任何支持MCP的AI应用(Client)都能即插即用。
2. 怎么理解它的架构?
三个角色:
· MCP Host:AI应用,比如Claude Desktop、Cursor、自研的聊天机器人
· MCP Client:Host内部的连接器,负责和Server通信
· MCP Server:封装具体工具的服务,比如一个“GitHub MCP Server”提供创建Issue、查代码等能力
工作流程:
①用户在Host里提问:“帮我在GitHub上创建一个Issue,标题为XXX”
②Host通过MCP Client发现可用的GitHub Server及其工具列表
③模型决定调用create_issue工具,生成参数
④ MCP Client把请求发给GitHub Server,Server执行真实API调用
⑤结果返回给模型,生成回答
3. 测试工程师怎么测MCP?
· ①连接与发现:Host能否正确发现所有注册的MCP Server?工具列表是否完整?
· ②权限控制:模型能否调用它不该调的工具?比如只读场景下,模型试图调用“删除文件”工具,是否被拦截?
·③ 参数传递:模型生成的参数是否符合MCP工具定义的schema?比如create_issue需要repo、title、body,模型是否都传对了?
· ④异常处理:如果MCP Server宕机、超时、返回错误码,Host的表现是什么?模型是重试、报错还是瞎编一个结果?
·⑤ 多工具协作:一个任务需要调用多个MCP Server(比如先查数据库再发邮件),数据传递和顺序是否正确?
核心观点:MCP测试本质上是在测“AI应用与外部工具之间的集成层”,类似传统测试里的接口集成测试,但增加了一层“模型决策”的不确定性。
四、RAG:让模型“开卷考试”而不是“裸考”
1. RAG解决什么问题?
大模型有两个致命问题:
· 知识陈旧:训练数据截止到某个时间点,不知道最新信息
· 幻觉:遇到不知道的问题会一本正经地胡说八道
RAG(Retrieval-Augmented Generation,检索增强生成)的思路是:先检索,再生成。用户提问后,系统先去外部知识库(文档、数据库、网页)检索相关内容,把检索结果拼到提示词里,让模型基于这些材料回答。相当于考试前给你发了一本参考资料,你照着答,不用凭空编。
2. 原理拆解(四点)
①索引(离线):把知识库文档切块 → 用Embedding模型转成向量 → 存入向量数据库
②检索(在线):用户问题转成向量 → 在向量库中找最相似的Top K个文本块
③增强:把检索到的文本块和用户问题一起拼成提示词
④生成:大模型基于增强后的提示词生成回答
【举例】两个关键模型
① Embedding模型:把文字变成数字向量,语义相近的文字向量距离近
② 生成模型:就是ChatGPT这类大模型,负责最终回答
3. 测试工程师必须关注的RAG问题
RAG系统的质量 = 检索质量 × 生成质量。测试点非常多,这里列最核心的:
检索:
· 召回率:知识库里明明有答案,但没被检索到(漏召)——这是RAG最大的坑
· 准确率:检索出来的内容是否真的相关?会不会引入无关噪音导致模型答偏?
· 切片策略:文档怎么切块?切太大可能检索不准,切太小可能丢失上下文。测试时需要验证不同切片参数对效果的影响。
生成:
· 引用准确性:模型回答中引用的内容是否真的来自检索结果?有没有“张冠李戴”?
· 拒答能力:知识库里没有答案时,模型是老实说“不知道”,还是硬编一个?
· 上下文窗口:检索结果太长会不会超出模型token限制?截断策略是否合理?
端到端测试:
· 准备一个有标准答案的测试集(比如公司产品文档的FAQ),对比模型回答与标准答案的语义一致性
· 测试“时效性问题”:昨天刚更新的政策,RAG系统今天能否答对?
· 测试“多跳问题”:需要结合两个文档片段才能回答的问题,系统能否正确串联?
一句话:RAG测试的核心是“检索对不对、生成准不准、引用真不真”。
最后总结:这四个技术的关系与测试地图