ARTICLE · 1000970
学术前沿|教师人工智能素养评估:测量工具的系统性综述
学术前沿
教师人工智能素养评估:测量工具的系统性综述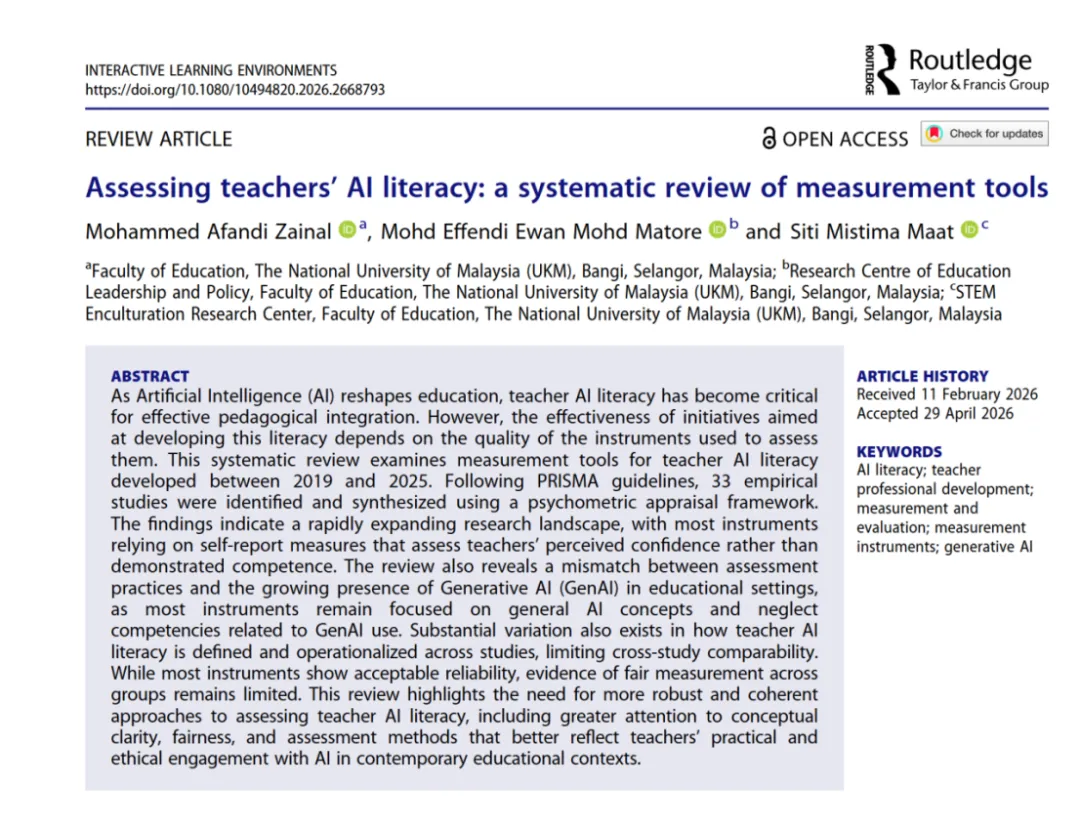
人工智能(Artificial Intelligence,AI)正在重塑教育实践,教师人工智能素养(teachers’ AI literacy)是实现人工智能与教学有效融合的关键基础。教师人工智能素养相关培训项目的成效,高度依赖测评工具的质量。当前学界已经开发出大量教师人工智能素养测量工具,但各类工具的概念界定、测评维度、心理测量学质量参差不齐,缺少对现有测评工具的系统性梳理。本文遵循系统综述与荟萃分析优先报告条目(Preferred Reporting Items for Systematic Reviews and MetaAnalyses,PRISMA)规范,对 20192025 年间发表的 33 项实证研究开展系统综述,借助心理测量评估框架对纳入的测评工具进行批判性分析。研究发现现有绝大多数工具依靠自我报告方式,测量教师主观感知的信心水平,而非可观测的实际能力;测评实践与生成式人工智能(Generative AI,GenAI)课堂应用现实存在脱节,多数工具聚焦通用人工智能概念,缺少生成式人工智能相关能力维度;不同研究对于教师人工智能素养的概念界定与操作化差异较大,降低跨研究之间的可比性;虽然大部分工具拥有可接受的信度,但是跨群体测量公平性证据普遍不足。该综述呼吁学界构建更加严谨、统一的教师人工智能素养测评路径,强化概念清晰度、测量公平性,开发能够真实反映教师在课堂当中实践、伦理层面使用人工智能能力的测评方式。
一、研究的理论基础与概念辨析
(一)教师人工智能素养的内涵
文章沿用 Long 与 Magerko 提出的经典定义:人工智能素养是一套综合能力集合,个体借助该能力批判性评估人工智能系统、与人工智能开展有效沟通协作,并且在多元场景中将人工智能作为工具加以使用。人工智能素养属于多维度构念,超越单纯技术操作技能和传统数字素养,主要包含三大相互交织的组成部分。第一是基础认知知识,涵盖机器学习、算法、数据等基础概念,理解人工智能系统的能力边界;第二是实践程序性技能,能够结合具体目标运用人工智能工具完成教学设计、内容创作、问题解决;第三是批判伦理视角,能够审视人工智能带来的个体与社会风险,包括算法偏见、隐私泄露、透明度与责任归属问题。
落实到教师群体,教师不仅要会利用人工智能辅助教学,还要能够做出教学判断,确定在何种情境下、以何种方式引入人工智能工具;同时要向学生示范负责任使用人工智能,教会学生在人工智能时代开展批判性思考。
(二)易混淆相关构念区分
文献当中经常将人工智能素养与人工智能就绪度(AI readiness)、人工智能胜任力(AI competence)、人工智能教学整合(AI integration)混用,三者和人工智能素养存在明确边界。
1.人工智能就绪度:指向个体或者机构接纳人工智能变革的准备状态,侧重态度、外部支持、主观适应能力,并不代表掌握具体知识技能,属于前置条件。
2.人工智能教学整合:描述把人工智能嵌入教学实践这一行为过程,属于实践行为,不是教师个体内在素养特质。
3.人工智能胜任力:建立在人工智能素养基础之上,素养侧重认知理解,胜任力强调在真实职业情境中实际应用的成效。
4.将不同构念混为一谈会带来严重后果:测评工具标签同为“教师人工智能素养”,实际测量内容却完全不同,造成研究证据碎片化,不利于学术知识积累。
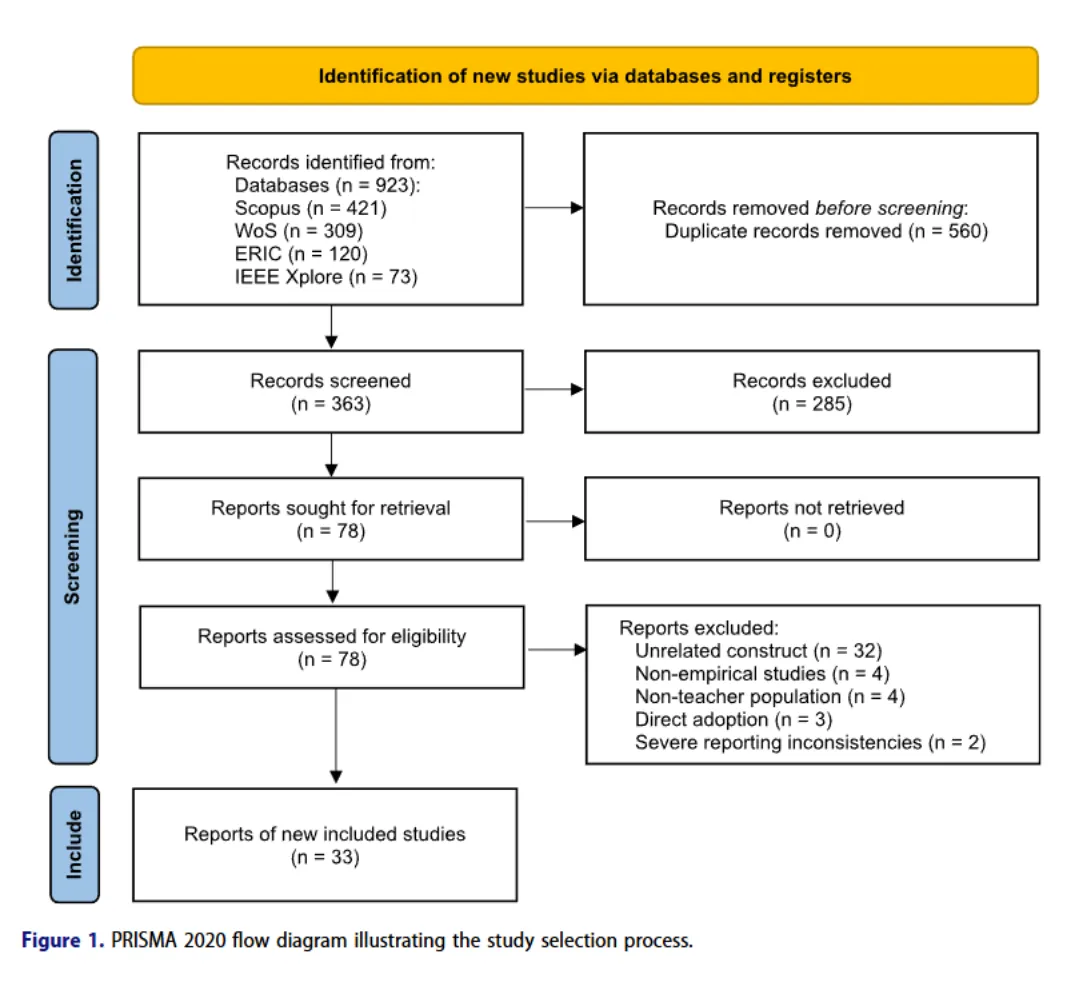
图1 PRISMA2020 研究筛选流程图
初始检索共得到 923 条文献记录,剔除 560 条重复文献,剩余 363 篇进入标题摘要筛选,筛除 285 篇不相关文献,78 篇进入全文评估。全文评估阶段排除 45 篇,最终纳入 33 篇实证研究。全文评审阶段评分一致性百分比 88.5%,Cohen’s kappa 系数\(K=0.80\),说明评审员之间一致性较高。
(三)数据提取与质量评估框架
数据提取分为四大模块:文献基本背景信息、测评工具特征、心理测量学证据、测评面向的人工智能技术范围(区分通用人工智能、生成式人工智能)。两名研究者独立抽取30% 随机样本,遇到分歧引入心理测量专家进行校准,保证编码一致性。
本研究没有直接照搬健康领域广泛使用的 COSMIN 清单,而是采用一套混合式定制评估框架,参考 Terwee 等人标准,结合《教育与心理测试标准》,保留 COSMIN 当中结构效度、内部一致性等核心评估维度。评估维度包含内容效度(Content Validity)、结构效度(Structural Validity)、内部一致性(Internal Consistency)、测量公平性(Fairness)。不输出单一总分,每个维度划分 A(高质量证据)、B(尚可 / 有限证据)、C(证据不足 / 无证据)三个等级,严格设置量化判定矩阵,依据原始研究报告的实证数据打分,没有报告的分析即视为证据缺失。
三、主要研究结果
(一)纳入研究基本概况
从发表时间看:20192021 没有符合条件的测评工具类实证文献;2022 年 2 篇,2023 年 4 篇;2024、2025 合计占全部文献的 81.9%,教师人工智能素养测评属于快速兴起的新兴研究方向。
地域分布呈现高度集中:中国产出 11 篇占比 33.3%,土耳其 5 篇,印度 3 篇;绝大多数为单一国家样本,仅 1 项研究开展多国数据采集。研究对象以在职教师为主(72.7%),职前教师占 27.3%。样本规模跨度很大,200499 份样本占比最高(42.4%),超过 1000 人大型样本仅有 3 项。
(二)测评工具类型与测量维度
1.测评工具形式
33 项研究之中,31 项(93.9%)使用自我报告量表(李克特 Likert 量表),仅有 2 项使用客观知识测试,没有识别出基于表现任务、量规(rubric)的实操测评工具。75.8% 的工具采用 5 点李克特计分,其余使用 6 点、7 点量表;工具条目总数介于 1251 条,平均约 30 题。大部分采用线上问卷平台收集数据。
绝大多数测评工具面向通用人工智能(General AI);只有 4 项 2025 年新开发工具专门针对生成式人工智能素养,关注提示词工程、AI 生成内容甄别等特有能力。
2.反复出现的五大测评维度
(1)人工智能基础知识认知(84.8% 工具包含):测量教师对于人工智能基础概念的知晓程度,自我报告工具主要测主观知晓,少数客观测试测事实性知识。
(2)人工智能教学实践能力(54.5% 工具独立设置维度):一部分研究依托 TPACK(技术 教学 内容知识)理论衍生 AITPACK 框架;另一部分独立设置人工智能教学法维度,关注教学设计、课堂整合。
(3)伦理与社会风险意识(60.6% 工具包含):通用人工智能工具聚焦隐私、算法公平;面向生成式 AI 的新工具拓展到甄别大模型幻觉、鉴别虚假生成内容等高阶评判能力。
(4)实操应用技术能力(42.4% 工具包含):聚焦操作层面技能,例如查找、选用人工智能教学工具。
(5)情感心理与专业发展维度:包含焦虑情绪、使用态度、自我效能感、专业学习支持条件等,反映教师主观心理倾向。
3.心理测量学质量评估结果
(1)内容效度:仅 15.2% 工具达到 A 级,具备专家共识的量化统计指标(CVI、CVR 等);63.6% 仅开展定性专家评审,缺少量化指标,评为 B 级;21.2% 文献没有完整报告条目开发、专家评审过程,评为 C 级。
(2)结构效度:72.7% 工具达到 A 级,通过验证性因子分析、PLSSEM 等得到良好模型拟合;18.2% 仅做探索性因子分析,缺少交叉验证,为 B 级;9.1% 工具缺少因子分析证据,等级为 C。
(3)内部一致性(信度)表现最好:84.8% 工具达到 A 级,克隆巴赫 α(Cronbach’s α)等指标大于 0.70;少数子量表系数不达标,评为 B 或者 C。
(4)测量公平性是最薄弱环节:仅仅 15.2% 的工具开展测量不变性、项目功能差异(DIF)检验拿到 A 级证据;45.5% 属于 B 级;39.4% 完全没有开展跨人口亚群体公平性检验,为 C 级。大量量表直接默认量表在不同性别、教龄、文化背景教师群体中测量效果一致,但没有实证数据支撑。
综合全部四个评估维度,Alqarni(2025)、Chiu 等人(2024)两篇开发的工具四项维度全部取得 A 级,是现有测评工具当中的标杆;另有少数工具在三个维度获得 A 等级。
四、研究讨论与启示
(一)方法论层面启示:过度依赖自我报告带来的效度隐患
当前领域存在明显“方法论单一化” 现象,绝大多数工具依靠教师主观自评。自我报告测量的是主观信心感知,不等于真实胜任水平,容易出现邓宁克鲁格效应(Dunning Kruger effect):对人工智能了解浅薄的教师反而高估自身能力,形成 “能力错觉”。生成式人工智能操作界面简单,仅仅能够输出文本不等于理解模型局限、偏见、幻觉风险。主观问卷容易混淆使用热情和实际专业能力,造成教师人工智能素养整体水平被高估。仅有两套客观知识测验,尚没有情景任务、实操表现类测评工具。未来应当将自评问卷和客观测验、情景任务互相三角验证。
(二)技术层面启示:测评滞后于生成式人工智能现实
2022 年底生成式人工智能已经深度走进课堂,但是绝大多数测评工具仍然围绕传统通用人工智能概念构建,出现 “概念滞后”。通用人工智能素养侧重理论认知;生成式人工智能额外需要提示词设计、甄别虚假生成内容、评估大模型输出可靠性等程序性、判断性技能。传统测评得分较高的教师,未必能够妥善处理大模型幻觉、文本伪造等课堂现实风险,容易输出 “假阳性” 评估结果,掩盖真实培训需求。
(三)构念层面启示:概念碎片化问题
理论文献已经明确教师人工智能素养多维度内涵,但是实证测评工具之间构念标签、维度划分、理论依托差异巨大,同名量表实际测量内容千差万别,阻碍跨研究对比,不利于知识累积。研究并不反对面向特定场景开发差异化工具,而是呼吁研究论文需要更加清晰透明地阐明构念的理论来源与操作化理由。
(四)心理测量学启示:重信度,轻公平性
现有研究普遍重视内部一致性信度,但测量公平性证据严重不足。很多量表在单一同质样本完成验证,直接迁移到不同地域、不同教龄教师群体,没有检验测量不变性。组间分数差异有可能来源于量表本身的测量偏差,而不是教师真实素养差距,如果用来指导培训资源分配,会带来公平风险。未来量表开发应当把测量公平性作为标准化验证必要环节。
五、研究局限、总结与未来展望
该综述存在若干局限:仅检索 4 个数据库,只纳入英文发表文献,中文、土耳其语等本土开发的高质量测评工具有可能被遗漏;排除学位论文等灰色文献;纳入文献以自我报告研究为主,无法充分反映实操测评工具的进展;属于快照式综述,无法收录正在投稿尚未发表的新工具。
总体而言,教师人工智能素养测评是一个高速扩张但是方法论成熟度参差不齐的研究领域。现有测评工具与当代课堂人工智能应用现实匹配度有限。过度依靠自评问卷,只能反映教师主观信心,难以捕捉真实教学、伦理实践能力;测评普遍滞后生成式人工智能的发展;不同工具对于教师人工智能素养概念操作化碎片化;测量公平性检验缺失是普遍短板。
面向未来,教师人工智能素养测评领域需要多方面改进:一是突破单一问卷模式,开发情景任务、实操表现类测评工具,区分主观自我效能和实际能力;二是平衡通用人工智能基础能力与生成式人工智能特有能力,聚焦认识论层面的批判判断能力,而不是绑定某一款特定软件;三是强化测量公平性检验,保障跨群体测评结果可比;四是提升构念的理论透明度,厘清人工智能素养、就绪度、胜任力等相关概念边界。只有测评工具的质量得到保障,教师培训、政策评估、资源分配才能够建立在可靠实证证据之上,真正服务于人工智能时代教师专业发展。
编译者:浙江师范大学比较教育学硕士研究生张洲杭
参考文献:Zainal M A, Matore M E E M, Maat S M. Assessing teachers’ AI literacy: a systematic review of measurement tools[J]. Interactive Learning Environments, 2026: 1-29.
来源链接:https://doi.org/10.1080/10494820.2026.2668793
编辑|张洲杭 李游源
审核|田小红 王超
终审|石亚兵
公众号所有内容版权归浙江省2011卓越教师培养协同创新中心和浙江师范大学教师教育研究所所有,转载注明公众号来源、作者或编译者,申请授权请发送消息至后台,谢谢合作。
约稿或媒体合作事宜,请邮件联系公众号负责人田小红副教授。联系方式: tianxiaohong@zjnu.cn。