ARTICLE · 1002720
告别文档垃圾堆!AI编译式知识库,彻底根治团队知识腐烂
告别文档垃圾堆!AI编译式知识库,彻底根治团队知识腐烂
作者|编程小馆 标签|AI工具 · 知识管理 · 团队协作 · 效率提效
做技术团队、做项目研发的同学,大概率都被同一个问题折磨到崩溃:团队知识永远在流失,文档永远是乱的、旧的、找不到的。
项目越做越大,文档越堆越多:飞书文件夹层层嵌套、群聊文件转瞬刷屏、个人网盘散落各处、Confluence常年停更、本地MD文档遍地开花。
新人入职,翻遍几十份文档依然摸不清业务架构;线上报错,想找历史排障经验全无头绪;会议开完,纪要石沉大海没人复盘;老员工离职,直接带走团队大半核心经验。
传统的知识管理,本质是被动救火:靠人手动整理、手动归类、手动更新,只要一偷懒,知识体系立刻崩塌。
今天给大家拆解一个颠覆性的解决方案——LLM Wiki AI编译式知识库。
它彻底推翻了传统「检索碎片」的老旧模式,用 Compile, don't retrieve(编译而非检索) 的全新理念,把零散的项目资料,自动编译成一套可迭代、可追溯、可互联、永远最新的团队活知识库。
01 为什么传统团队知识管理,注定会烂掉?
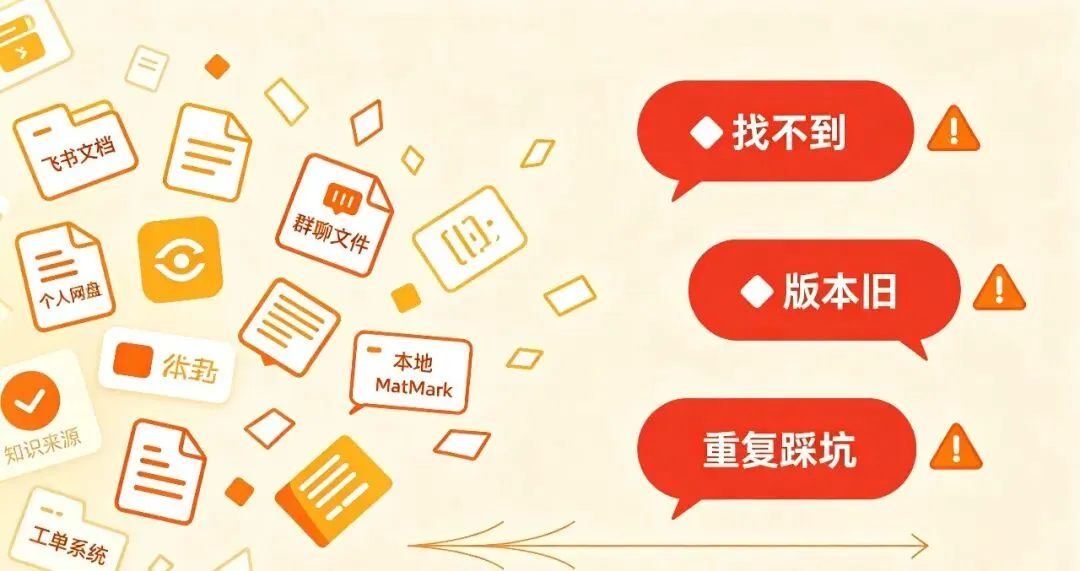
很多团队的知识管理,本质只是「文件堆放」,根本算不上知识沉淀。所有痛点日积月累,最终变成团队效率的无底洞。
❌ 痛点一:文档碎片化,想用永远找不到
知识散落飞书、群聊、个人网盘、本地电脑、工单系统,没有统一入口。明明知道有相关文档,翻半天找不到,找到了也分不清是不是最新版本。大量时间浪费在「找文件、验真伪」上。
❌ 痛点二:经验不沉淀,全员重复踩坑
线上排障记录锁在工单里、会议纪要刷在群聊里、架构方案存在个人电脑里。问题解决完就作废,经验无法留存。新员工重复踩旧坑,老员工反复解决老问题,团队永远在低水平循环。
❌ 痛点三:文档严重滞后,彻底失去可信度
业务迭代飞快:网关从Nginx换成APISIX、新增灰度环境、API接口全面改版,但对应的文档永远停留在旧版本。
久而久之,没人相信文档,大家宁愿口口相传、现场问人,辛苦写的文档彻底沦为摆设。
❌ 痛点四:传统RAG只会「碎片检索」,没有完整认知
很多团队用传统RAG做知识库检索,但它的逻辑是:提问一次、检索一次碎片。
你问一个业务链路问题,它只会返回几句零散的文本片段,没有上下文、没有上下游、没有关联关系,每次查询结果还不一样,根本拼不出完整的业务图景。
❌ 痛点五:个人知识和团队知识彻底割裂
自己用Obsidian整理的优质笔记,团队看不到;飞书团队沉淀的文档,无法自动纳入个人知识体系;多维表格、工单、文档各自独立,无法联动,最终形成「两张皮」,知识无法互通复用。
02 LLM Wiki核心思路:像管理代码一样管理知识
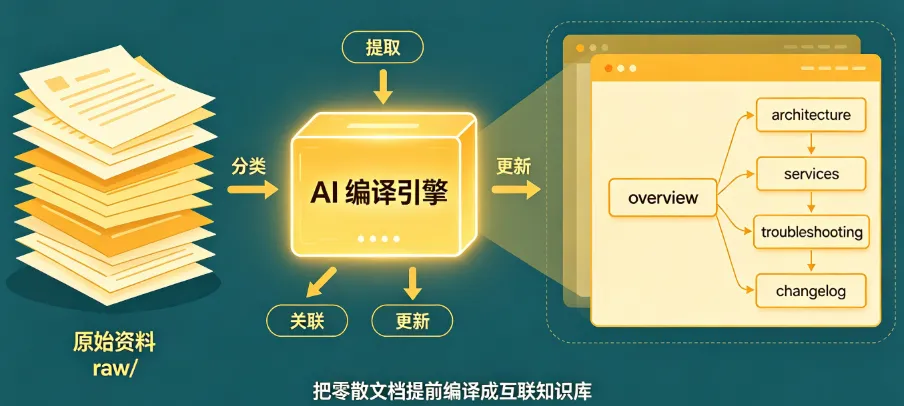
绝大多数知识工具,都是「静态存档」;而LLM Wiki,是动态编译。
它借鉴了Karpathy经典的 Compile, don't retrieve 理念:不要等提问时再临时找碎片,提前把所有零散知识,编译成结构化、可导航、可关联的完整Wiki体系。
简单来说:你只管丢原始资料,AI帮你搞定一切整理工作。
无需手动建目录、无需手动写索引、无需手动更新关联。会议纪要、设计文档、排障工单、飞书文档、本地笔记,全部丢进去,AI自动完成分类、结构化、关联、更新、纠错。
让团队知识告别「越用越废」,实现随时间复利增长。
03 8大核心落地场景,覆盖团队90%知识需求
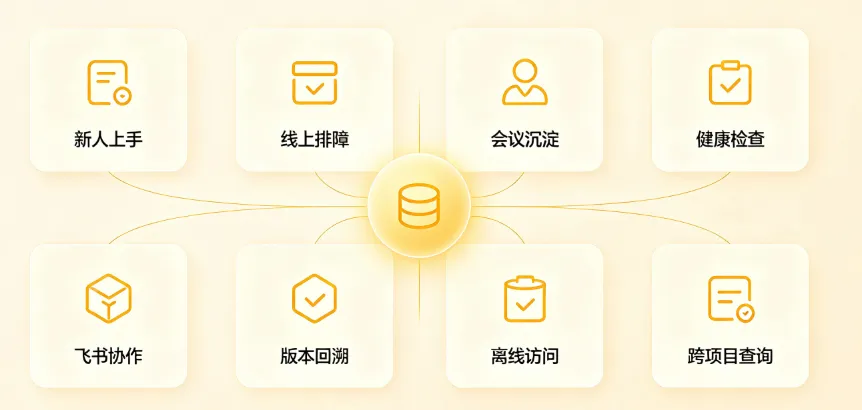
LLM Wiki不是花架子,所有能力都贴合研发团队真实工作场景,落地性极强。
✅ 新人快速上手 新人接手项目,不用挨个找人请教、不用翻几十份零散文档。打开Wiki即可查看完整的业务架构、服务依赖、网关路由、接口说明,大幅缩短上手周期。
✅ 线上快速排障 线上报错无需盲目排查,自动关联历史同类问题、根因分析、解决方案、修复记录,快速定位问题,高效止损。
✅ 会议自动沉淀 会议结束直接丢入纪要,AI自动提取核心决议、待办事项,关联对应服务、架构页面,彻底告别会议开完无沉淀的问题。
✅ 知识库健康自检 定期自动扫描知识库:识别过时文档、缺失的概念说明、页面冲突内容、孤立无效页面,主动提醒维护,保证知识库始终高质量。
✅ 飞书无缝协作 飞书文档自动同步编译,AI整理后的结构化Wiki可反向推送飞书,团队全员可在线浏览、查阅,协作零割裂。
✅ 知识全链路回溯 架构迭代、方案改版、接口更新,所有变更都会留存记录。随时查看「什么时候改的、为什么改、改了哪里」,完整追溯迭代历史。
✅ 离线随时查阅 出差、断网也不影响,本地留存最新知识库,通过Obsidian即可随时打开查阅,不受网络限制。
✅ 跨项目统一查询 针对APISIX网关、公共组件等跨项目复用资源,可一次性查看它在所有项目中的配置、适配规则、使用差异,打破项目知识壁垒。
04 针对性解决5大痛点,彻底重构知识管理模式
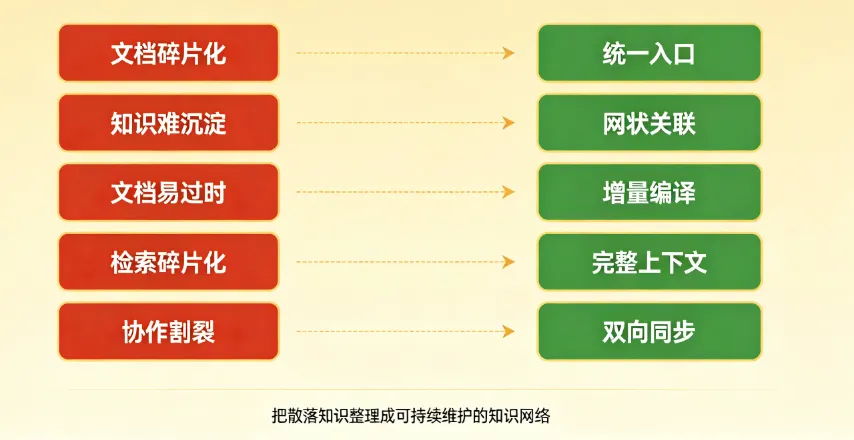
1. 解决文档碎片化:统一入口,一键收纳所有资料
搭建统一的原始资料raw入口,飞书文档、本地文件、网页剪藏、工单记录全部统一收纳。AI自动分类整理、生成全局索引,一个入口输入,一套结构化知识库输出,彻底告别遍地找文档。
2. 解决知识难沉淀:网状关联,让经验活起来
AI自动提取核心概念、生成专属概念词典,识别项目服务、模块、接口信息,建立双向交叉引用。
排障记录绑定对应服务档案、会议决议关联项目变更历史,零散文档变成互联互通的知识网络,经验可永久传承。
3. 解决文档易过时:增量编译,实时更新活知识
通过文件指纹比对,实时检测原始文档变更,触发增量重编译。只更新变动段落、保留人工优质批注、同步更新关联内容和版本日志。
文档不再是一成不变的静态快照,而是持续迭代、实时保鲜的动态知识体系。
4. 解决检索碎片化:先编译后查询,输出完整答案
区别于传统RAG临时检索碎片的模式,LLM Wiki提前编译好完整结构化页面。用户查询时,AI先定位索引页面,再结合完整上下文作答。
答案自带上下游链路、关联页面、背景信息,不再是零散片段,真正读懂业务全貌。
5. 解决协作割裂:飞书双向同步,打通个人与团队
实现飞书与本地知识库双向增量同步:飞书文档自动下载编译,本地优质Wiki自动推送飞书。只同步变更内容,高效不冗余,彻底打通个人笔记和团队协作壁垒。
05 核心架构拆解:三层分离,专业又稳
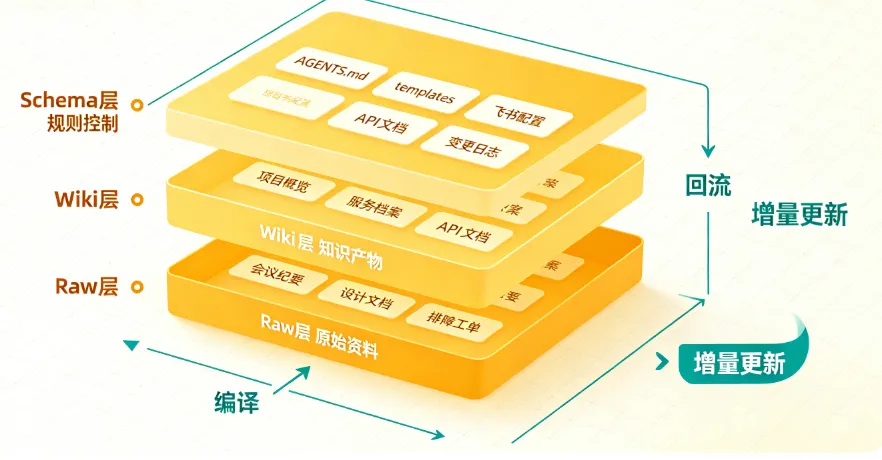
LLM Wiki采用三层分离架构,逻辑清晰、权责明确、可扩展性极强,完全适配企业团队使用。
🔹 Raw层(原始资料层|只读可追溯) 收纳所有原始素材:会议纪要、设计文档、排障工单、飞书同步文档、学习教程等。所有文件只读不修改,保证所有知识有源可溯,杜绝信息失真。
🔹 Wiki层(知识产物层|动态迭代) AI编译后的核心成果,以项目为核心维度,包含架构、服务、API、部署、排障、会议、变更日志等标准化页面,同时支持跨项目共享、专属概念词典、个人学习笔记,体系完整。
🔹 Schema层(规则控制层|人工可控) 由人工定义核心规则:AI编译行为、页面模板样式、飞书同步配置等。人定规则,AI执行,兼顾智能化和规范性,避免AI无序输出。
三大核心操作,撑起全套能力
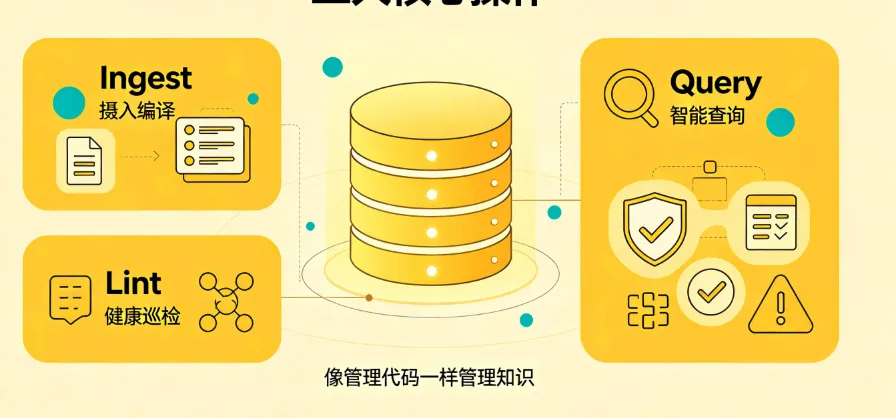
Ingest 摄入编译:类比代码编译,将原始「源码文档」,编译为结构化可查阅的Wiki知识产物。
Query 智能查询:在已编译的完整知识体系中检索作答,自带上下文,精准全面。
Lint 健康巡检:类似代码检测工具,定期扫描知识库问题,自动纠错、预警,维持知识体系健康度。
06 硬核对比:碾压传统知识管理方案
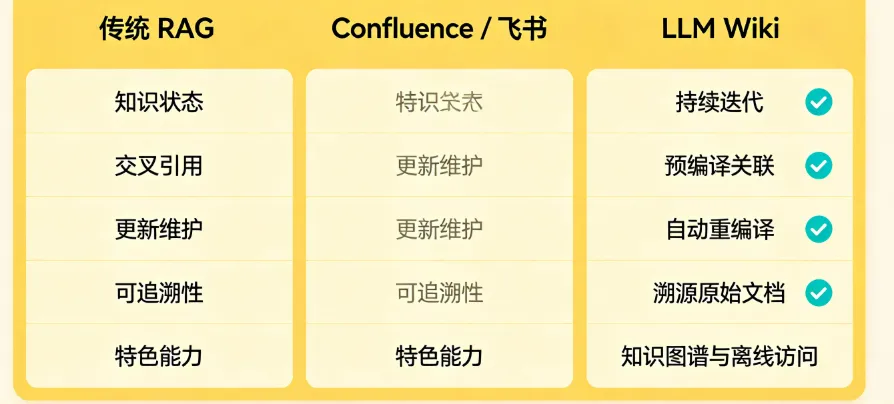
看完对比,就能明白LLM Wiki的颠覆性优势:
✅ 知识状态:传统RAG无状态、临时检索;LLM Wiki有状态、持续迭代复利
✅ 关联能力:传统工具无自动关联;LLM Wiki预编译双向交叉引用
✅ 更新机制:传统方案手动更新、极易过时,LLM Wiki源文件变更自动增量重编译
✅ 可追溯性:传统方案片段引用、信息有损,LLM Wiki溯源原始文档完整版本
✅ 特色能力:独家支持知识矛盾检测、离线本地访问、知识图谱可视化
✅ 部署成本:无需向量数据库、无需复杂部署,依托Markdown+Git,零基础设施成本
07 最后总结:重新定义团队知识管理
传统知识管理:手动整理、被动检索、越用越废。
LLM Wiki知识管理:AI编译、主动维护、复利增长。
用一句极简公式概括全貌:
LLM Wiki = 原始素材 + AI编译引擎 + 结构化知识库 + Git版本追溯 + 飞书双向同步
如果你也受够了团队文档混乱、知识流失、新人难上手、排障效率低下的问题,这套AI编译式知识库,绝对是目前最优解。
让团队每一份经验,都不再白白流失,让知识真正成为团队的核心资产。
往期精选: 👉 颠覆RAG!编译式知识管理,才是AI知识库的终极形态 👉 研发团队效率翻倍指南:从文档堆积到知识沉淀
关注编程小馆,持续分享AI提效、技术架构、团队协作干货,帮技术人少走弯路、高效进阶!
💬 互动:你们团队现在文档管理最大痛点是什么?欢迎评论区聊聊。