ARTICLE · 1003321
循环工程:将AI从助手升级为自主系统
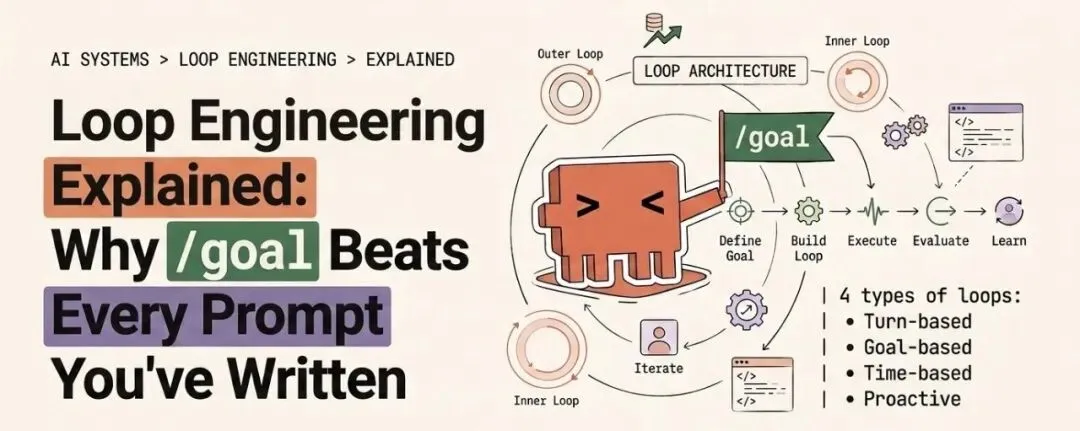
loop engineering 在技术栈中的位置、Claude Code 中的四种 loop 类型、决定这一切是否有效的 evaluator,以及没有人警告过你的四笔账单
用一句话概括:loop engineering 意味着你不再是提示 agent 的人,而是开始构建为你提示它的系统。
它由 trigger 触发运行,在隔离空间中完成工作,由第二个 agent 拒绝不良输出,将发生的事情写入磁盘,并在第二天从停止的地方继续。
本指南涵盖了这个想法的来源、Claude Code 中的四种 loop 类型、如何按顺序构建你的第一个 loop,以及 loop 在你睡觉时向你收费的四种方式。
 60 秒速览
 开篇事实
2026 年 3 月。Andrej Karpathy 向 GitHub 推送了三个文件。它们之间大约有 630 行代码。
一个文件包含模型。一个文件为它评分。一个文件告诉 agent 它可以接触哪个文件。然后他合上了笔记本电脑。
两天后,这个设置已经完成了大约 700 次实验,并为一个他手动调优了二十年的模型发现了 20 项改进。
其中一项是注意力路径中缺失的标量。没有 linter 能捕获这一点。细心的工程师本可以发现,但二十年来没有人做到。
里面的提示词很普通。所有重要的东西都存在于周围的三个文件中:选择下一个实验、运行它、评分、保留更改或回滚、再来一次。
Shopify 的 CEO 在一个内部模型上运行了类似的通宵设置,醒来后发现一个只有一半大小的模型获得了 19% 的质量提升。
人们大约在第 12 次实验左右就会感到无聊。loop 永远不会无聊。
这个术语在一周内就出现了。2026 年 6 月:OpenClaw 的作者 Peter Steinberger 发帖说,你应该设计提示 agent 的 loops,而不是自己提示它们。这篇帖子获得了超过 800 万浏览量。大约同一时间,Anthropic 负责 Claude Code 的 Boris Cherny 说,他现在的工作是编写提示 Claude 并规划下一步行动的 loops。6 月 7 日,Google Chrome 团队工程师 Addy Osmani 把整件事写了下来,并给了它一个流传下来的名字。
三个人,一周时间,彼此之间没有协调。这通常意味着地面已经移动,而每个人都站在上面。
与此同时,你的订阅可能正以 10% 的容量运行。一个窗口、一个任务、一个人坐在那里等待输出完成。
 1/ Loop Engineering 所处的位置
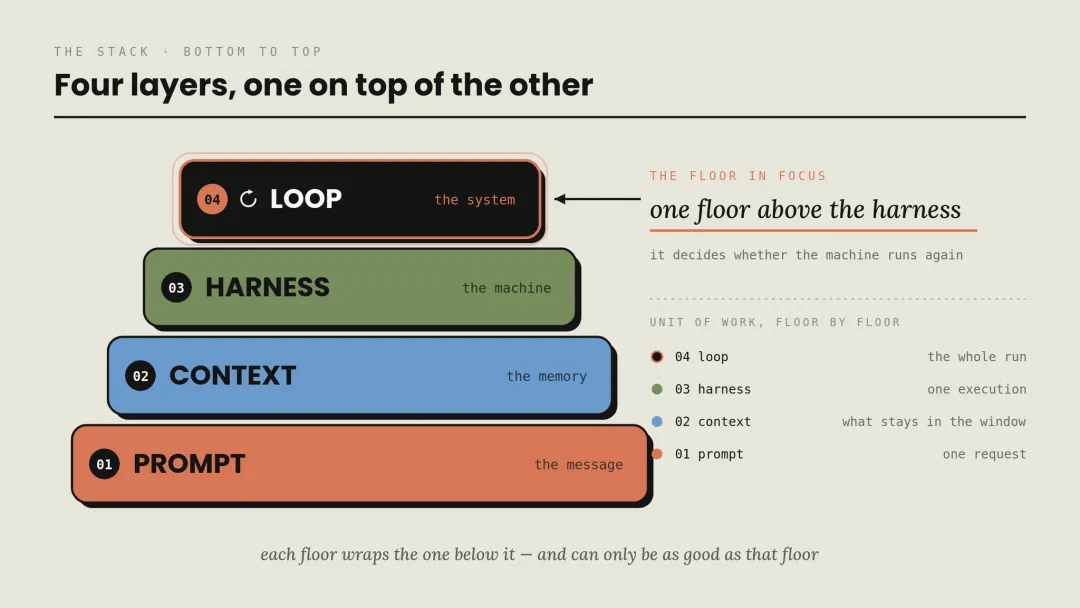
每隔几个月就会出现一个"XX engineering",每个人都翻白眼。但这个词赢得了自己的位置,因为这四个术语是层层叠加的,而不是相互替代。
每上一层,单元就变得更大。一句话、一个窗口、一次运行,然后是一个无需你按时敲击就能持续运行的系统。
前三层假设你坐在键盘前指挥 agent。第四层移除了这个假设。
保持各层分离有一个实际原因:每个层在不同的时间尺度上失效。一个糟糕的提示词几秒钟内就会显现。糟糕的 context 会在答案中显现。糟糕的 harness 会浪费一次运行。糟糕的 loop 会在凌晨 3 点更改代码,将错误输入到下一次运行中,而一周内没有人注意到。
楼层越高,你离现场越远,错误在被人发现之前累积的时间就越长。
 2/ Loop 由什么构成
提示词是一个样本。loop 是一个控制器。
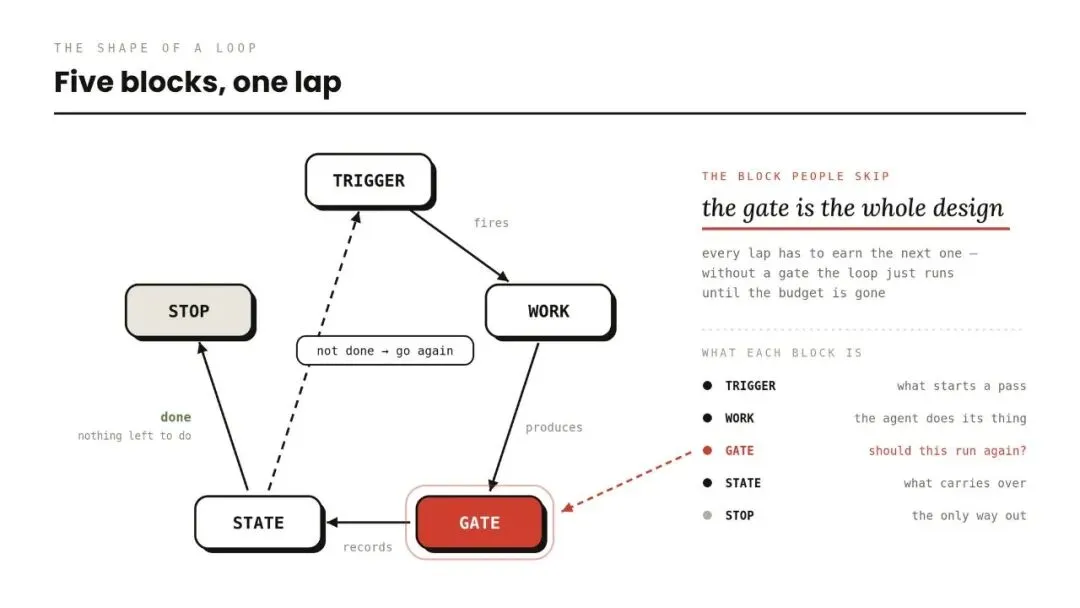
去掉这些词汇,每个有效的 loop 都有相同的五个部分:
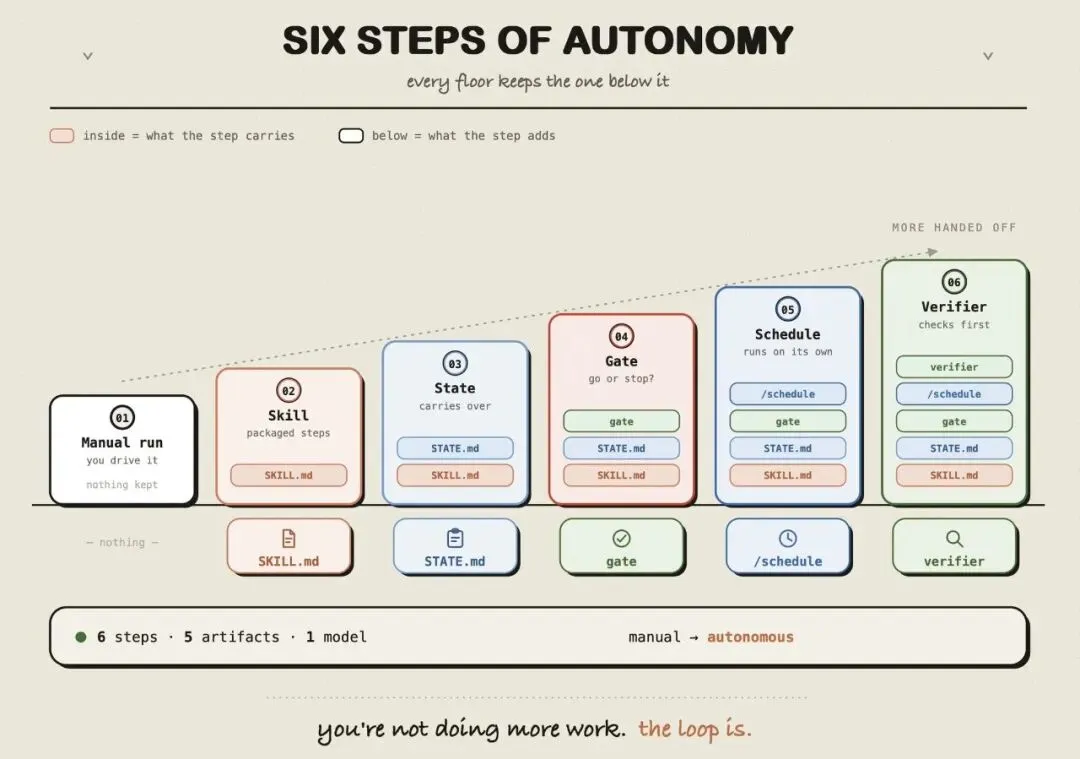
trigger — 启动一次运行的事物。你的消息、时钟、事件、webhook。没有它,你仍然是时钟。 work — agent 收集 context、行动、读取返回的内容。 gate — 某种没有主观偏好、能够拒绝输出的事物。测试套件、构建、类型检查、linter 退出码。没有它,agent 每个周期都会以极大的热情自我审查。 state — 对话之外的一个文件,保存已完成的内容和接下来要做的内容。没有它,明天将从零开始。 stop — 结束运行的条件,外加一个当条件永远不会到来时的硬性上限。没有它,这个东西会一直消耗,直到有人注意到。
真实 loop 的一轮,按顺序:
Discover(发现) — 弄清楚这次运行应该做什么 Hand off(交接) — 将任务交给位于自己隔离工作区中的 agent Verify(验证) — 第二个 agent,使用不同的指令,尝试破坏它 Persist(持久化) — 结果落到磁盘上,而不是聊天中 Schedule(调度) — 设置下一次运行,今天的剩余工作会结转
去掉其中任何一个,这个东西要么停滞不前,要么原地打转,而计费器还在跑。
 3/ Claude Code 中的四种 Loop 类型
Claude Code 团队通过两个问题对 loops 进行分类:什么启动一次运行,什么结束它。答案告诉你应该使用哪个命令。
 Turn-based:改进检查
这是你日常已经在运行的普通 agentic loop。当你把验证写进 SKILL.md 时,它会变得更好,Claude 会像审查者那样检查结果,而不是在成功编辑后就停止。
---name: verify-frontend-changedescription: Verify any UI change end-to-end before calling it done.---1. start the dev server, open the edited page2. click the new control, confirm the state change, screenshot before/after3. browser console: zero new errors or warnings4. run a performance trace, audit Core Web Vitalsif any step fails, fix it and rerun from step 1
这些步骤越可衡量,Claude 就越没有空间说服自己提前完成。
 Goal-based:/goal
/goal get the homepage Lighthouse score to 90 or above, stop after 5 tries
让它发挥作用的是谁来做决定。一个快速的小模型在每一轮后读取对话记录,回答是或否,并返回一行原因,成为下一轮的指导。
值得了解的规则:每个会话一个 goal,新的 goal 会取代旧的。不带参数的 /goal 会显示轮次、tokens 和 evaluator 的上一次原因。/goal clear 结束它。条件可以长达 4,000 个字符,而且它只能判断 Claude 在对话中呈现的内容,因为 evaluator 本身不运行任何东西。
所以"test/auth 中的所有测试都通过并且 lint 步骤干净"可以在二十轮中站得住脚。而"代码看起来干净"在第一轮就会崩溃。
 Time-based:/loop 和 /schedule
/loop 5m check my PR, address review comments, and fix failing CI
/loop 运行在你的机器上。/schedule 将相同的形式移到云端,作为一个合上盖子也能继续运行的 routine。
 Proactive:一切叠加
/schedule every hour: check the project-feedback channel for new bug reports/goal: don't stop until every report found this run is triaged, actioned, andresponded to. when fixing a bug, explore three solutions in parallel worktreesand have a judge adversarially review them.
一个命令,四个原语:云 trigger、明确的终点线、隔离的并行工作区,以及带着全新 context 到达的审查者。
⚠️ 两个人们经常搞混的命令。/loop 按计时器重新运行。/goal 一直运行到条件成立。调度和停止是两件分开的工作,大多数坏掉的 loops 都混淆了它们。
 4/ Evaluator:每个人都会跳过的部分
构建能运行的东西是容易的一半。困难的一半是在其中放置一个能说"不"的东西。
Anthropic 工程师 Prithvi Rajasekaran 在构建长期运行的应用程序时遇到了这个问题:让 agent 评估它自己产生的工作,它会满怀信心地称赞这项工作,即使人类能看出质量平平。
原因在于结构,而不是智力问题。编写代码时的 context 中充满了所有支持那样编写它的理由,所以在重读时,agent 看到的是它自己的推理,而不是结果。写作者也会遇到同样的失败——你重读草稿时,看到的是你脑海中的版本。
在 loop 内部,这个问题会不断累积。作者决定"差不多够了"的每一轮,都是与自己达成一致的一轮。
Rajasekaran 首先尝试了明显的修复方案,推动生成器对自己的输出更加严格。结果很糟糕,而他的结论才是最有用的部分:调优一个独立的怀疑者远比让作者自我批判容易。他采用了 GANs 的形式,一个网络构建,一个挑毛病。
Rajasekaran 正是出于这个原因将他的 evaluator 连接到 Playwright MCP。裁决从"JSX 看起来没问题"变成了"我点击了登录,它导航了,这是截图"。
/goal 将这个想法作为产品原语推出:完成与否由一个新的、没有参与产生工作的模型来决定。银行几十年来一直遵循同样的规则——录入大额转账的人和审批它的人不能是同一个人。
生成器决定了你的 loop 能产生什么。evaluator 决定了它拒绝产生什么。
 5/ 过滤器:任务是否适合 Loop 形态
四个条件必须同时成立。打破一个,loop 就会索取超过它给出的。
任务至少每周重复一次 — 查看你的日历,而不是你的意图。 有东西能够自动拒绝不良输出 — 说出会失败的命令: npm test、tsc、构建。token 预算能承受浪费 — loops 会重试、重读和漫游,所以要假设有些运行不会有任何产出。 agent 拥有高级工具 — 日志、复现环境、运行它所写代码并观察它崩溃的能力。
最先带来回报的 loops 并不光鲜:CI 失败分类、依赖升级 PR、lint-and-fix 流程、不稳定测试复现、覆盖面真实的 issue 转 PR 草稿。
那些激动人心的恰恰是应该保持手动的:架构重写、认证和支付、生产部署、模糊的产品工作,以及任何"完成"需要有人来做判断的事情。
有一句话值得贴在显示器上:当审查能力已经是你的天花板时,loop 会加长队列,而不是缩短它。
 6/ 按顺序构建第一个 Loop
在这里,顺序比工具更重要。跳步前进就是 loops 在所有人睡觉时崩溃的原因。
让一次手动运行变得可靠。 与 Claude 一起手动完成任务,直到结果可重复且乏味。你无法自动化你无法重复的事情。 把那一次运行写成 skill。 约定、构建步骤、你的团队为那个不稳定运行器保留的变通方法。让调度触发一个命名的 skill,而不是一大段粘贴的指令,因为 cron 任务中的指令永远不会被任何人更新,永远不会。 添加一个 state 文件。 STATE.md放在仓库根目录。受版本控制、diff 可读、平平无奇。在它周围加上 gate 和上限。 一个客观检查加上轮次限制。这是 loop 获得失败能力的一步。 然后调度它。 在你还在观察时使用 /loop。一旦你信任它可以无人值守,就使用/schedule。引入一个验证者 subagent。 在 .claude/agents/中的第二个 agent,有自己的指令,最好是不同的模型。
## Loop state · ci-triage### Last run2026-07-28 03:30 UTC · 7 failures classified, 3 fixes drafted, 4 escalated### In progress- claude/fix-auth-token-refresh - tests pass locally, awaiting CI### Escalated to humans- src/billing/refund.ts - failing three ways, root cause unclear### Lessons learned (write here, not in chat)- 2026-07-27: tests/e2e/checkout needs the Stripe webhook secret. skip if missing
记忆随着会话结束而终结。仓库中的文件比它活得更久。context 是 agent 这一轮看到的内容,memory 是在窗口被清除后仍然存在的东西,而两者中只有一个是你能保留的。
对于长时间运行,将 state 文件与一个常设的 VISION.md 配对。STATE.md 保存当前位置,VISION.md 保存目的地,而后者是阻止目标在大约第 47 轮时漂移的东西。
给并行 agents 提供隔离:使用 worktree,这样两个 agent 永远不会写入同一个文件——两个 agent 编辑同一个文件,和两个工程师不沟通就推送到同一行代码一样混乱。让构建者快速且廉价地运行,并把更慢、更严格的模型交给审查者。
 7/ 它实际在哪里运行
"它在你睡觉时运行"这句话被随意使用。本地 loop 在合上盖子的那一刻就会死亡。
从任务出发反向阅读这张表。每分钟观察本地开发服务器只有 /loop 能做到。凌晨 3 点扫描 open issues 并打开 PRs 属于云 routine 或计划任务 GitHub Action,因为笔记本电脑会被带出家门。
本地调度是"趁我在这里多跑几轮"。云调度是"趁我不在的时候运行"。把这两者当成一回事,就是人们吹嘘的一半 loops 在他们离开办公桌的那一刻就停止的原因。
底层是普通的 cron:五个字段、一分钟粒度,CLAUDE_CODE_DISABLE_CRON=1 可以关闭整个东西。
 8/ 两个已经在运行的 Loops
一个人,一个早晨。Osmani 自己的 triage loop 在他醒来之前就苏醒了。一个 triage skill 读取昨天的 CI 失败、open issues 和最近的提交。每一个值得行动的发现都会打开自己隔离的 worktree。
一个 sub-agent 起草修复,第二个 sub-agent 用项目的测试和 skills 攻击它。连接器打开 PR 并更新 ticket,任何模糊的内容都会进入人类的收件箱,state 文件将剩余工作带到明天。
那条链中没有任何环节需要他的手,并且它仍然在判断开始的地方停下来等待人类。
一家公司,每周 1,300 个 PR。Stripe 运行着一个名为 Minions 的内部系统,由工程师 Steve Kaliski 公开描述。每周合并超过 1,300 个 PR,没有人输入代码。你通过在 Slack 中标记机器人或在消息上留下 emoji 来触发它,然后就可以忘记它。
有趣的部分发生在模型醒来之前。一个确定性的编排器首先组装 context——它扫描消息中的链接、拉取 Jira、找到文档、通过 Sourcegraph 和 MCP 搜索相关代码。
只有到那时,agent 才开始编写,一切都已经铺好。在它完成后,一个硬编码的管道运行 linter,agent 无法绕过它。
三件值得从中吸取的事情:
任何规则可以决定的事情永远不会交给概率模型。找到材料是确定性的工作,所以由确定性代码来完成。 可靠性来自约束,而不是模型大小。Minions 是开源工具 Goose 的一个 fork,而不是秘密的前沿模型。 人类并没有离开。那 1,300 个 PR 仍然由工程师审查。他们换了位置,从编写变为审查。

登链社区始于2017年,通过构建高质量内容平台,助力开发者在 AI 时代成为更好的 Builder 。
登链社区网站: learnblockchain.cn Twitter: @UpchainDAO B站: space.bilibili.com/581611011 YouTube: www.youtube.com/@upchain