ARTICLE · 1006919
夯爆了!旧安卓手机变身 7*24 小时私有本地 AI 服务器,随时随地跑大模型
夯爆了!旧安卓手机变身 7*24 小时私有本地 AI 服务器,随时随地跑大模型家里多多少少都会压着几部淘汰下来的安卓旧手机。 卖掉值不了多少钱,扔了又觉得可惜。我之前也折腾过不少玩法:改成监控摄像头、当成离线下载器、挂网盘做备份。折腾一圈,最后还是丢进抽屉落灰。 最近挖到一个挺有意思的项目,一下子给旧安卓机找到了全新出路。 它可以把普通安卓手机,改造成局域网内的本地大模型服务端,对外输出兼容 OpenAI 标准的 API 接口。电脑、NAS、智能家居设备,只要支持填写自定义 API 地址,都可以直接调用手机上面跑的大模型。全程不走公有云,也不需要申请任何密钥,所有数据全部留在自家局域网内。 它到底是什么? 你可以把它理解成专门为安卓设备打造的 Ollama。 玩过 Ollama 的朋友应该清楚,电脑端敲简单命令,就能本地拉起各类大模型。OlliteRT 做的是一模一样的事情,只不过运行载体换成安卓手机。 项目基于谷歌 LiteRT‑LM 推理引擎开发,最早脱胎于谷歌官方的 AI Edge Gallery 示例 Demo,开发者 NightMean 在此基础上二次开发,打磨成完整可用的服务端应用。使用 Kotlin 编写,发布时间不算久,但完成度出乎意料。 实际使用门槛很低,安装好 APK,选好模型下载,点击启动服务,手机就会开放 8000 端口。页面会展示局域网访问地址,格式类似 `http://192.168.x.x:8000/v1` 。把这个地址填入各类客户端,就可以对接本地大模型。 项目核心特色 多模型灵活管理 支持从 HuggingFace 一键拉取模型,既能够从本地存储导入 .litertlm 格式文件与模型清单,也可以通过 JSON 配置文件或者网络链接接入自定义模型源,模型拓展自由度很高。 完整多模态推理能力 对于适配的模型,原生支持图像识别、音频解析、深度思考、流媒体交互,同时附带实验性的工具调用能力,可玩性更强。 内置硬件基准跑分 App 自带性能测试工具,可以直接在手机上完成不同模型的跑分对比,帮你快速筛选出最适配本机硬件的大模型,避免盲目下载重型模型。 完整可检索的活动日志 每一条请求与返回结果都会完整留存日志,自带搜索、过滤筛选功能,还支持 JSON 代码高亮,排查对接问题非常方便。 低功耗全天候值守 支持开机自启配置,整机功耗仅 5‑10W,对比常规 GPU 服务器 300W 以上的功耗优势巨大,完美盘活抽屉里闲置的老旧安卓手机。 丰富的自定义配置项 可以独立给每个模型设置推理参数,自由切换 GPU 或者 CPU 硬件加速;支持闲置自动卸载模型释放内存;还能够自定义监听范围、配置客户端 IP 访问规则、开启令牌鉴权,兼顾灵活度与安全性。 完善的可视化监控体系 内置实时数据仪表盘,悬浮小窗口可以常驻展示后台运行指标;指标数据可对接 Prometheus+Grafana 监控大盘,同时开放 Home Assistant REST API,实现远程管理控制服务。 极强的生态兼容性 Home Assistant、Open WebUI、OpenClaw、Python 脚本、curl 命令行都能直接对接,只要软件原生兼容 OpenAI 接口,就可以无缝接入这套手机本地 AI 服务。 实际能干哪些事 App 内置现成模型库,点击即可一键下载。同时支持手动导入后缀为 .litertlm 的模型文件,也能够通过 JSON 链接添加自定义模型源。 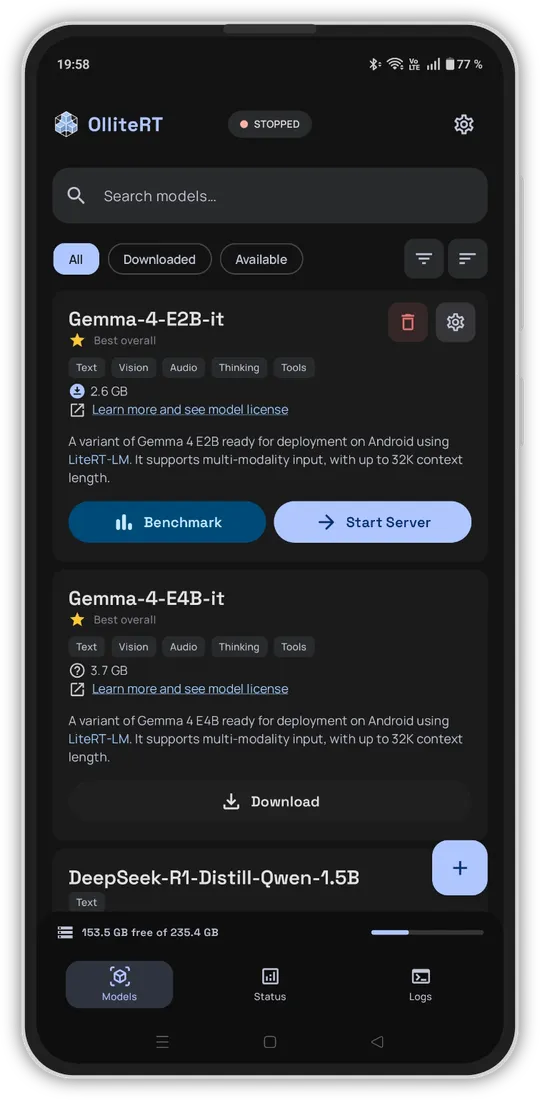
内置可选模型不少,日常主力推荐 Gemma 4 E2B,文件大小 2.4GB,8GB 内存的手机就可以流畅运行,支持图文识别、语音输入,还自带思考模式。如果你的设备内存偏小,也可以选择 Qwen 2.5 1.5B、DeepSeek‑R1 1.5B 这类轻量版本。 拿不准自己手机硬件扛不扛得住?内置 Benchmark 跑分工具,直接跑一遍,推理速度一目了然,避免下载完模型才发现设备跑不动的尴尬。 Gemma4 系列多模态能力完整,看图、语音输入、工具调用都支持,不过工具调用还处在实验阶段,稳定性参差不齐。 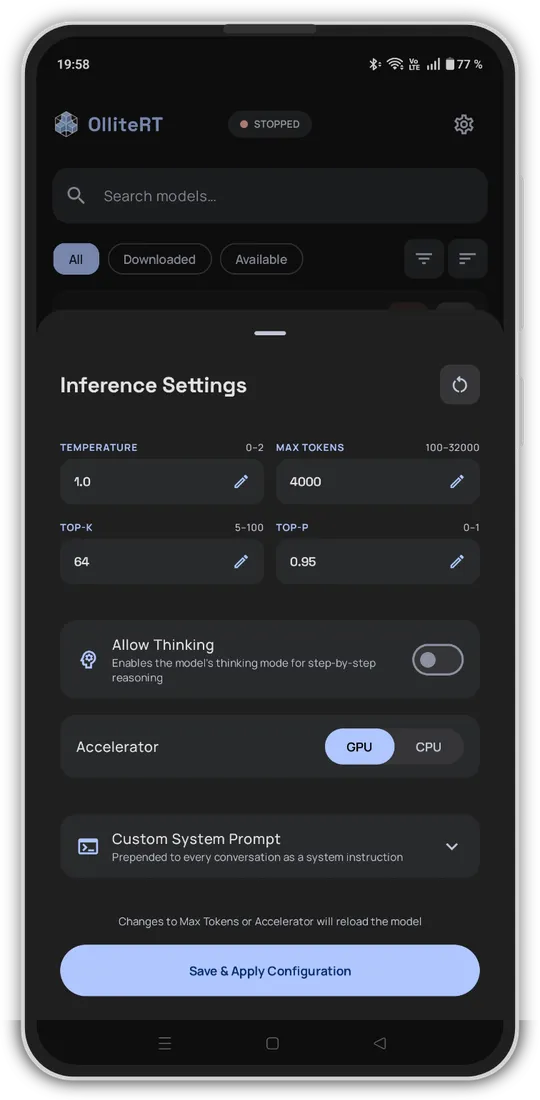
软件可调参数相当细致:每一个模型都能独立设置采样温度、最大输出 token;推理硬件可以自由切换 GPU 或者 CPU;还能设置闲置多久之后自动卸载模型释放内存。安全层面也考虑周全,可以限定监听范围、配置 IP 白名单、开启 Bearer token 校验,家庭局域网使用足够稳妥。 我个人折腾本地服务,最怕碰到黑盒程序,出问题完全无从排查。OlliteRT 这点做得很好,状态面板实时刷新全套运行数据:运行时长、收到多少请求、token 吞吐速率、解码速度、请求成功率全部可视化展示。 官方测试环境下,Gemma 4 E2B 解码速度最高可达 29.9 tokens/s,模型加载仅需 4 秒。如果你玩监控系统 Grafana,还能接入它提供的 Prometheus 指标,一共 29 项监控数据,直接接入大盘。家里部署 Home Assistant 智能家居平台,也可以调用 REST 接口远程控制模型加载、读取运行状态。 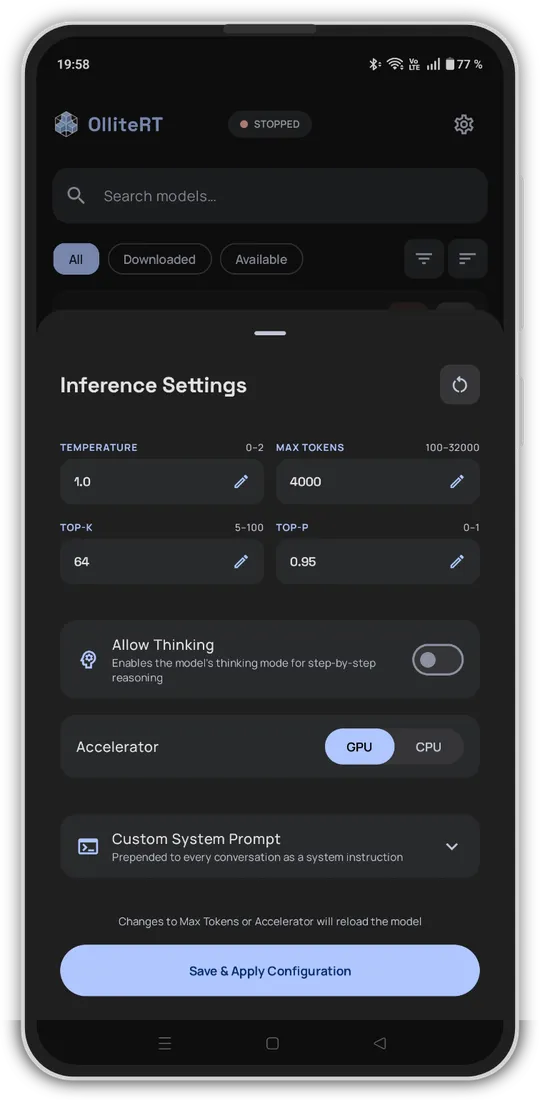
完整日志系统同样到位,每条请求的请求体、返回内容全部留存,支持检索过滤、JSON 高亮,哪个客户端发起请求、模型输出了什么内容,翻看日志就能够定位问题。 兼容性这块做得很厚道,除了标准 OpenAI 接口,还额外适配 Anthropic Messages 接口。同类小众开源项目里,同时兼容两套接口的并不多见。Open WebUI、Home Assistant、Python 脚本、curl,只要支持 OpenAI 接口的软件,基本都可以直接对接。 可选模型型号对照表 软件内置了一套适配移动端优化的模型库,不同机型内存大小,对应适合不同规格的模型,我整理好了选型参考:
💡选型小建议:普通 8GB 内存手机优先选择 Gemma 4 E2B ;12GB 及以上大内存旗舰机,可以上更强的 Gemma 4 E4B ;6GB 入门老机器,直接选用轻量纯文本模型。 快速上手实操步骤 整套流程并不复杂,绝大部分时间其实消耗在模型下载上面。 我自己拿 Open WebUI 做过实测,在设置‑连接选项新增 OpenAI 数据源,粘贴地址刷新,模型列表就会加载出来。注意一点:Open WebUI 默认关闭工具调用,需要手动把 Function Calling 切换为 Native 模式,功能才可以正常生效。 对接 Home Assistant 稍微多一步,通过 HACS 安装 Custom Conversation 自定义集成,填入上面三组参数。对接完成除了对话交互,还可以实现本地语音转文字。 Claude Code 也可以通过环境变量指向这个局域网接口,不过文档里也提醒,手机端模型上下文窗口有限,重型工具调用跑不动,只能当作兼容性测试玩玩,不要指望承担实际生产任务。 如有源码需求,请VX联系。 
承接各类项目开发 项目推广 商务合作 软件著作权 点个关注 🌟,精彩不迷路 ❤️
01
02
03
04
05
下载 APK 安装包。 硬件硬性条件:安卓 12 以上系统、arm64 架构,2017 年后发布的手机大多满足;内存最低 6GB,如果要跑图片语音多模态模型,建议内存 8GB 起步。 安装完成打开软件,在模型列表挑选需要的模型下载。普通用户优先选 Gemma 4 E2B。不想在 App 内下载,也可以自行准备 .litertlm 格式模型文件手动导入。 下载完毕,点击模型卡片的启动服务,等待数秒完成加载,服务就跑起来,默认端口 8000,端口号可以在设置页修改。 客户端接入。 状态页面复制局域网 API 地址。绝大多数客户端填写三项内容即可:接口地址 `http://手机IP:8000/v1` 、API 密钥(没有开启鉴权随便填占位字符)、模型名称(复制软件内展示的模型名字,例如 `Gemma‑4‑E2B‑it`)。
后端技术交流群 我们致力于创建一个高质量的技术交流社区,欢迎编程开发者和技术招聘HR专业人士加入。同时,我们也鼓励大家分享自己公司的内部推荐机会,互相协作,共同提升! 文明发言,以
交流技术 职位内推、行业探讨为主,添加备注888