ARTICLE · 1007106
Astra 太费 token?官方文档里有 8 个开关
Astra 是 token 收割机,这件事已经是共识了。但社区在传的省钱办法,基本就是那一行实验性开关。我把 Codex 官方配置参考从头翻到尾,和 token 直接相关的字段一共八个,其中三个几乎没人提过。
01档位有六档,不是三档
大部分人知道 low / medium / high。官方文档里 model_reasoning_effort 的可选值实际是六个:
none、minimal、low、medium、high、xhigh
两头那两档是被忽略的。改个变量名、调个格式、加一行日志,这类活儿 none 和 minimal 完全够用,而推理部分正是输出 token 里最贵的一块。默认全程挂在 medium 上,等于每改一个错别字都在付思考费。
另外这个字段官方是没有默认值的——不写就跟着模型走。想控制成本,第一步是把它显式写下来。
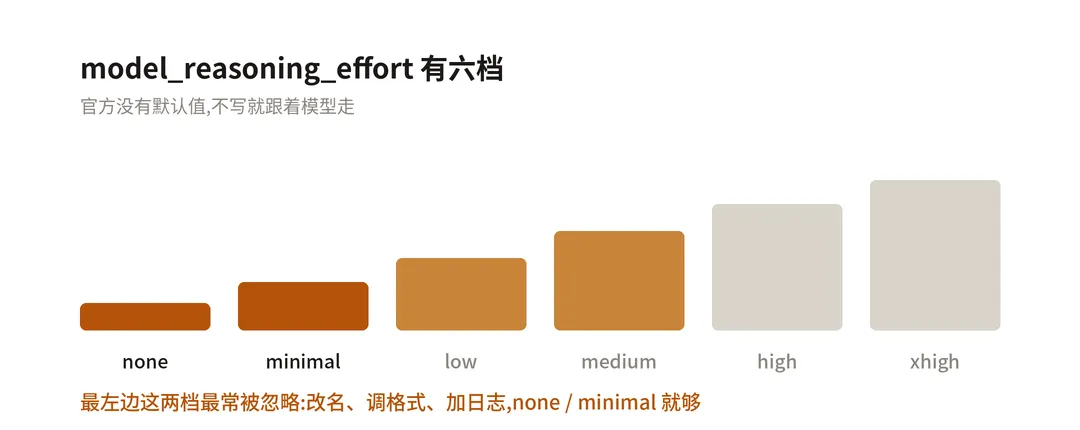
柱高只表示档位高低,不代表实际消耗倍数
02Plan 模式有自己的档位
这条几乎没人提。
plan_mode_reasoning_effort 是 Plan 模式专用的推理强度,内置默认值是 medium,而且一旦设置就会覆盖 Plan 的预设——包括设成 none。
意味着什么?你在主流程里把档位调到 low 省钱,但每次进 Plan 模式,它自己悄悄回到 medium。规划这个动作本来就偏发散、输出长,是个不小的消耗点。
你以为调了一个档位,其实只调了一半。
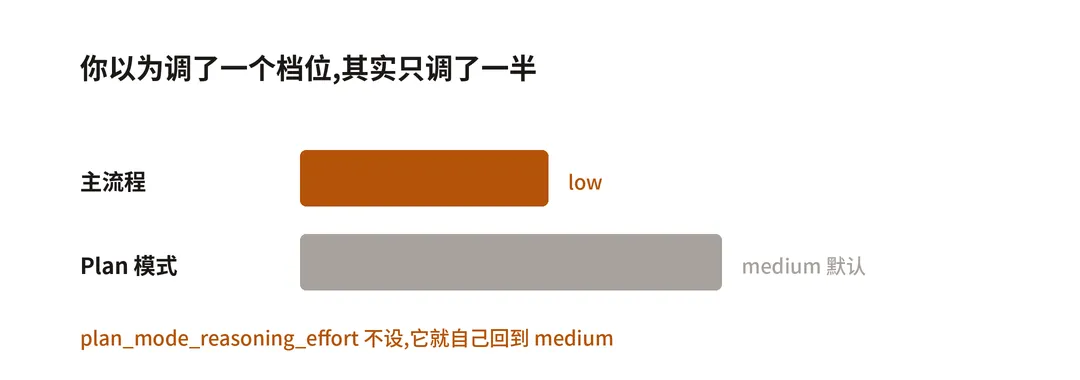
主流程调低了,Plan 模式还在 medium 上
03三个没人提的开关
A model_reasoning_summary推理摘要,可选 auto / concise / detailed / none,默认 auto。你在屏幕上看到的那些"我正在思考什么"的文字,是实打实的输出 token。喜欢看就留着,不看就设 concise 或 none。
B tool_output_token_limit工具输出的 token 预算上限。这是全文我最想让你记住的一个。跑一次全量测试几千行输出、git diff 刷屏、docker ps 一大片——这些原样进上下文,是把窗口撑满、逼出压缩的主力。给它设个上限,等于给噪音装了个闸。
C web_search可选 disabled / cached / live,默认 disabled。中间那档 cached 基本没人说——不用每次都真的联网抓一遍。开了 live 又用不上实时性的,可以退到这一档。
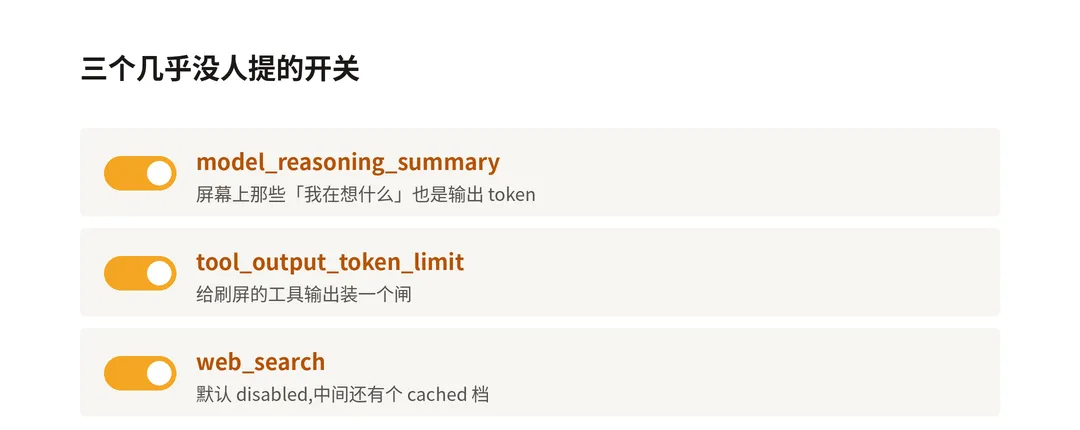
第二个最值钱,它直接决定压缩多久来一次
04压缩:三个字段 + 一个实验开关
压缩这件事值得单独说,因为它既费钱又损伤效果——每压一次,工具输出和推理链就丢一批,模型只能重读,重读又把窗口填满。
官方给了三个字段:
model_auto_compact_token_limit 是触发自动压缩的 token 阈值,调高它就是推迟压缩。compact_prompt 让你自定义压缩时的提示词,决定"保留什么、丢什么"——默认那套是通用的,不知道你的项目里哪些上下文丢不得。要是嫌写在配置里太长,用 experimental_compact_prompt_file 指向一个单独的文件。
另外就是大家已经在传的那个实验性上下文管理:
[features.context_management]experimental_mode = true
它的思路是用跨窗口笔记 + 可搜索的历史替代传统的压缩总结:细节丢得更少,也不用反复重读。注意这是实验功能,官方随时会调整,遇到行为异常先把它关掉再排查。
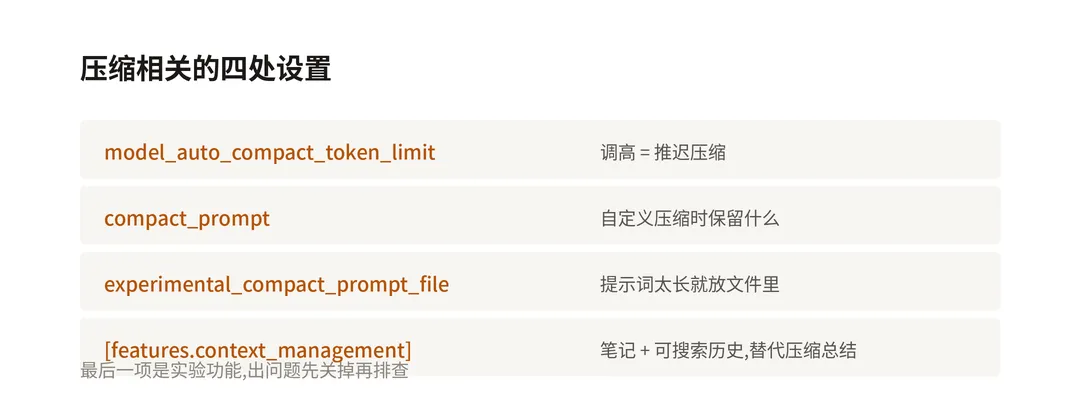
前三个是正式字段,最后一个是实验功能
05MCP:按工具粒度关,别按服务器粒度关
工具 schema 是每轮都要重发的固定开销,和你这轮问什么无关。挂了 GitHub、Jira、数据库几个 MCP,这笔钱每轮都在付。
直觉做法是把不用的服务器整个摘掉,但这会改变前缀结构、打掉提示缓存。更好的做法是用 enabled_tools 白名单或 disabled_tools 黑名单,在工具粒度上裁:服务器还在,配置结构稳定,但那几十个用不上的工具定义不进上下文。
真要整个停掉,用 enabled = false,别从配置里删。顺带一提,required 默认是 false——某个 MCP 连不上不会拦住 Codex 启动,排查问题时记得这一点。
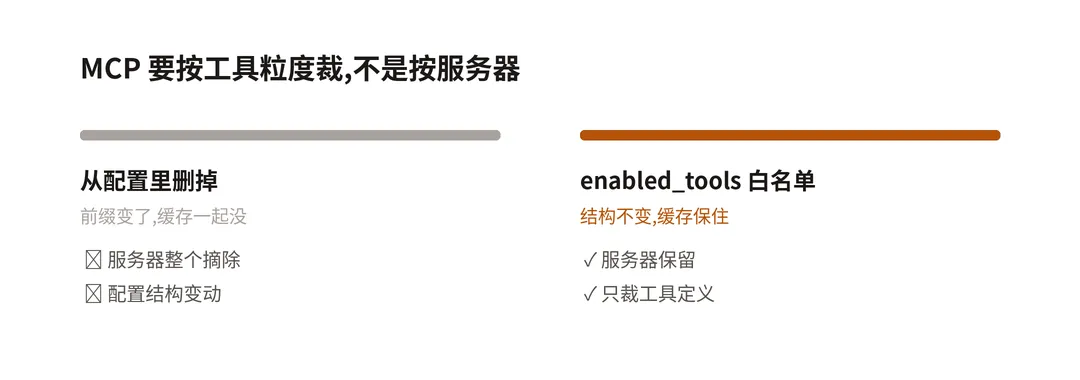
保留服务器、只裁工具,是对缓存最友好的做法
06官方在劝你把提示词写短
配置之外,OpenAI 这次的口径很明确:更强的模型需要更少的干预。以前为了弥补旧模型能力不足写的那些防御性规则,现在是负担——既占上下文,又会让 Astra 过度字面地执行、过早停下。
三处最该动:
技能描述收窄到单一触发条件。 "处理数据库、schema、查询、迁移等所有数据相关工作"这种写法,既模糊又容易在加载多个技能时被截断。改成"仅在编写或审查本仓库的数据库 schema 迁移文件时使用"。
删掉"每次修改前通读全部文档"。 换成按需指路:动服务边界看 architecture.md,改表结构看 database.md。根文件当路由器,别把整套工作流内联进去。
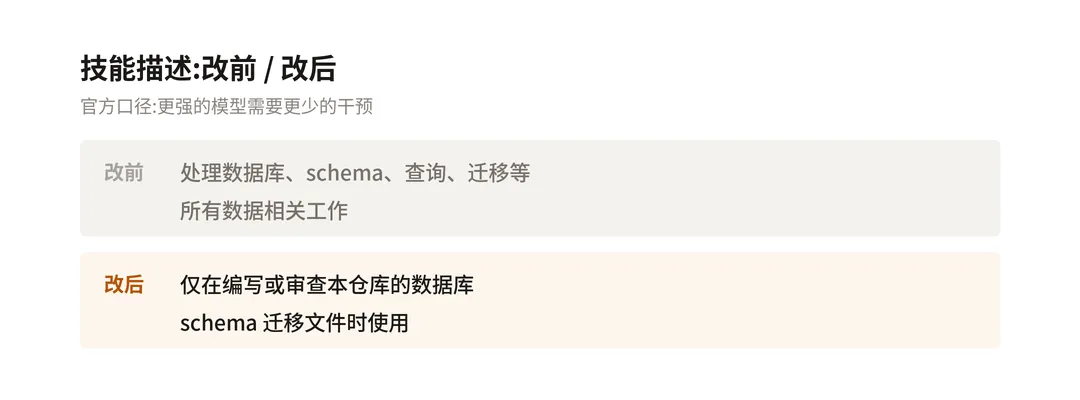
描述收窄到单一触发条件,也不容易被截断
把"先问再做"换成明确的完成标准。 过宽的审批要求会让模型停得太早,把真正高风险的留下(生产部署、破坏性迁移、要花钱的 API 调用),其余改成显式授权 + 明确的停止条件:改完、受影响的测试本地通过、其他失败也修掉,全满足才停。
还有个有意思的细节:官方给了一份"废话词"黑名单,像 delve into、leverage,以及 "Conclusion:" "In short:" 这类总结开头,还有 "X, not Y" 的对仗句式。建议用直白的段落代替。这条虽然是冲着文风去的,但输出短了,钱也就省了。
07一份能直接抄的配置
放进 ~/.codex/config.toml,数值按你的项目调:
# 日常档位,重活手动往上抬model_reasoning_effort = "low"# Plan 模式单独设,不然它自己回 mediumplan_mode_reasoning_effort = "low"# 不看思考过程就压掉model_reasoning_summary = "concise"# 给工具输出装闸,挡住刷屏tool_output_token_limit = 8000# 推迟压缩,拉长缓存周期model_auto_compact_token_limit = 120000# 用不上实时性就退到 cachedweb_search = "cached"[features.context_management]experimental_mode = true
两句提醒。第一,这些数值不是标准答案,上下文窗口、仓库大小、任务类型都会让最优值不一样,官方也没给任何节省比例——照抄之后自己盯几天 /status 再微调。
第二,一次只改一项。八个开关一起动,省下来的和变差的会混在一起,你分不清是哪个的功劳,也分不清是哪个的锅。
· · ·
Astra 确实贵,但贵的部分里有相当一块是默认值带来的——默认不设档位、默认展开推理摘要、默认让工具输出无限进上下文、默认等窗口满了才压缩。
这些开关官方都写在文档里,只是没人替你打开。