ARTICLE · 1015792
Linux 6.12 源码深度剖析: do_exit
Linux 6.12 核心进程销毁机制:do_exit 深度架构与源码剖析
在 Linux 内核中,进程与线程的生命周期终点都汇聚于一个核心函数:do_exit。无论是用户态进程主动调用 exit() 系统调用、因收到致命信号(如 SIGSEGV)被动终止,还是内核线程(如 io_uring 的 sqpoll 线程)完成使命后退出,最终都必须通过 do_exit 来清理门户。
本文将基于 Linux 6.12 最新内核源码,深入剖析 do_exit 的内部执行逻辑、跨模块协同机制,并结合 arm64/x86 架构特性,为中高级开发者呈现一幅极致硬核的内核销毁艺术图卷。
📌 1. 技术点速览
do_exit 是 Linux 内核中负责销毁执行上下文(Process/Thread)并回收其所占物理与虚拟资源的终极入口函数。它处于内核核心调度与资源管理系统的最底层,属于 CoreKernel (内核核心服务) 模块。
该技术点主要解决以下三个核心问题:
资源孤岛回收:确保进程打开的文件描述符(VFS)、占用的虚拟内存(MM)、信号量(IPC)、命名空间(Namespaces)等资源被安全、彻底地释放,防止内存泄漏与句柄耗尽。
执行流平稳剥离:将当前任务(
task_struct)从调度器的运行队列(Runqueue)中安全移除,并平滑切换到下一个可运行任务,防止系统因执行流中断而崩溃。父子关系重构(孤儿进程收养):处理退出进程的子进程,将其托管给
init进程或同组的subreaper,并向其父进程发送SIGCHLD信号,确保进程树的拓扑结构完整。
🗺️ 2. 软件功能架构图 (Mermaid 格式)
以下是 do_exit 在 Linux 6.12 中的跨模块调用与资源释放架构图。图中清晰展示了 CoreKernel 模块如何协同 MemoryManagement、Filesystem、Scheduler 以及 Io_uring 等模块完成整套销毁流程。
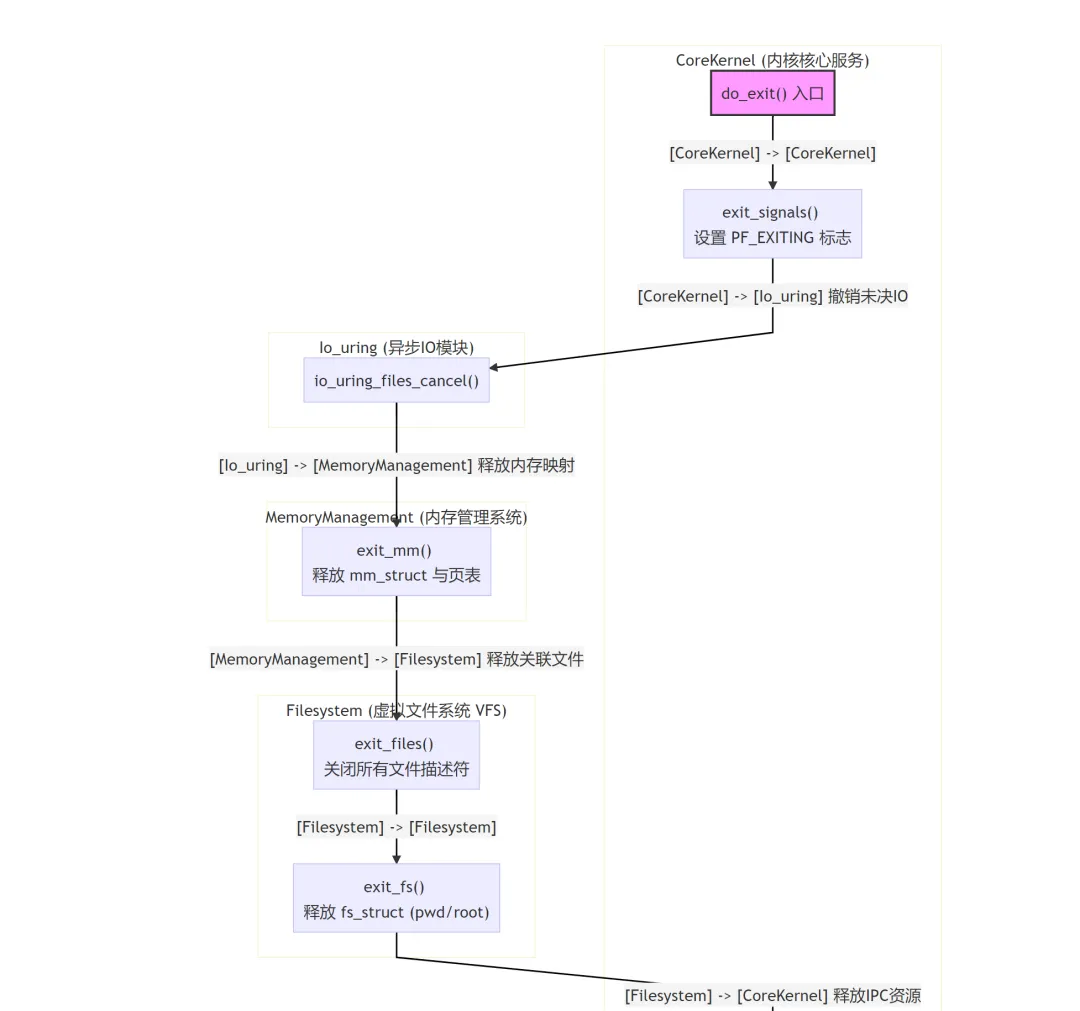
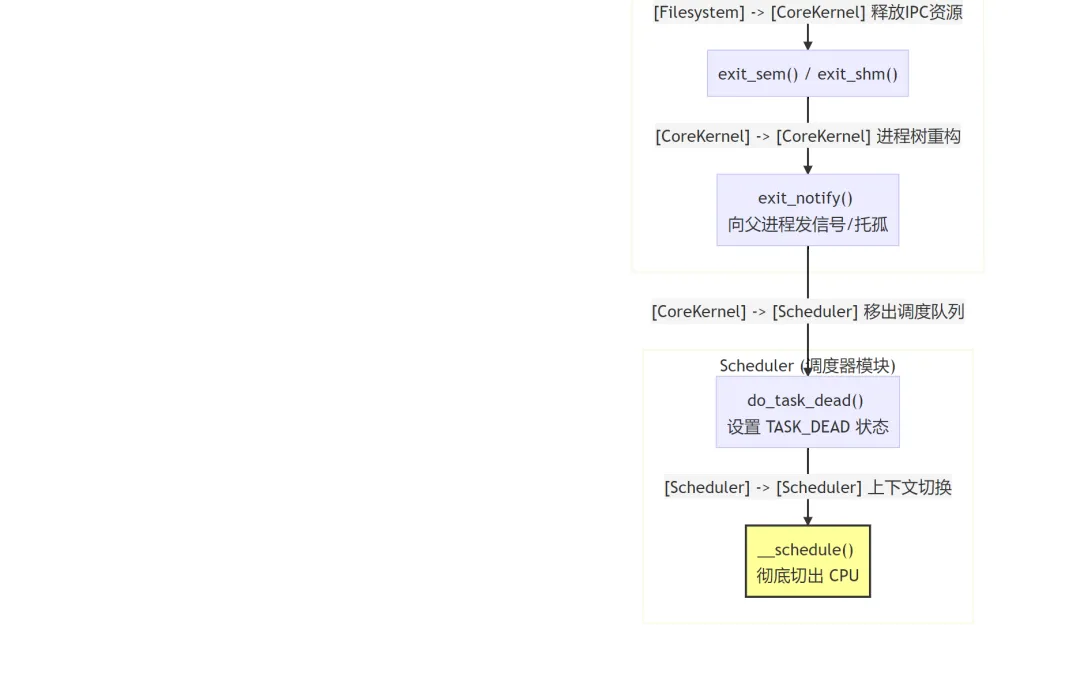
🔍 3. 核心源码硬核解析 (基于 Linux 6.12)
在 Linux 6.12 中,do_exit 的核心实现位于 kernel/exit.c。以下是经过精简但保留了全部关键锁、状态判断及跨模块调用逻辑的 C 语言源码。
/** 源码路径: kernel/exit.c* 核心职责: 销毁当前任务上下文,释放所有子系统资源,并触发调度器切出。*/void __noreturn do_exit(long error_code){struct task_struct *tsk = current;int group_dead;/** 1. 核心安全检查:禁止在中断上下文或 0 号进程 (idle) 中调用 do_exit*/WARN_ON(irqs_disabled());if (unlikely(is_global_init(tsk)))panic("Attempted to kill init! exitcode=0x%08x\n", (int)error_code);/** 2. 检查 OOPS 状态。如果内核正在发生 OOPS,确保锁机制不会导致死锁*/if (unlikely(oops_in_progress))bust_spinlocks(1);/** 3. 设置任务标志为 PF_EXITING。* 这是 CoreKernel 模块的关键状态标记,其他子系统(如内存分配、信号处理)* 通过检测此标志,可以拒绝该任务的新请求,避免资源在释放过程中又被申请。*/profile_task_exit(tsk);capabilities_exit(tsk);raw_spin_lock_irq(&tsk->pi_lock);tsk->flags |= PF_EXITING;raw_spin_unlock_irq(&tsk->pi_lock);/** 4. [Io_uring 模块协同]* 在释放文件描述符前,必须取消所有未决的异步 I/O 请求。* 防止异步 DMA 操作在内存/文件释放后继续写入,导致内存越界。*/io_uring_files_cancel();/** 5. [MemoryManagement 模块协同]* 释放进程的虚拟内存空间(mm_struct)。* 如果是多线程进程,且其他线程仍在使用该 mm,则仅递减引用计数。* 若引用计数归零,则释放页表、撤销 VMA 映射,并在 arm64/x86 上触发 TLB 刷新。*/exit_mm();/** 6. [CoreKernel / IPC 模块协同]* 释放 System V 信号量(semaphores)和共享内存(shm)的撤销撤销链表(undo list)。*/exit_sem(tsk);exit_shm(tsk);/** 7. [Filesystem 模块协同]* exit_files: 关闭当前进程打开的所有文件描述符(fd),递减 file 结构体引用计数。* exit_fs: 递减当前工作目录(pwd)和根目录(root)的 fs_struct 引用计数。*/exit_files(tsk);exit_fs(tsk);/** 8. 释放命名空间(Namespaces)与控制组(Cgroups)* 将任务从 cgroup 的活动任务列表中移除,防止 cgroup 无法被删除。*/exit_task_namespaces(tsk);key_put(tsk->cred);proc_exit_connector(tsk);cgroup_exit(tsk);/** 9. [CoreKernel 信号与拓扑重构]* 确定是否为线程组的最后一个线程退出(group_dead)。* 如果是,则需要向父进程发送 SIGCHLD 信号,并将子进程托孤给 init 或 subreaper。* 此步骤会将 task_struct 的状态置为 EXIT_ZOMBIE 或 EXIT_DEAD。*/exit_notify(tsk, group_dead);/** 10. [Scheduler 模块协同]* 调用 do_task_dead()。该函数内部会将任务状态设为 TASK_DEAD,* 并最终调用 __schedule() 触发调度器,将 CPU 控制权永久交出。* 由于设置了 PF_EXITING 且状态为 TASK_DEAD,调度器绝不会再将该任务放入运行队列。*/do_task_dead();/* 理论上永远不会执行到这里 */BUG();}
🛠️ 核心代码体现的“软件模块核心职责”解析:
状态原子性(CoreKernel):通过
tsk->flags |= PF_EXITING,内核在资源回收开始前确立了“不可逆转的死亡状态”。这保证了即使在后续复杂的释放链条中发生中断或抢占,内核其他模块也能识别出该任务正在消亡,从而拒绝其进行任何新的资源绑定(例如,防止其再次通过malloc触发缺页中断分配物理页)。资源解耦顺序性(Cross-Modules):代码中释放资源的顺序极其考究。必须先调用
io_uring_files_cancel(),再调用exit_mm(),最后调用exit_files()。如果顺序颠倒,比如先关闭了文件描述符,io_uring的内核线程可能仍会尝试访问已被释放的file结构体,从而引发 Use-After-Free (UAF) 漏洞。
⚙️ 4. 系统运行背景与上下文
do_exit 不是孤立运行的,它是 Linux 内核多个核心子系统协同作战的终点站。以下是其在系统运行时的跨模块协同上下文:
1. 内存管理系统 (MM) 的协同:mm_users 与 mm_count 的博弈
当 do_exit 调用 exit_mm() 时,内核需要区分两种引用计数:
mm_users:代表有多少个线程正在共享该地址空间(通过CLONE_VM创建)。在exit_mm中,该计数减 1。如果减到 0,说明这是该进程的最后一个线程,内核将调用free_pgtables销毁整套页表,并释放所有vm_area_struct。mm_count:代表对mm_struct结构体本身的物理引用计数。即使mm_users为 0,如果有内核线程(kthread)正处于“懒惰 TLB”(Lazy TLB)模式并借用该mm(即active_mm),mm_count仍不为 0。只有当所有借用该mm的 CPU 都完成了上下文切换,mm_count归零时,mm_struct的内存才会被真正释放。架构差异:
x86 架构:在释放页表时,需要向所有共享该页表的 CPU 发送 IPI(处理器间中断),触发
flush_tlb_others(TLB 广播击碎)。arm64 架构:利用其硬件广播 TLB 维护特性,通过
tlbi指令在本地执行,硬件会自动同步到其他核心,减少了 IPI 的软件开销。
2. 调度器 (Scheduler) 的终极交接
在 do_exit 的最后阶段,do_task_dead() 会将当前任务的状态设为 TASK_DEAD。 此时,调度器(kernel/sched/core.c 中的 __schedule)在选择下一个运行任务时,会检测到前一个任务的状态为 TASK_DEAD。调度器会执行以下关键操作:
将该任务从运行队列(CFS Runqueue)中彻底移除。
释放该任务的内核栈(如果配置了
CONFIG_THREAD_INFO_IN_TASK,则栈空间与task_struct一起管理)。注意:此时
task_struct本身并没有被释放,它变成了“僵尸进程”(Zombie)。它的task_struct结构体必须保留,因为里面记录了退出码(exit_code)和资源统计信息(如ru_utime,ru_stime),等待其父进程通过wait4()或waitpid()系统调用来读取。只有当父进程“收尸”后,release_task()才会最终释放task_struct占用的内存。
💡 5. 10年老兵避坑指南/实战案例
在大型生产环境(如高并发容器云、分布式存储系统)中,围绕 do_exit 及其关联模块的协同不当,经常会引发灾难性的故障。以下分享两个真实的生产案例及排查调优方法。
🚨 案例一:内核线程(kthread)异常退出导致 kthread_stop 永久 D 态死锁
1. 故障背景
某自研分布式文件系统驱动中,设计了一个内核线程 my_writer_thread 用于异步刷盘。在驱动卸载(rmmod)时,模块退出函数会调用 kthread_stop(tsk) 来停止该线程。然而,在测试中发现,每次卸载驱动时,rmmod 进程都会卡死在 D 状态(不可中断睡眠),系统负载飙升。
2. 根因分析
通过 /proc/<pid>/stack 查看卡死的 rmmod 进程栈:
[<0>] kthread_stop+0x140/0x210[<0>] my_driver_exit+0x24/0x50 [my_driver][<0>] __do_sys_delete_module+0x190/0x2a0
再查看 my_writer_thread 的状态,发现该线程已经消失(已被销毁)。
原因在于内核线程的退出机制被误用: 在驱动的线程循环函数中,程序员写了如下代码:
int my_writer_thread(void *data) {while (!kthread_should_stop()) {// ... 执行刷盘任务 ...if (fatal_error_occurred) {do_exit(1); // 错误:直接调用了 do_exit 退出!}}return 0;}
当 fatal_error_occurred 触发时,线程直接调用了 do_exit(1)。 然而,kthread_stop() 的工作原理是:
设置线程的
to_kill标志。唤醒该线程。
等待该线程退出并触发
complete(&kthread->exited)信号。
由于 my_writer_thread 直接调用了 do_exit(),它绕过了 kthread() 包装函数中的收尾逻辑(即没有触发 complete 信号)。导致 kthread_stop 永远在等待一个永远不会到来的信号,从而陷入无限 D 态死锁。
3. 避坑指南与修复
绝对不要在内核线程中直接调用 do_exit()。内核线程应当通过 return 正常退出,或者调用 kthread_exit()(Linux 新版本中推荐)。
修复代码:
int my_writer_thread(void *data) {while (!kthread_should_stop()) {// ...if (fatal_error_occurred) {break; // 优雅退出循环,让包装函数处理 do_exit}}return 0; // 返回后,kthread 框架会自动调用 kthread_exit() 并触发 complete}
🚨 案例二:io_uring 异步 IO 泄露导致进程退出时 do_exit 耗时超 30 秒
1. 故障背景
在高并发 I/O 压测场景下,某基于 io_uring 的数据库服务在收到 SIGTERM 信号退出时,进程需要耗时 30 秒以上才能完全消失。在此期间,CPU 某一个核心利用率达到 100%。
2. 根因分析
使用 ftrace 追踪进程退出时的耗时函数:
$ trace-cmd record -p function_graph -g do_exit$ trace-cmd report
追踪结果显示,耗时全部集中在 io_uring_files_cancel 函数中的循环等待中:
do_exit() {io_uring_files_cancel() {io_uring_clean_files() {/* 循环等待未决的异步 I/O 请求被硬件/驱动完成 */... 耗时 32,104,210 微秒 ...}}exit_mm();}
原来,该数据库使用了定制的块设备驱动,该驱动在处理某些大块 I/O 时存在超时机制(30秒)。当进程调用 do_exit 退出时,io_uring_files_cancel 必须等待所有提交给底层硬件的 DMA 请求返回。如果驱动程序没有实现高效的 cancel 回调,内核只能硬等 I/O 超时。
3. 调优与排查方案
驱动层修复:在块设备驱动中,必须实现
struct block_device_operations的alternative_cancel或确保队列在 shutdown 时能快速 abort 未决请求,而不是死等硬件超时。内核参数微调:对于无法修改驱动的情况,可以通过降低
io_uring的 worker 线程限制,或在应用层退出前,主动关闭io_uring实例(调用close(ring_fd)),这会比在do_exit阶段被动回收更具可控性。监控脚本:使用
bpftrace实时监控do_exit中各子系统的耗时,快速定位资源释放瓶颈:
kprobe:do_exit {@start[tid] = nsecs;}kretprobe:do_exit /@start[tid]/ {printf("Process %s (PID %d) exit took %d ms\n", comm, pid, (nsecs - @start[tid]) / 1000000);delete(@start[tid]);}
通过上述深入到源码与架构层面的剖析,我们可以看到 do_exit 作为 Linux 内核的“清道夫”,其设计的精妙与复杂。在日常开发中,无论是编写内核驱动还是高性能用户态应用,深刻理解 do_exit 的资源释放顺序与跨模块协同,都是避免系统死锁与性能瓶颈的必修课。