ARTICLE · 1016372
OpenRouter CEO:超级 App 时代落幕,Harness 才是真正主角
在 20VC 最新播客访谈中,Alex 抛出大量颠覆固有认知的判断,涉及多模型格局、推理商业、记忆架构、下一代 Agent 交互 Harness,甚至企业人力成本的重新定义。
那场危机给他刻下一条深刻认知:基础设施的生死,不在于流量会不会来,而在于流量骤然到来的时候,系统能不能扛得住。
如今,他把这套经验带到 OpenRouter—— 一家大模型 “总路由器”。它不训练模型,而是聚合全球各家大模型,根据速度、价格、质量,自动把请求路由到最合适的模型与推理服务商。
站在这个特殊的 “上帝视角”,他看到的 AI 行业,和大众津津乐道的 “一模型赢天下” 完全不同。
今天我们抛开技术晦涩术语,拆解这场访谈的核心洞察,也留下一些值得行业人思考的问题。
不会有赢家通吃:多模型,是长期既定事实
当下舆论总在期待:会不会诞生一个全能大模型,把所有对手全部淘汰?
Alex 给出明确结论:多模型生态不可避免,单一模型很难垄断全部市场。
原因很朴素:不同模型训练数据集、训练路径、模型 “性格” 完全不一样。有些模型擅长创意发散,有些擅长严谨逻辑,有的成本低廉适合批量任务。即便是企业做了自研私有模型,也只会用来承载自身核心业务护城河;面对层出不穷的外部新模型,依然会持续拿来补充能力、压缩成本。
🔍思考:
如果多模型成为常态,未来产品经理、开发者,还需要深度精通某一个模型吗? 企业到底该自研模型,还是直接选用外部模型?两者的边界在哪里?
同时一个容易被忽略的真相:同一个模型,交给不同服务商部署,体验天差地别,Token 并不等价。推理不是简单的卖算力的大宗商品。服务商底层优化、调度策略不同,同样的模型,输出质量、响应延迟、稳定性都会出现差距。推理服务商,依然拥有巨大的优化空间。
而 OpenRouter 做路由,核心卖的不是路由技术,而是选择权。让开发者随时用上最新问世的模型,降低对单一厂商的绑定与依赖。
一个很有意思的经济学现象:杰文斯悖论在 AI 领域应验
访谈披露一组真实平台数据:某款模型价格直接下降 10 倍,两周之内调用量上涨 13 倍。
通俗来讲:模型降价,并不会让平台总收入随之同比例缩水;价格下降,会引爆更多新的使用场景,整体市场盘子反而变大。
AI 算力越便宜,大家就越敢去做更多、更复杂的尝试,需求被进一步放大。
🔍思考:你所在公司,是否因为模型成本太高,放弃过一些 AI 落地想法?如果推理成本再大幅下降,你们最想做什么新业务?
企业最大风险,是模型巨头下场竞争
访谈中一个很尖锐的观点,刷新很多人的固有认知:美国企业的焦虑,不完全来自海外开源模型;更忌惮的,反而是 OpenAI、Anthropic 这类前沿模型厂商本身。
原因非常现实:大量 AI 创业公司,本质是在大模型之上,做一层业务包装,靠提示词、业务流程做差异化。可一旦底层模型厂商,直接面向同一赛道推出原生产品,创业公司的护城河瞬间被消解。就像 Claude Design 推出,直接对 Figma 所在的设计赛道形成冲击。
反观海外开源模型,企业的顾虑集中在合规、数据安全、供应链信任,风险边界反而相对清晰可控。Alex 也直言:中国开放权重模型的实力,被美国市场普遍低估,但合规与信任,仍是进入美国企业市场的现实门槛。
记忆不会被任何一方垄断,未来是多层记忆架构
过去大家畅想:大模型会记住我的全部历史,记忆能力会变成锁定用户最强壁垒。
但 Alex 判断,记忆不会被模型厂商独占。未来会走向分层记忆:模型层、应用层、推理服务商、路由平台,各自保存一部分记忆碎片。
应用手握大量业务场景上下文,这些关键信息模型本身并不掌握;模型厂商想要完整记忆,需要获得应用侧的授权。不存在某一家可以垄断全部用户记忆。
🔍行业思考:如果记忆分散在多个平台,未来的 AI 产品,如何保障用户隐私?跨层记忆之间互相干扰,又该如何解决?
Harness取代超级App,传统软件退为Agent的后台
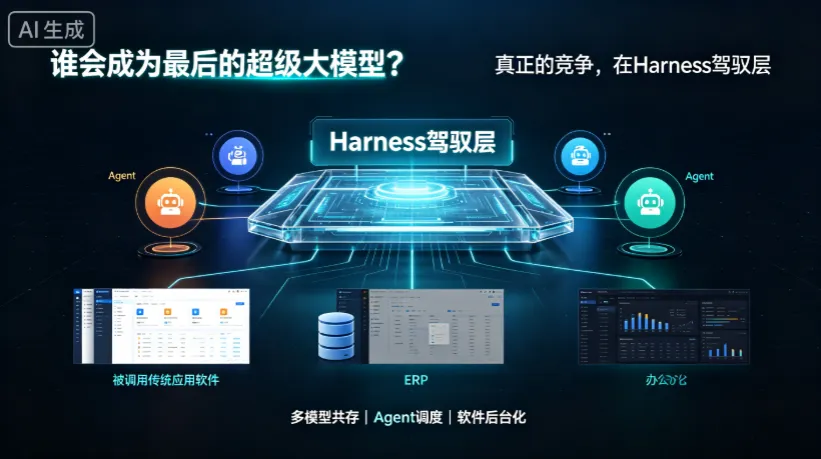
访谈中最具颠覆性的概念:Harness(驾驭层)。很多人会疑惑,Harness 到底是什么?它不是模型,也不是普通 App,是跑在模型之上、面向 Agent 的可组合工作界面。
传统 App,是一个个封闭独立的孤岛,彼此打通困难。而 Harness 基于 Unix 环境构建,天然支持互相调用:一个 Harness 可以拉起、调度另外一个 Harness,在沙箱环境完成任务。
当 Agent 需要完成工作,不再需要去打开一个个 App,处理登录、适配 API、解析文档等一堆麻烦;Harness 提供统一的执行环境,各类 ERP、CRM、办公软件,退化成被 Agent 调用的后台工具。
这对于没有自研大模型的创业公司意义重大:就算不掌握底层模型,创业企业依然可以依靠 Harness 牢牢握住用户交互和用户关系,建立自己的产品壁垒,而不是彻底沦为大模型的插件。
🔍思考:
Harness 的兴起,会不会让今天大量 SaaS 软件价值重构?哪些工具会被弱化? 未来普通用户,是继续使用熟悉的 App,还是会直接通过 Harness 下达任务?
Alex 也给出一套 Agent 的理想架构:不必所有任务都调用最贵的顶尖大模型。用最强模型承担规划、复杂推理的编排工作;而文本分类、格式转换这类确定性任务,交给成本低廉的开源子 Agent 去执行。就像组建一支 AI 团队,不同模型各司其职,兼顾效果与成本36氪。
未来:员工成本定义,正在被 AI 改写
访谈抛出一个非常现实、细思极恐的变化:企业的人力成本,未来不再只看薪资。
过去员工成本是固定薪酬;而 AI 时代,员工会产生动态的推理算力账单。
同样一件工作,有的员工善于优化提示词,选用性价比合适的模型,用很低算力成本拿到高质量产出;也有人不分场景,无脑调用最贵大模型,反复重试,消耗大量算力,业务产出却平平。
未来管理者评估员工,除了业务结果,还要观测 AI 使用的投入产出。算力消耗,会变成企业内部重要的运营指标。
🔍思考:如果公司未来会统计每个人的 AI 算力消耗,这件事会带来哪些正面和负面的影响?会不会催生新的职场压力?
最后:AI 行业,正处在范式切换的前夜
整场访谈,Alex 从基础设施、商业博弈、产品形态,到企业管理,描绘出一幅和当下主流叙事截然不同的 AI 图景:
不要押注单一 “终极模型”,多模型共存是长期趋势; 推理不是简单的卖铲子,选择权本身就是商业价值; Harness 驾驭层崛起,传统应用软件或将退居后台; 记忆走向多层分布,不存在单一平台垄断用户全部信息; AI 会重塑企业成本结构,算力消耗成为新的管理变量。
当然这些判断,依然带有推演属性,部分设想还没有大规模落地。未来真正会走向何方,依然等待市场验证。
欢迎在评论区说说你的判断。