ARTICLE · 1018534
今天深讲:anydoc - 4毫秒将Office转纯净Markdown
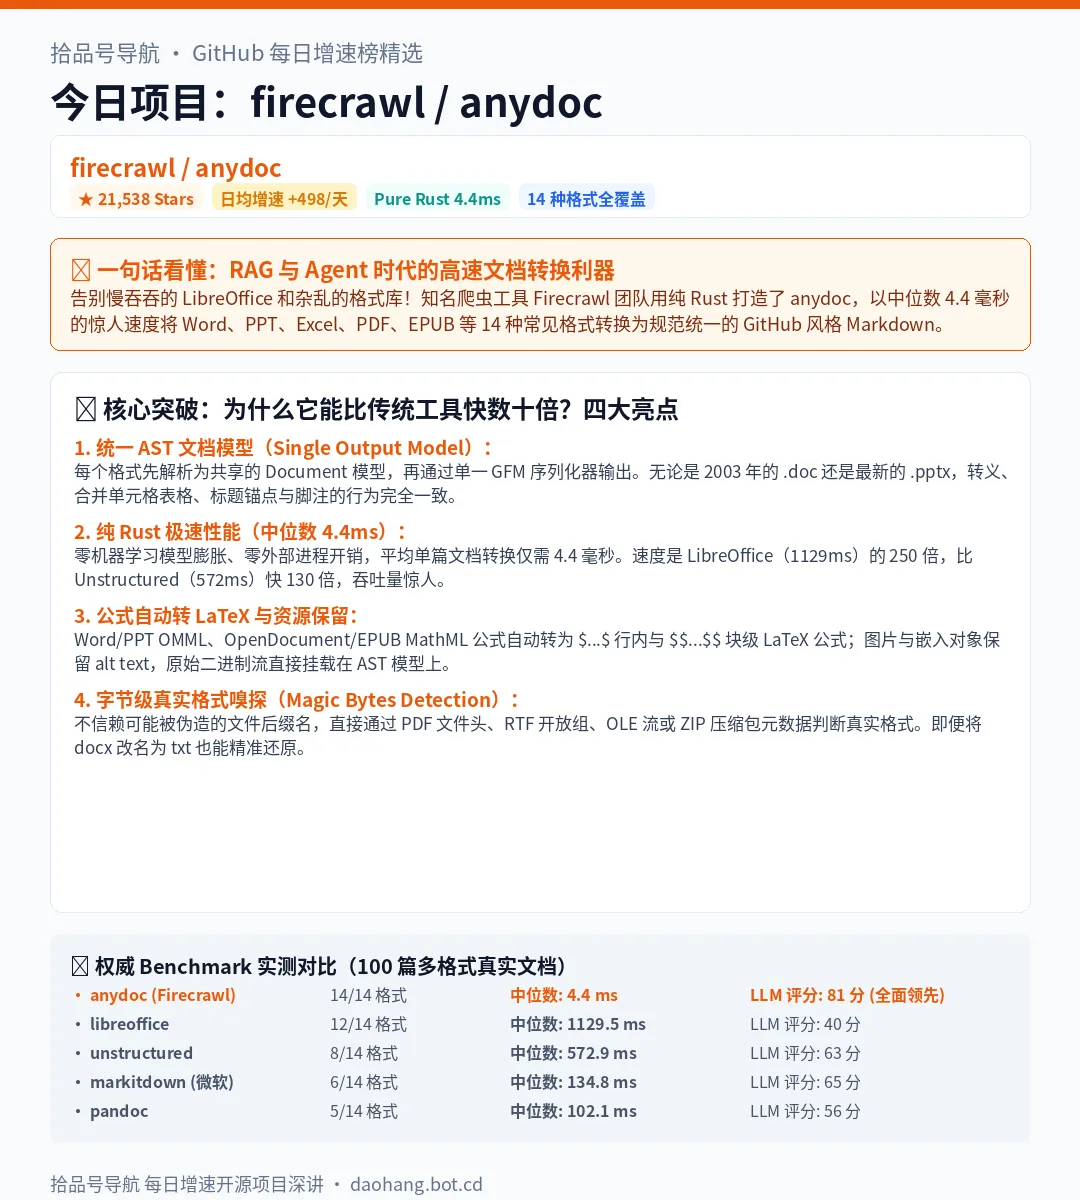
一句话看懂:在 RAG 与 AI Agent 场景中,文档解析往往又慢又割裂。知名爬虫团队 Firecrawl 出品的 anydoc 用纯 Rust 重写了全套文档解析管线,仅需 4.4 毫秒中位数耗时,即可将 Word、PPT、Excel、PDF、EPUB 等 14 种格式转为结构统一的纯净 Markdown,比 LibreOffice 快 250 倍,更原生附带 Agent 技能!
01 · 核心痛点:告别笨重、缓慢与碎片化的文档解析
构建大模型知识库(RAG)或打造自主 AI Agent 时,文档解析几乎是每个工程师都绕不过去的“泥潭”。传统方案存在三大顽疾:
• LibreOffice 方案笨重而迟缓:每次转换都需要启动庞大的后台进程,中位数耗时高达 1.1 秒以上,高并发下极易把服务器内存与 CPU 占满;
• 碎片化格式解析器导致输出割裂:Word 用一套库、PPT 用一套库、Excel 又用一套库,表格转义规则、标题层级、换行与内嵌公式完全不同,严重污染喂给大模型的上下文质量;
• 视觉模型开销巨大:部分端到端文档解析工具需要加载数十 GB 视觉权重,推高了轻量级知识库的硬件门槛。
anydoc 则选择了一条兼具极致工程效率与统一架构的路径:用纯 Rust 统一 AST 抽象。不管是 2003 年的老旧 .doc 还是最新的 .pptx,全部经由同一套中间文档模型与 GFM 序列化器输出,平均只需 4.4 毫秒!在 Claude Sonnet 5 盲测评分中,anydoc 斩获 81 分的最高综合质量,远超 LibreOffice(40分)与 Pandoc(56分)。
02 · 架构亮点:统一 AST 模型与多语言生态
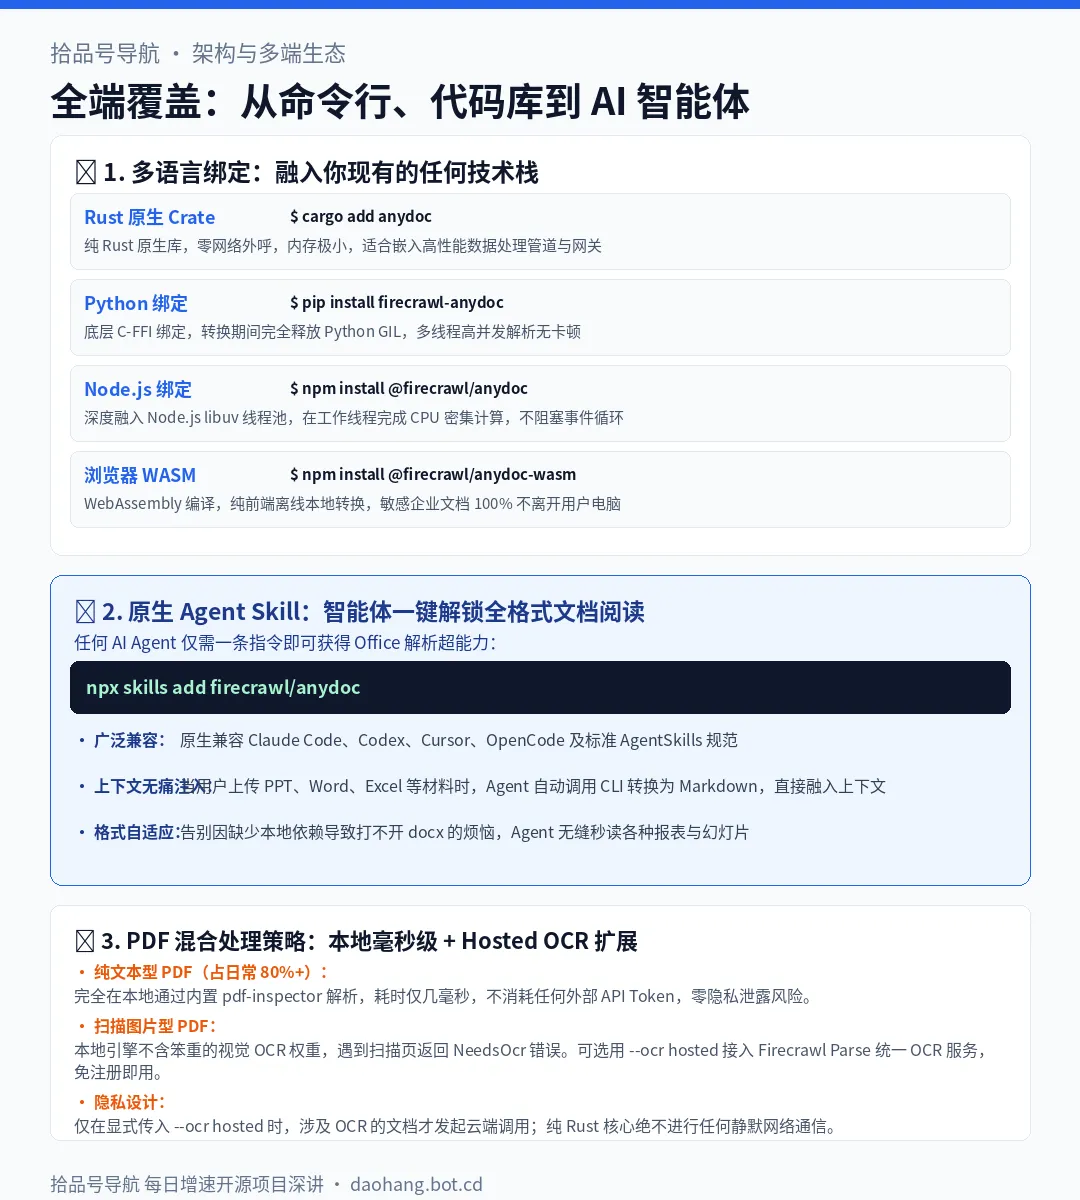
anydoc 之所以能兼顾极限速度与规范格式,关键在于其精妙的架构设计:
所有 14 种格式不是直接转字符,而是先统一解析到由 Block、Inline、Table、Asset 构成的内部抽象语法树。这意味着表格防转义、标题锚点、脚注生成只需要在一处修复,全格式自动生效!
Word 和 PPT 中的 OMML 格式、OpenDocument 中的 MathML 公式,均被自动转为 GitHub 风格的 LaTeX 表达(行内 $...$ 与块级 $$...$$),完美契合大模型数学理解能力。
• Python 开发者:pip install firecrawl-anydoc,底层 C-FFI 绑定在解析时主动释放 GIL,多线程并发吞吐拉满; • Node.js 开发者:在 libuv 线程池中执行,不阻塞 Event Loop 主循环; • 浏览器端:提供 WASM 包,前端本地完成解析,企业私密文档完全不离机; • AI 智能体:直接运行 npx skills add firecrawl/anydoc,即刻为 Claude Code、Cursor、Codex 等 Agent 赋予读写文档的能力!
03 · 极速体验:免安装试跑与客观避坑提示
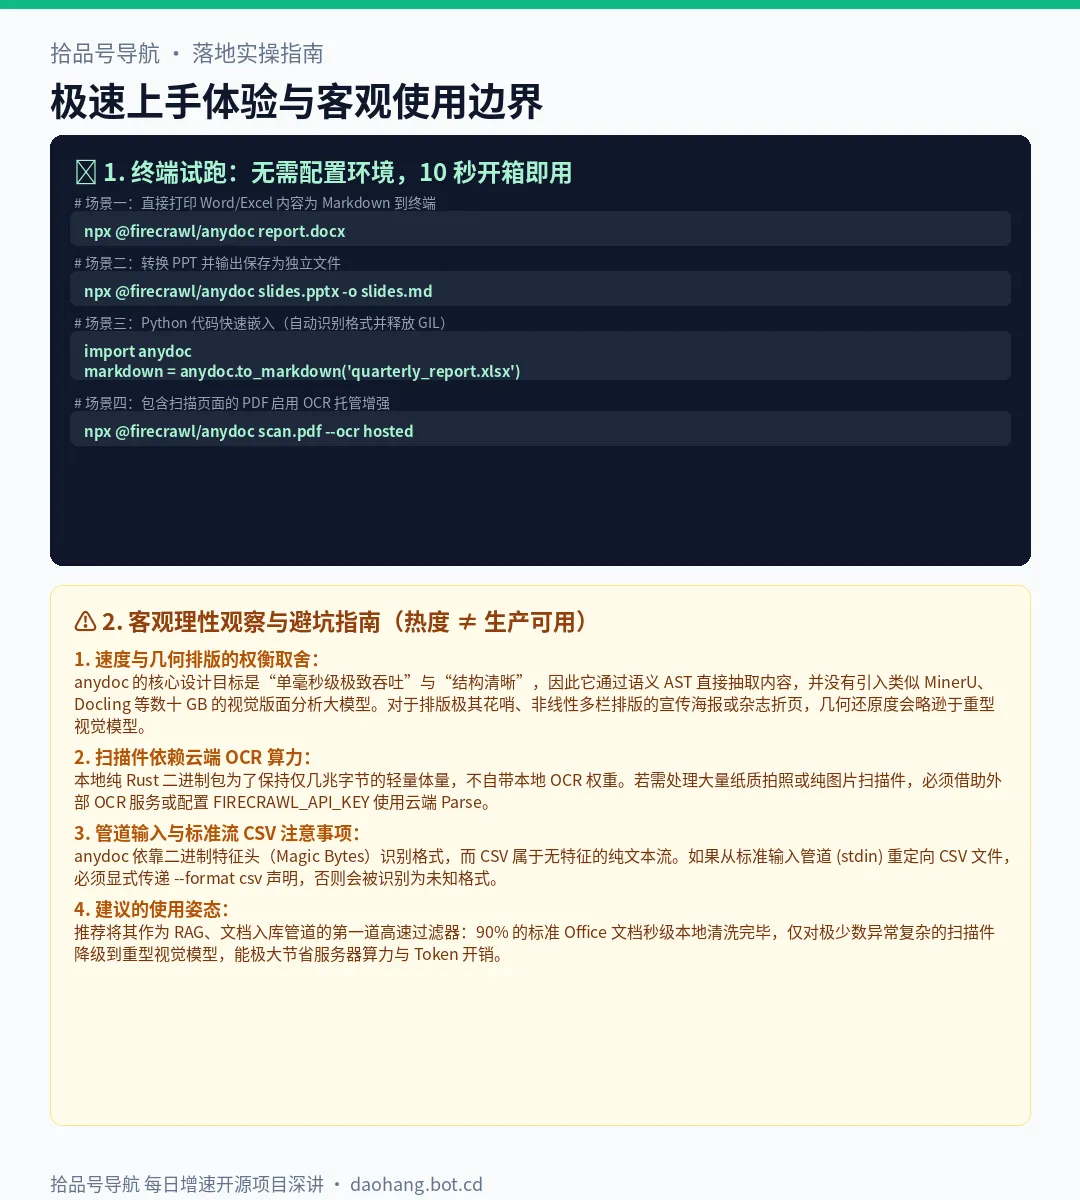
如果你想在本地机器上快速体验 anydoc 的转换效果,无需复杂的编译步骤,直接通过 npx 或几行代码即可实测:
npx @firecrawl/anydoc report.docxnpx @firecrawl/anydoc slides.pptx -o slides.mdimport anydoc markdown = anydoc.to_markdown("data.xlsx")npx skills add firecrawl/anydoc⚠️ 客观理性观察与避坑提示(热度 ≠ 生产可用):
1. 速度与复杂几何排版的权衡:anydoc 追求毫秒级极速吞吐与语义清晰度,未搭载体积庞大的端到端视觉模型。对于非线性多栏杂志折页等高度视觉化的版面,几何还原度弱于 Docling 或 MinerU;
2. 扫描版 PDF 需额外处理:本地引擎仅自带文本 PDF 解析,遇到扫描图片时会报错 NeedsOcr。如需处理图片扫描件,需开启 --ocr hosted 或外接 OCR 工具;
3. 无特征 CSV 需显式声明:CSV 文件因缺少二进制 Magic Bytes,在标准输入流(stdin)管道传输时需显式附加 --format csv。
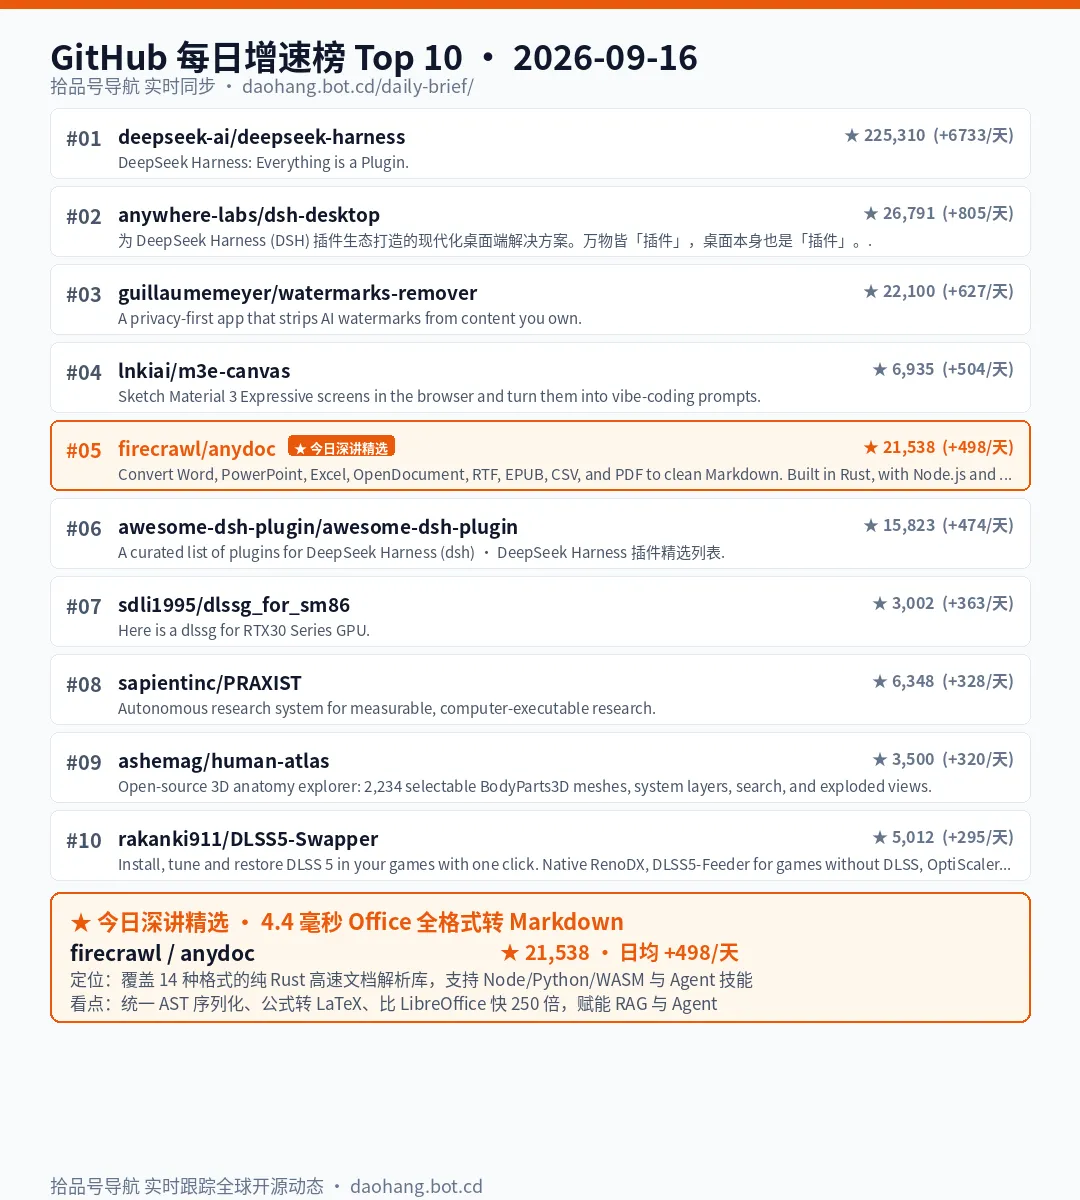
拾品号导航 · GitHub 每日增速榜
每日跟踪全球开源前沿动态,深度解析真正有价值的架构突破与高潜新秀。
daohang.bot.cd/daily-brief/
👇 点击文章底部【阅读原文】直达每日增速榜完整榜单