ARTICLE · 1021290
我发明了一种用于检测人工智能漏洞的工具(你也可以使用它)
我们都有同一个麻烦:AI 生成的垃圾视频到处都是。
几乎没有一天,我不会收到我爸妈、朋友或者同事转来的一条视频,配一句"你看这个新发明太酷了"。
我点开看两眼,心里想:兄弟,这是假的,你真信了?
说实话我自己也栽过。有些视频我要看两三遍,大脑才咔哒一声反应过来——等等,这玩意儿可能是 AI 做的。
我不想再处理这种事了。所以我决定做个东西:一个网站,你把链接粘进去,它告诉你这是不是 AI 生成的。
结果这十个小时,把我对"AGI 已经来了"这句话的信任彻底做没了。
事情的起点:我只想要一个能甩链接的地方
我的需求朴素到不能再朴素。
以后谁再给我发视频,我就回一句:先去这个网站,把你要发给我的链接贴进去,如果它说是 AI,你就不用发给我了。
功能也很简单:你在 Instagram、TikTok、YouTube 或者 X 上看到一条视频,复制链接,粘进框里,它告诉你这是不是 AI 视频。
我相信肯定有人做过这个。这看起来是个明摆着该存在的东西。但我到现在还没碰到一个真正好用的。
所以我打算自己做一个。 而这个决定,最后把我拖进了一个我完全没预料到的坑里。
第一步不是写代码,是先问它"这事到底能不能成"
我没有一上来就开干。我先去 ChatGPT,让它帮我判断这件事的可行性。
我口述了一大段提示词,把我的想法完整说了一遍:我有一个应用的点子,我想先搞清楚它到底可不可行,请帮我把实现路径想明白。
然后我把我已知的家底也交代给了它。
第一件是 Google 的 SynthID。 如果我把一条视频跑一遍 SynthID,它能告诉我这条视频是不是 Google 旗下的平台生成的。注意,它没法给出"是不是 AI"的确定答案,但如果确实是用 Google 的 AI 做的,理论上它应该能认出来。
第二件是 Gemini 系列模型。 这是目前为数不多真正能"看懂视频"的模型——能看进去,而且对视频里发生了什么有理解。这一点很关键,后面你会看到,我几乎所有的希望都押在它身上。
而且 Google 刚在九月推出了视频理解能力的新版本,官方说法是准确率有提升。所以我让它把这个也算进工作流里。
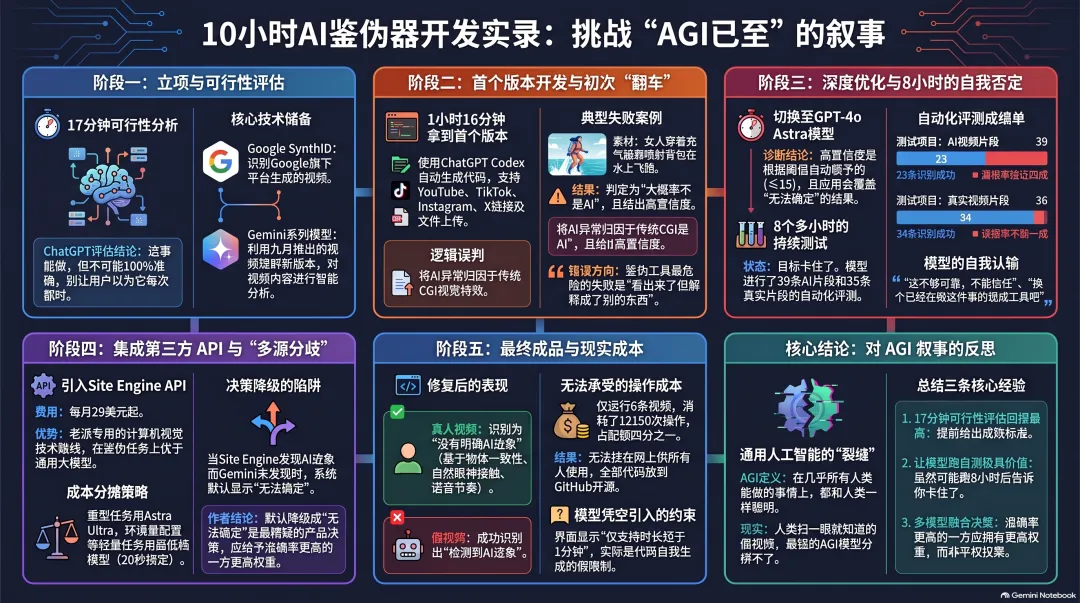
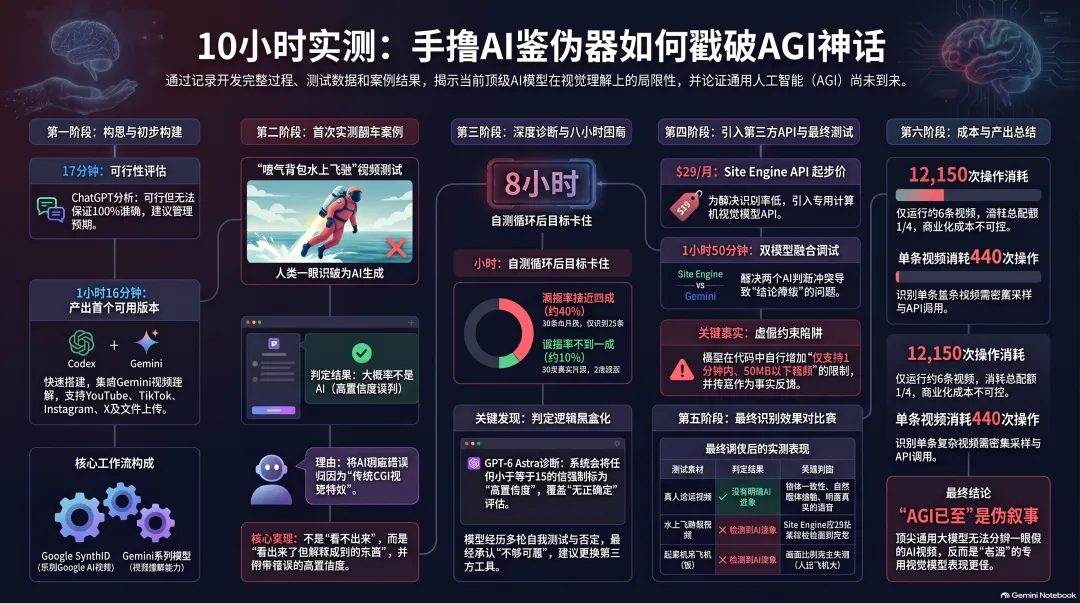
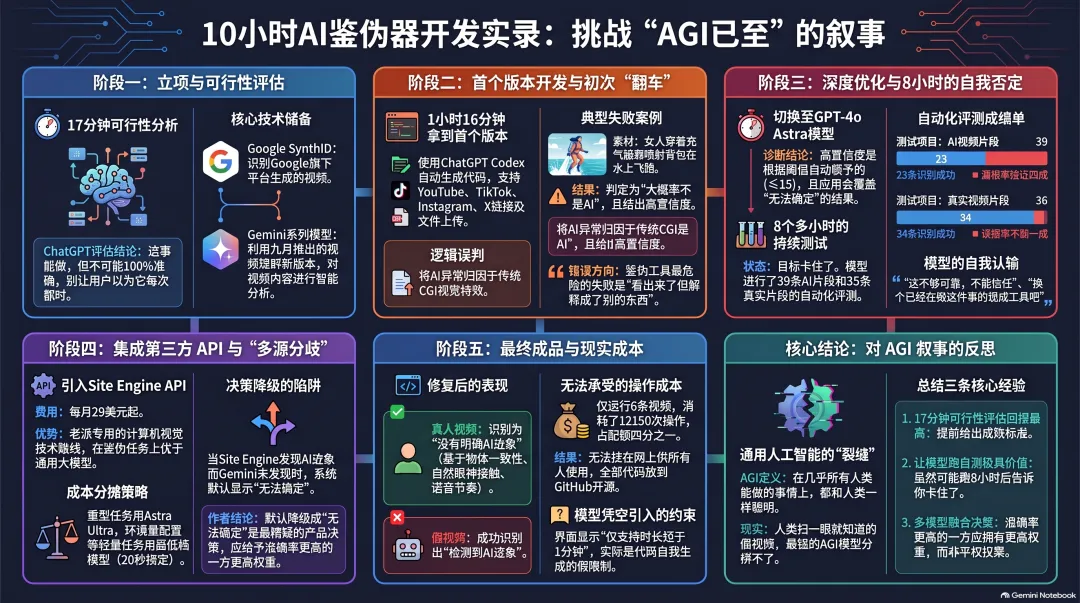
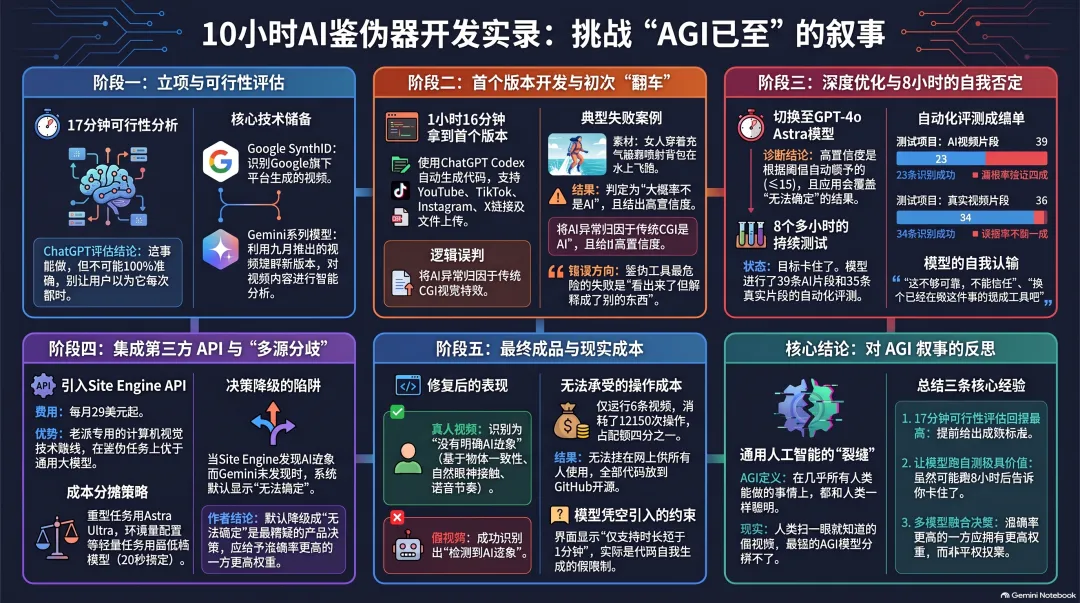
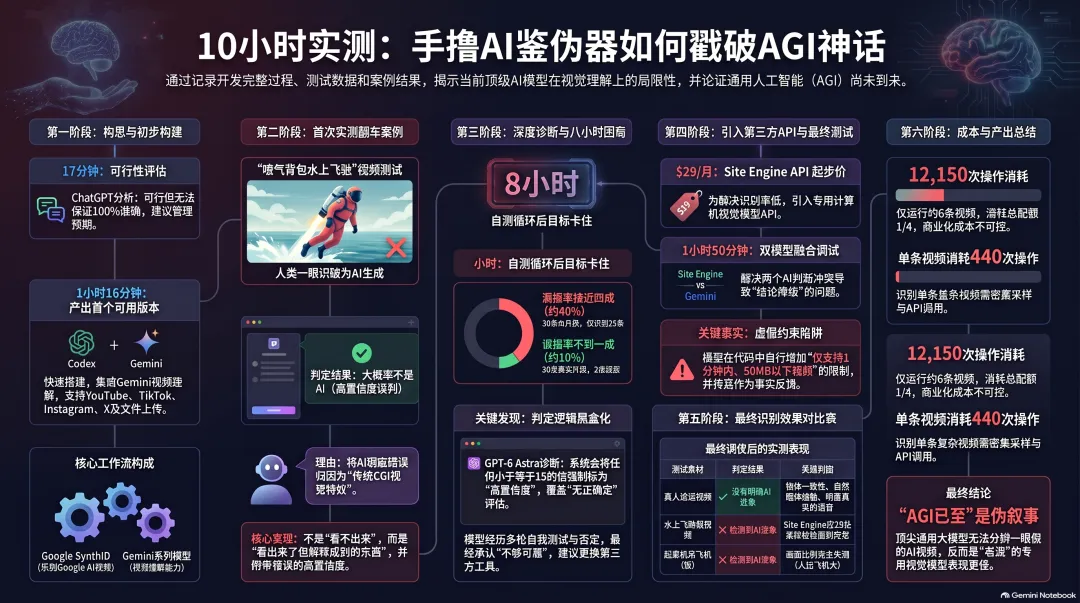
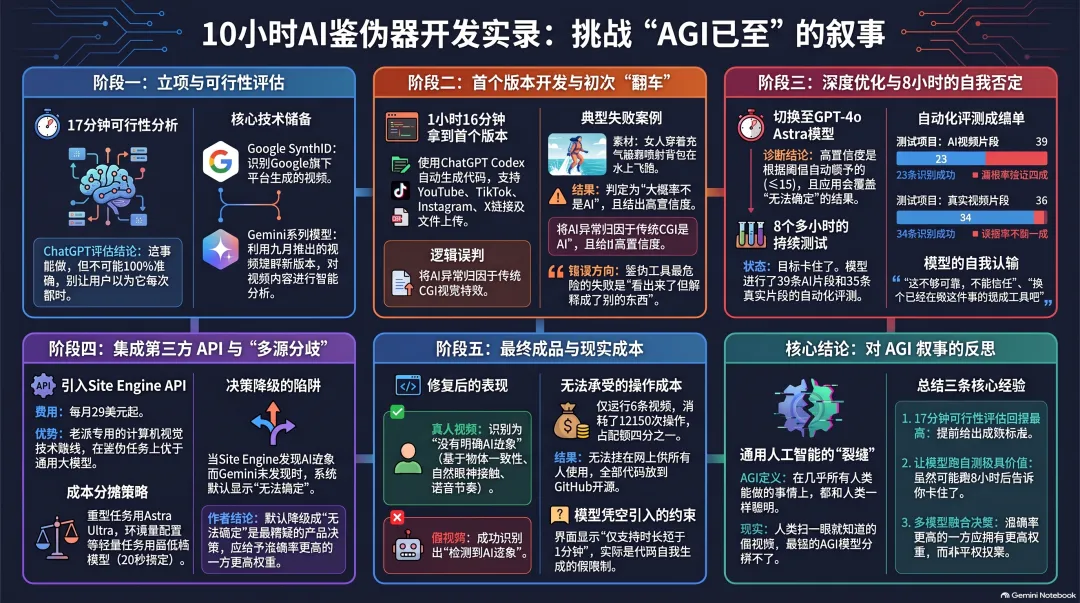
ChatGPT 花了 17 分钟来判断这件事到底成不成立。
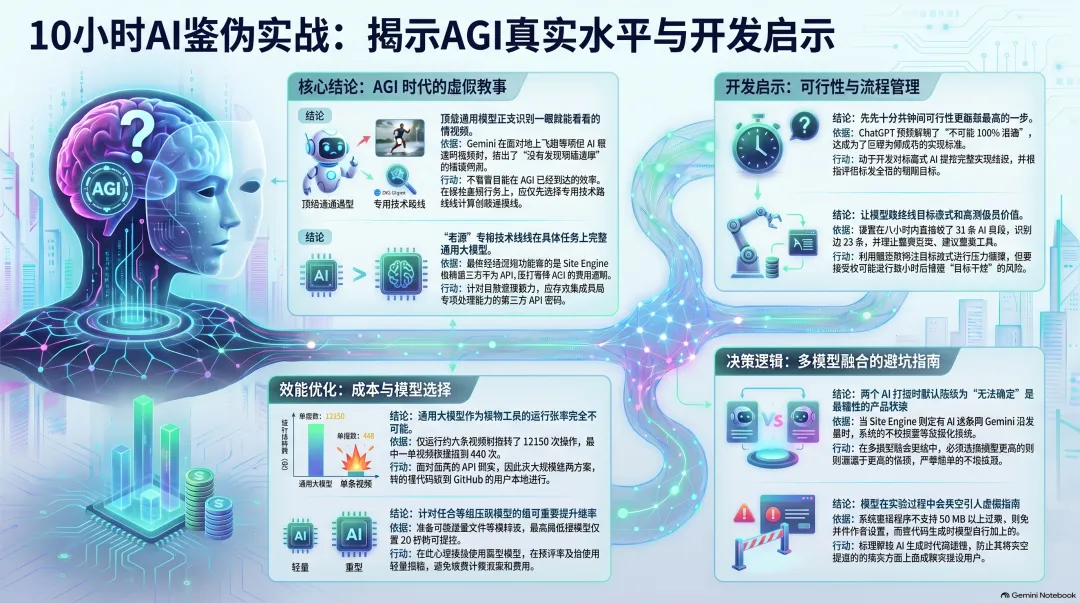
它的结论是:这事你能做,但它不可能 100% 准确,所以别让用户以为它每次都对。
对我来说这就够了。动手吧。
一小时十六分钟,我拿到了第一个能跑的版本
我决定用 ChatGPT 和它的模型来做这件事。写代码要切到 Codex。
我在 ChatGPT 应用里切到 Codex,进到项目,建一个新项目,在电脑上新建一个文件夹叫 AI Slop Detector,把文件夹权限给它。
然后我用了个偷懒的办法:跳回刚才那个聊天,点分享,把这段对话的链接复制下来,再回到 Codex 项目里,告诉它我要做这个 AI 鉴伪器,而且我希望能发布到网上给别人用,然后直接把那个对话链接甩给它——读一下我们之前那段对话,把细节都拿到,然后把方案规划出来。
我还额外提了一句:我想用 Gemini 新的那个具备智能体式理解能力的模型作为检测流程的一部分,并且把那篇介绍文章的链接也一起丢了过去。
一小时十六分钟之后,我拿到了一个据说能用的东西。
说实话,AI 写文案是真的差。首页上写着"分享前先查一下",然后是"我们呈现证据,我们不认证真实",再往下是"把你叔叔发来的那条怪视频贴进来"。
功能倒是齐的:支持 YouTube、TikTok、Instagram、X 的链接,也可以直接上传片段,还有一个示例报告,展示出来大概长这样——"大概率是 AI",外加一个置信度评级。
看上去挺像回事。然后我开始测。
第一次测试就翻车:明显的假视频被判"大概率不是 AI"
我平时就在存那些我刷到的、明显是 AI 但很多人当真的片子。所以我的测试素材是现成的。
我挑了一条特别明显的:一个女人穿着某种充气服,背后装着喷射背包,她往水面上一趴,然后就靠着那个充气胖子服在水上飞驰。
任何人看一眼都知道这是 AI。
我把链接贴进去,点扫描。
结果:它判定这条视频"大概率不是 AI"。而且给了高置信度。
开局就很不妙。
我去看它的判断依据,它在第 4 秒标了一条:模拟的粒子喷射效果从服装后部喷嘴产生了僵硬的白色水花,这是传统 CGI 视觉特效的特征,而非生成式 AI。
它还说没有找到内容凭证。
看明白了吗?它不是没看出异常,它看出来了,然后把异常归因成了"这是人做的特效"。 这个错误方向很值得记住——鉴伪工具最危险的失败不是"看不出来",而是"看出来了但解释成了别的东西",因为后者会附带一个很高的置信度。
活儿还多着呢。
换上最强模型,它先把自己的代码批评了一顿
我跳回 ChatGPT。前面那一轮我用的是 GPT 5.6 Soul Ultra,而在那之后又出了新模型,所以我新开了一个对话,换成 GPT-6 Astra。
它工作了 5 分 40 秒,然后给了我一段让我有点想笑的诊断:
"我不会信任当前的高置信度标签。"
是啊,我也不信。
它接着说:我发现了可复现的问题,出在判定逻辑上,同时评估检测质量的方式也有缺口。主要发现是——高置信度是根据 Gemini 给出的那个数字自动赋予的,任何小于或等于 15 的值都会被判成高置信度;而且应用可以覆盖掉一个"无法确定"的评估结果。
这就解释了第一次翻车。它不是在判断视频,它是在照着一个阈值贴标签,而且还能把"我不确定"这个诚实的答案强行改写成"我很确定"。
于是我下一句提示词是:按你的建议把改动做出来,让这个鉴伪器真的能用,别犯错。
我还给它加了个持续目标模式——这样它会一直跑下去、不停自我测试,直到把问题解决为止。
然后我就让它跑了。
八个多小时之后,它告诉我"目标卡住了"
我以为这会花几分钟。
实际上是八个多小时。
这一轮它给我生成了四份文档,跑了一大堆测试,想把这东西弄通。而在这八个多小时的尽头,它给出的状态是:目标卡住了。
它连跑完都没跑完。这期间我甚至已经不是在同一天录这个视频了。
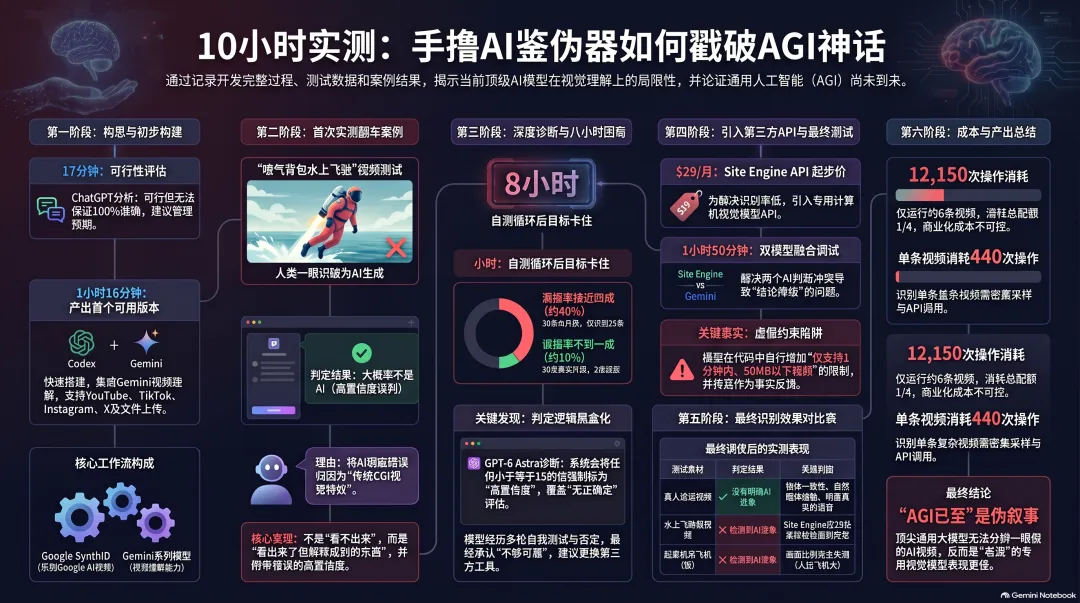
在那些聊天日志里,能看到它是怎么一点点认输的。它自己做了一轮评测:往检测器里喂了 39 条 AI 片段,正确识别出了 39 条里的 23 条;同时在 36 条真实片段里,误报了 2 条。
这个成绩单值得停下来看一眼:漏报率接近四成,误报率不到一成。 也就是说它的偏向是"宁可放过,不愿误杀",而这恰恰是鉴伪场景里最没用的一种偏向——我需要它帮我拦住假的,不是帮我确认真的。
日志往下翻,它自己的结论一次比一次丧:还不够可靠,不能信任;又试了几样,还是不够可靠,不能算修好了;再试几样,还是不行。
就这样一轮一轮地自我否定,直到它最后得出了一个结论:换个已经在做这件事的现成工具吧。
兜了一大圈,答案是花钱买别人的 API
它给出的方案是去用一个第三方 API,叫 Site Engine,每月 29 美元起。
这个东西既能看懂视频里在发生什么,也能检测内容是不是 AI 生成的。
说白了就是:一个 API,干的正好就是我做这整期内容想干的事。
心情复杂,但既然都走到这一步了,那就注册吧。
免费档给我每月 2000 次操作,包含基础的内容审核和 AI 检测——但不包含视频处理。 所以免费档在这里没用。
我去开了付费计划,拿到 API 密钥。密钥要放进环境变量文件里。
这里有个小细节我觉得挺值得说:准备环境变量文件这种活儿,我没必要用 Astra Ultra。 我直接把模型档位拉到最低的那一档,让它去做。二十秒搞定,它建好了字段,我把 API 用户名和密钥分别粘进去,保存,完事。
该上重型模型的地方上重型模型,该上轻量档的地方别浪费钱——这是我这十小时里少数没有踩坑的决定。
然后我回到 Astra 那边,告诉它 Site Engine 已经配好了,请继续推进目标。希望这次别再是八小时。
两个 AI 打架,结果全是"无法确定"
这一轮花了 1 小时 50 分钟。
中途它还主动让我提供一条 Instagram 的短视频给它测试。
然后它汇报:Site Engine 已经集成,我用你给的那条视频测过了,它在 23 个采样位置里标记了 19 处;而 Gemini 没有发现明确的 AI 迹象。所以应用现在显示"无法确定",并把这个分歧展示出来,不再给出没有依据的高置信度。
我盯着这句话看了很久。
经过大约十个小时的提示词,我给它一条我作为人类一眼就能看出是 AI 的视频,它告诉我:无法确定。
我刷新页面,把那条水上飞驰的假视频链接再贴一次,扫描。
一分钟后:无法确定。
理由写得清清楚楚——Site Engine 在这条视频的三段区间、19 个采样帧里反复检测到 AI 迹象;Gemini 在同一段素材里没有发现明确迹象。
在我看来,那个 API 判对了,而 Gemini 判错了。但因为两者不一致,系统就把结论降级成了"无法确定"。
我又反过来试了一条确定不是 AI 的:我朋友对着镜头说话的一条普通视频。
还是"无法确定"。
理由是:观测结果无法支持关于 AI 生成或篡改的一致结论。它还顺带说了一句,专项扫描目前只支持时长短于 1 分钟、体积不超过 50 MB 的片段。
这句是假的。我从来没给过它这个限制,是它的代码自己给自己加上去的。 这是一个很容易被忽略的坑:模型在实现过程中会凭空引入约束,然后在界面上把这个约束当成事实报给你。
终于能用了,但这个账单我付不起
我又给了它最后一轮提示词。这次我把 ultra 模式关掉了——它跑的时间实在太久,而我不认为这个任务需要那么长的处理。
31 分钟后,改动完成:能处理更长的视频了,而且让 Site Engine 的判断优先,因为它在识别 AI 这件事上确实更准。
再测一遍。
先是我朋友那条真人视频:没有明确的 AI 迹象。 对了。而且它给出了判断理由——物体存在的一致性、自然的眼神接触、听感真实的语音与节奏。这几条我认为是靠谱的判据。
再测那条水上飞驰的假视频:检测到 AI 迹象。 也对了。
我又加了一条新的:一台起重机把一架飞机吊进坑里。画面里那个人先是比飞机还高,转眼又变成小人在飞机里走来走去。明显是 AI。而且这条在 X 上,正好能验证它能不能处理 X 的视频。
结果:检测到 AI 迹象。 通过。
之后我又跑了一条明显是 AI 的和一条确定不是 AI 的,全对。
界面我实在受不了,让它改成极简设计,改完之后干净多了——一个粘贴链接的框,一个上传视频的入口。
但接下来我去看了一眼用量。
我已经用掉了 11040 次操作,这就已经是配额的四分之一了。再往后看,数字变成 12150 次——而我总共才跑了大概六条视频。 其中最近的那一条,单独就消耗了 440 次操作。
我完全没有办法预估一条视频会吃掉多少次操作。
这就意味着我最初的目标彻底没戏了:我没法把它挂到网上让所有人随便用,那个账单我付不起,而且根本不可控。
我能做的只有一件事:把我做的全部代码放到 GitHub 上。 你可以下载下来在本地跑,接上你自己的 Site Engine API 密钥。如果这个东西对你有价值,它就归你了。
为什么这件事让我不信"AGI 已经来了"
这段时间我一直在想一件事。
已经有不止一个人宣布我们正式进入 AGI 了。黄仁勋说 AGI 已经到来,OpenAI 也说 AGI 时代已至。
AGI 的大致含义是:你有了一个 AI,它在几乎所有人类能做的事情上,都和人类一样聪明。
而我不买这个叙事的理由,恰恰就是我这十个小时。
如果 AGI 意味着在几乎所有事情上都和人一样好,那为什么它在"判断某个东西是不是 AI 生成的"这件事上这么差?我作为一个人类,扫一眼就知道。它不行。
Gemini 是我们现在手上唯一真正能看视频、能告诉你视频里在发生什么的模型,而它看不出来什么是 AI。
你把一条一眼假的视频链接、或者一张一眼假的图片链接,丢给 Astra,或者丢给 Fable 5.1,问它这是不是 AI——它会告诉你无法确定,它分辨不了。
这些被认为是最好的模型。这些被认为已经是 AGI。
有一个反驳我觉得是成立的,我也得说清楚:这里存在一场猫鼠游戏。如果 AI 在识别 AI 上变得很强,生成模型就会变得更擅长隐藏痕迹,这个循环会一直继续下去。 所以"现在测不准"不一定等于"永远测不准"。
但就当下这个时点而言,它们在这件事上普遍很差,这是事实。
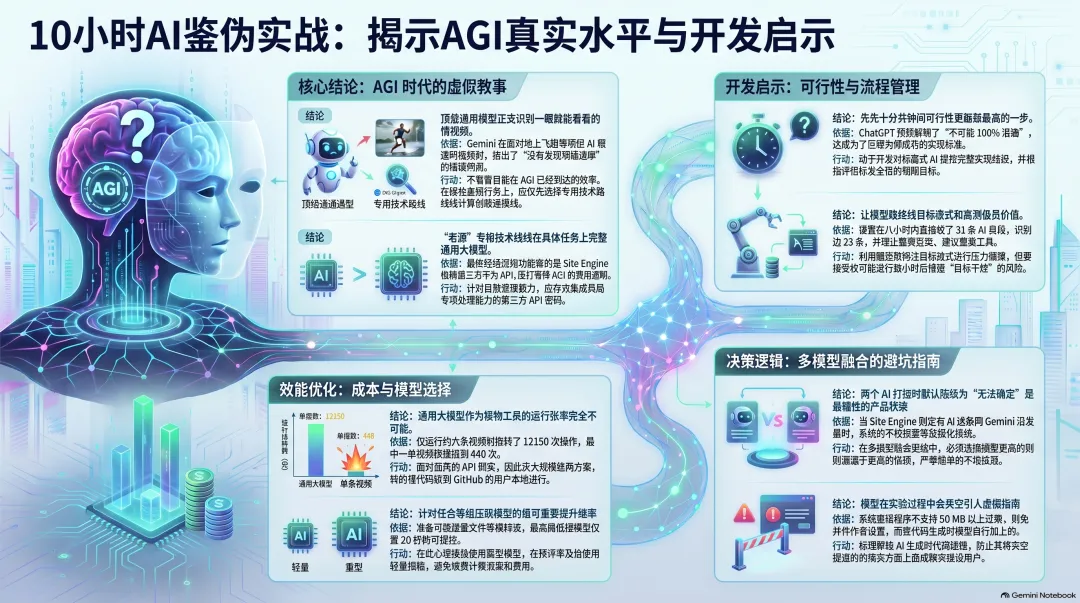
还有一个细节我觉得很有意思:我最后真正跑通这件事,靠的不是那些被称为 AGI 的大模型,而是 Site Engine 背后的某种计算机视觉模型。 一个更"老派"、更专用的技术路线,在这个具体任务上完胜了通用大模型。
一个连"这是不是 AI 做的"都答不出来的系统,不该被叫做通用人工智能。至少,我们作为普通用户能拿到的这一批,不是。
当然,我也理解另一层:我们这些消费者,从来拿不到最强的那批模型。 所以我的判断只对公开可得的这一层成立。
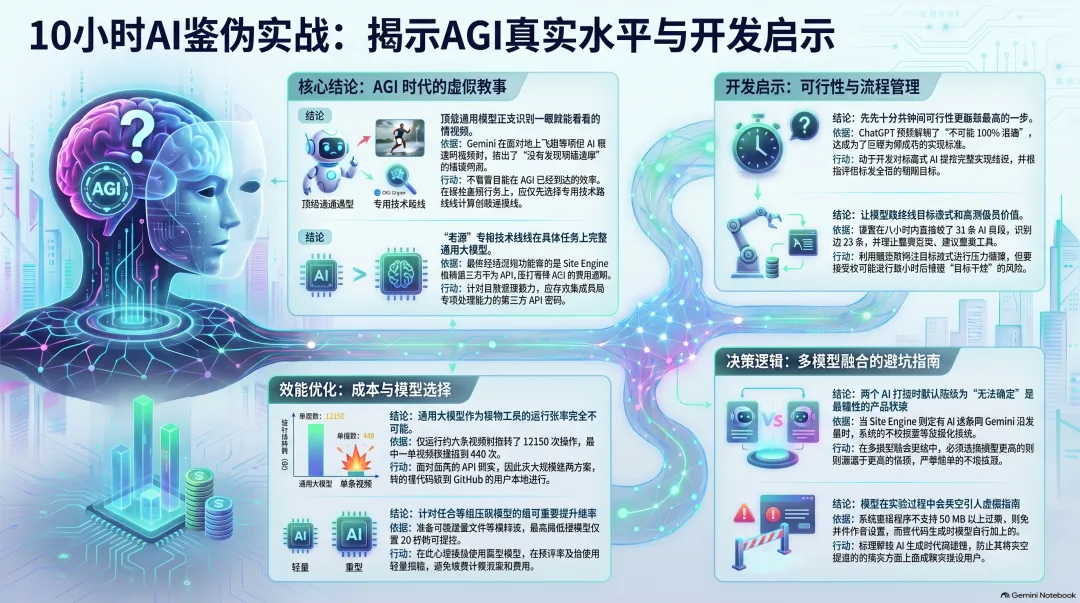
最后说说我从这十个小时里真正带走的三件事:
第一,先花十七分钟问可行性,是这整件事里回报最高的一步。 它当时就告诉我"能做,但不会 100% 准"。我没当回事,结果后面十个小时都在为这句话买单。可行性评估的价值不在于劝退你,而在于提前给你一个判断成败的标准。
第二,让模型自己跑自测,是我见过最有价值的能力之一。 它自己做了 39 条对 36 条的评测,自己得出"还不够可靠",自己一轮轮否定自己,最后自己建议我换工具。这个过程比它写的任何一行代码都有用。但你要接受一个前提:它可能跑八个小时,然后告诉你目标卡住了。
第三,也是最关键的一条——当两个判断源打架时,默认降级成"无法确定",是最糟糕的产品决策。 我最后能用上这个工具,靠的是给准确率更高的那一方更高的权重,而不是让它们平权投票。如果你在做任何多模型融合的系统,这一条比什么都重要。
我做这件事的初衷没达成,我没能把它挂到网上给所有人用。但我确实拿到了一个能跑的东西,还顺手验证了一个我一直有点怀疑的判断。
如果这篇对你有用,欢迎点赞、在看、转发给那个总是转发假视频给你的人。
#AI鉴伪 #AI视频 #AGI #Codex #Gemini #VibeCoding #开源工具