ARTICLE · 1025557
30行代码搭本地知识库,公司文档随便问
知识库很难搭?
30行代码搭本地知识库
公司文档随便问
RAG · Python · 本地部署
智能创作笔记
📦 5 Parts + Conclusion
👉 滑动
PART 01
装两个库
环境准备
PART 02
切文档建索引
代码讲解
PART 03
问它就完事
检索演示
PART 04
踩过的坑
避坑指南
PART ///
写在最后
我的建议
不用联网、数据不出公司,30行核心代码就够
公司文档散在十几个Word和PDF里,每次找东西都要翻半天。我花一晚上搭了个本地知识库,把文档喂进去,直接对话问它「报销流程怎么走」「上季度销售额多少」,它立刻翻出原文。关键是不用联网、数据不出公司,30行核心代码就够。
01
PART
先装两个库
ENV SETUP · 环境准备
一个负责把文字变成向量,一个负责快速检索。都是本地跑,免费,笔记本就能带得动。不用申请API、不用把数据传到别人的服务器,这一点对很多公司来说是硬需求。
pip install sentence-transformers faiss-cpu
02
PART
把文档切好、建索引
BUILD INDEX · 代码讲解
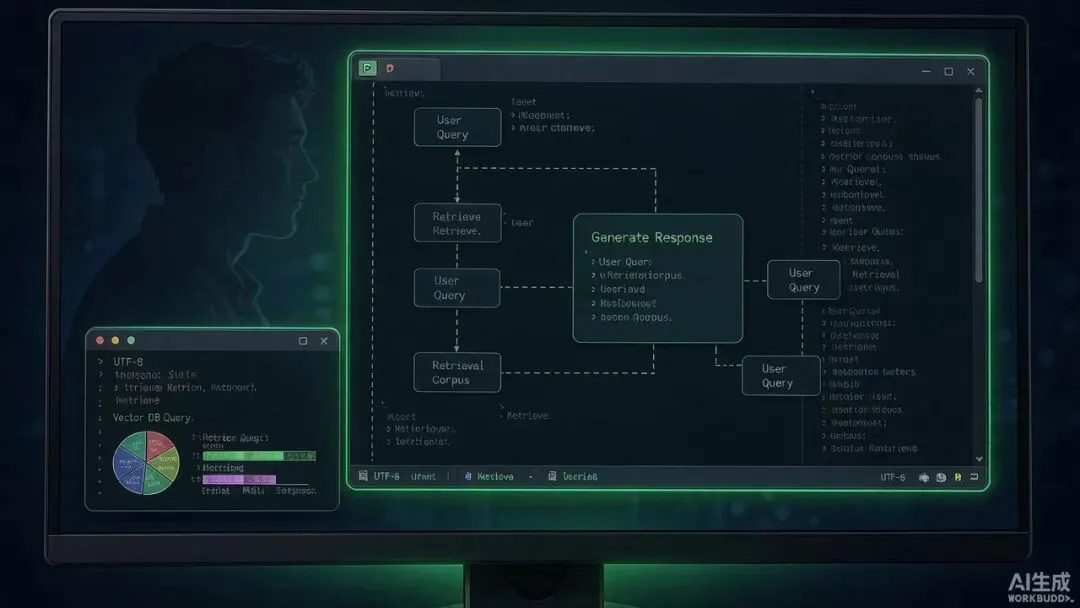
思路其实特别朴素:把每篇文档按段落切开,每段变成一个向量存进Faiss。所谓向量,你可以理解成「这段话讲了啥」的数字指纹。问问题的时候,也是把问题变成向量,找最像的那几段原文。
这里有个细节:中文一定要用多语言模型,别用纯英文embedding,否则搜不准。我第一版偷懒用了英文模型,问「请假流程」结果它给我翻出一段英文术语表,当场翻车。
from sentence_transformers import SentenceTransformer
import faiss, os, glob
model = SentenceTransformer('paraphrase-multilingual-MiniLM-L12-v2')
chunks, paths = [], []
for f in glob.glob('docs/*.txt'):
for blk in open(f, encoding='utf-8').read().split('\n\n'):
if blk.strip():
chunks.append(blk.strip()); paths.append(f)
vecs = model.encode(chunks)
index = faiss.IndexFlatL2(vecs.shape[1])
index.add(vecs)
03
PART
问它就完事了
QUERY · 检索演示
跑起来,它会把最相关的三段原文和出处文件打出来。想接对话,把这三段塞给任意大模型当上下文就行,它就会用大白话回答你,还附带出处。
q = model.encode(['报销流程怎么走?'])
_, ids = index.search(q, k=3)
for i in ids[0]:
print(paths[i], '→', chunks[i][:120])
效果大概是这样:
我问「年假怎么算」,它返回《员工手册》第几页那句话,而不是编造一个答案
04
PART
几个踩过的坑
PITFALLS · 避坑指南
!踩坑提示 🕳
切太碎会丢上下文,一段最好保留完整一个小节,别按句子硬切;图片里的表格、扫描件得先OCR成文字,否则它看不见。
中文用多语言模型,否则搜不准
文档多就加标题加权,命中率明显提升
///
LAST
写在最后
MY ADVICE · 我的建议
这套方案适合中小团队和个人。文档几百篇以内,笔记本就能跑,今晚就能搭起来。真要上规模、要权限管理、要多人协作,再考虑商业向量库,那又是另一套成本了。
别被「知识库」三个字吓到,本质就是切文档、转向量、按相似度找这三步。先跑通最小版本,再慢慢加功能,比一上来搞大平台实在得多。
既然看到这里了,如果觉得有用,随手点个赞、在看、转发三连吧。
THANKS FOR READING