ARTICLE · 1028150
一个AI Infra菜鸟的实习碎碎念~
✅我是丁师兄,专注于智能驾驶大模型,持续分享LLM面试干货。
✅大模型1v1辅导,已帮助多名同学成功上岸
offer捷报
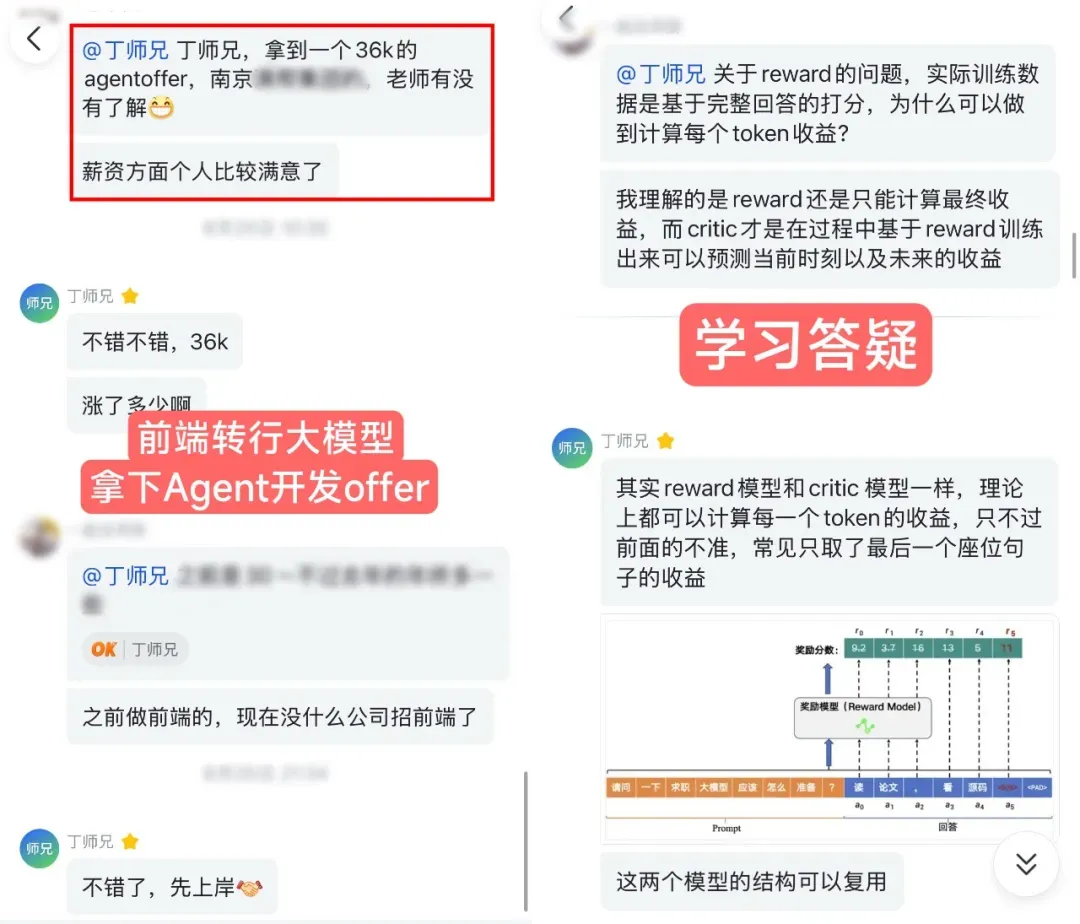
坐标南京的学员,年龄30+,成功从前端转到Agent开发,薪资36k。在AI冲击的当下,主动求变,开启职业生涯第二春!
需要大模型1v1辅导的同学,私信我上车。方法+实战+陪跑,带你一步步把offer拿稳。
从五月底实习到现在已经过去三个多月了,秋招是看起来毫无机会,回想当初实习找的就不顺利,很多都是简历挂或者一面挂。
后来很幸运来到现在的这个组,对我来说“AI infra 味很正”,虽然不是我最想搞的 MaaS,但只要是 AI Infra 我就干,当然我也没得选。
入职之后,遇到了很好的 mentor,后来因为机缘巧合我直接归+2 管,+2 也非常懂技术,头脑清晰,典型的高精力人。
虽然因为他平常很忙,跟他的直接交流不多,但是平常开日会的讨论和他对工作方向的拨乱反正对我启发很大,比读研爽多了。
我被安排的任务是去搞低时延推理,也就是引擎服务一个请求怎么能更快的吐 token 出来,我负责的主要是 attn 的优化,因为 GLM 没怎么换架构,所以本质上是对 DSA 做优化。
这项工作贯穿了我实习阶段的大半,到此刻落笔也算是告一段落了。
我加入低时延推理这个方向的工作时,负责的同事让我熟悉熟悉文档,当时我的认识里有两个关键词,一个是 TileRT,一个是 Mirage。
之前的工作内容是我没接触过的,后来对已经积累的文档进行考古,有对 TileRT 的 trace 采集, 还有对一些对学术界 MegaKernel 工作的分析,其中就有 Mirage,也是后来接近 50 天的工作内容。
这是对标的是 TileRT-v0.1.3, 这个版本的 TPS 就很高了,但实际上我加入后的没几天,TileRT 就更新到了 v0.1.5,这个版本的性能达到了让我瘫坐在椅子上一晚上的恐怖数值。
这晚我印象很深,我下午测完 TileRT 的性能就感觉头皮发麻,一直头晕到晚上,而+2 估计在忙完别的事情后,还能在群里冷静分析后续该怎么做。
我拿着手机翻完群聊的消息,秉持着深夜思考纯属内耗的想法,直接睡觉,什么都等第二天再说吧。
这是一件非常值得反思的事情,TileRT 更新到 v0.1.5 是七月的事,而我采 trace 已经到九月了,也就是说九月份才开始追两个月前的 SOTA,才知道人家能做到什么程度。
还有基于 SGlang 去开发,盯着 0.5.12 这个版本做了三个月,社区都迭代到 0.5.18 了,还是对着这一个版本死磕。
在 AI Infra 这个按天迭代的行业我都无语的想笑,我问自己这是怎么了。
在年初学习 vllm 的时候,我都是有必须同步 main 分支所有 commit 的强迫症,哪怕和我的改动无关,我就不能看到 github 提示我 PR 需要 rebase。
一旦 release 更新就看看别人做了什么工作,修了什么 bug,这些习惯在两个月后就灰飞烟灭了。
那会儿没有卡用,自己只能买得起 GPT Plus,还能十足热情的去追逐行业的动态,现在有最先进的卡,有了 token 开火权,反而懈怠了。
八月份我就想过要不要测一下 TileRT 最新的版本,后来没这么做的原因一是那会儿没 B200 用了,TileRT 只能用 B200。
我也问过同事要不要测新的,答复是先跟 v0.1.3 打平,现在想想真是无语,那会儿想着我就是实习来的,先把让我做的活做完,不测就不测了。我在老油条这方面还是远远领先他人的。
接下来进入对 Mirage 这个框架的适配阶段。这里获得的成果,只能用"对 MegaKernel 积累了新的经验,对现有工作有了新的认识"来总结了。
一件事,在 mirage 开源的框架内实现 attn 的 MegaKernel,后来就是长达五十天的在框架内重新实现 kernel,跑 bench,不断重复。
我一开始的任务是给已经写好的 kernel 做精度验证,看看能不能 bit 一致, 不能的话找出原因,测精度需要接触每个 kernel,也算是为后面所有的工作定下了一个基础。
后来一个同事对 mirage 这个框架进行减负,也就是删掉其中动态调度的部分,静态的把计算图编好就行。
但是后来发现这个框架依然很重,虽然把 kernel 分解成了 task,但不同任务间还是有同步点,耗时不比 cudagraph replay 时的间隙小。
还吸取到的经验是:MegaKernel 是一个 kernel,而 attn 计算里不同的算子对资源的需求是不一样的,topk 计算就需要 CTA 有很多线程,但 GEMM 并不需要那么多,强行放在一个 kernel 里反而会导致性能退化,这也是后来放弃这个框架的主要原因。
现在问题来了,attn 适不适合做 MegaKernel。deepseek 前天把算子库更新了一遍,很多计算环节也都 mega 化了,但 attn 却没有。
从这个角度出发想,人家那么厉害,都没做,那我不做也挺合理的,但没准人家正在做呢,“才华被埋葬哥”不是搞的就是 attn 部分的算子吗。
当然我也觉得一味的追求 Megekernel 也是不理智的,具体问题要具体分析,moe 合适 attn 不一定合适,因为 attn 在算法上的同步点太多了,都在破坏 GEMM 之间的 tile 流动,从直觉上想就不太合适 Mega 化。
不过我的任务是手搓 SparseMLA 这个 kernel,因为 trtllm 的实现没开源,我就只能在 GPT 大人的帮助下去做了。
先学习了 FA4 高超的技术,但发现 bs=1 下,这 kernel 纯纯的 latency bound,提高并行度就完事了,最后也是靠着及其特化的实现比 trtllm 的实现快了 1us。
之后的事情更是出乎我的意料,负责 attn 的同事离职了,任务一下子落到了我头上,好在之前工作的积累,让我对 DSA 执行的算子 DAG 图有了认识。
接下来就是开干,直接在 sglang 里实现一个特化路径,也不搞什么别的框架的介入了,每次测性能直接端到端看 TPS 就完了。
此时就不得不提到社区的实践积累了,PDL 的加入,Kernel Fusion,通信和计算掩盖,BBuf 大佬转发过一篇文章,是对 KimiK3 的优化,那篇文章的图画的很好,一目了然,我也是按照相同的思路做的。
那段时间就是面向 nsys 编程,我看哪个 kernel 不顺眼,就让 opus5 给我优化,能融合的融合,SM 有余量的就并行,sglang 内已经融合好的算子拆开再融到别的算子里。
最后在另一个同事帮忙优化了 GEMM 的实现后,也算是在 attn 成功追上了 SOTA。
这段时间的工作很充实,因为迭代速度是按小时来的,opus 和我一起想点子,然后他把实现,测试,bench 都完成,我再看新的 nsys,再接着讨论。
这里讨论的目的是我要跟领导汇报,所以我得懂 AI 做了什么,我成学生模型了,opus 自己很多就全能完成了,我切屏看别的去了,只是进行必要的同步。
deepseekv4.1 一出,TPS 能到 800,还主要靠 AI 自主实现,我就知道,对于过去,我做的东西,用的手段和方法没有走上歪路。
但是对于未来,正如“才华被埋葬哥”说的,agent 太强了,算子开发在明年可能真的完全自动化实现了,他可以靠自己的能力去“转行”,但是我估计没什么机会了。
我真正坚定想搞 ai Infra 是看了去年 kuntai,yihua 和月亮大叔一起做的博客,感觉是我研究生生涯的精神导师,我几乎期期必看,那会儿想去做开源,想为 AGI 做贡献,但实验室的沟槽事太多了,也没啥资源,连卡也租不起。
今年一月份有个播客,openai 搞 RL Infra 的翁兄,更坚定了我的信念。后来给 vllm 搞了几个 PR,也找到了 AI Infra 的实习。
但是天下英雄如过江之鲫,光清北的人才就远胜于我,差距是客观且巨大的,最近的秋招更是告诉我一件事,“哪有那么多机会等你啊”,面试是寥寥无几的,找实习的时候还能有不少邮件,现在几乎杳无音讯。
但我还是很开心能搞 ai Infra,了解到这么多人的先驱一般的工作,在公司感觉到整个行业的飞速前进,每天能接收到很多新鲜的,充实的知识。
人才密度也是前所未有的高,有 AI 的帮助,又能讨论问题的同事,更不用说互联网上各位人才分享的材料,直播,播客,真是让我受益匪浅。
虽然感觉后面跟 AI Infra 大概率无缘了,但还是很高兴能为 AGI 的发展做出一点点浅薄的贡献。
Learn from best!
作者:溪枬
来源:https://zhuanlan.zhihu.com/p/2083699922654736754
✅我是丁师兄,专注于智能驾驶大模型,持续分享LLM面试干货。
✅大模型1v1辅导,已帮助多名同学成功上岸
微信:dsxaigc