ARTICLE · 1041739
让 LLM 像人一样翻文档:目录树索引 + PageIndex 式 Agent 检索
快速阅读(30 秒速览)
向量检索把文档"撕成碎片",章节级问题(“第三章的安装要求是什么”)天生吃亏——碎片没有"位置感" 人类查文档的路径是:翻目录 → 锁定章节 → 读内容。EasyRAG 把这条路径搬进了 RAG 入库侧:零 LLM 的 Markdown 标题解析建树( structure.rs)+ LLM 章节摘要(summarizer.rs)查询侧两条路:TreeSearch(逐层 LLM 推理选枝,路径确定)和 StructureAgent(PageIndex 式自主探索,LLM 自己决定调什么工具) 全程带安全阀:小文档零 LLM 调用优化、工具调用上限、失败降级不炸管线
向量检索没有"位置感"
先想一个场景:你的知识库里有一份 200 页的产品手册,用户问:
“第三章讲的安装流程里,对内存的要求是多少?”
向量检索会怎么做?把问题编码成向量,在几百个 chunk 里找相似度最高的 top_k。问题来了——
"内存要求"这句话可能出现在第三章,也可能出现在附录的 FAQ 里,向量分不清它们谁"属于"第三章; 用户明确给了导航线索(“第三章”),但切块之后,"第三章"这个结构信息只剩下 chunk metadata 里一个不起眼的字段,相似度计算根本用不上它; 更尴尬的是"这份文档整体讲了什么""第二章和第四章的结论矛盾吗"这类结构性问题——答案不在任何单一 chunk 里,而在 chunk 之间的组织关系里。
核心矛盾: 向量检索把文档当成"一堆碎片的集合",而人类把文档当成"一棵有目录的树"。碎片没有位置感,树有。
GraphRAG 用"图"补关系,但图要自己抽实体、建索引,成本不低。而目录树是文档作者免费送给你的结构——Markdown 标题、章节层级,解析起来一次 LLM 调用都不用。这就是 PageIndex 思路的核心:先理解文档的组织方式,再让 LLM 像人一样顺着目录找答案。
整体链路:入库建树,查询爬树
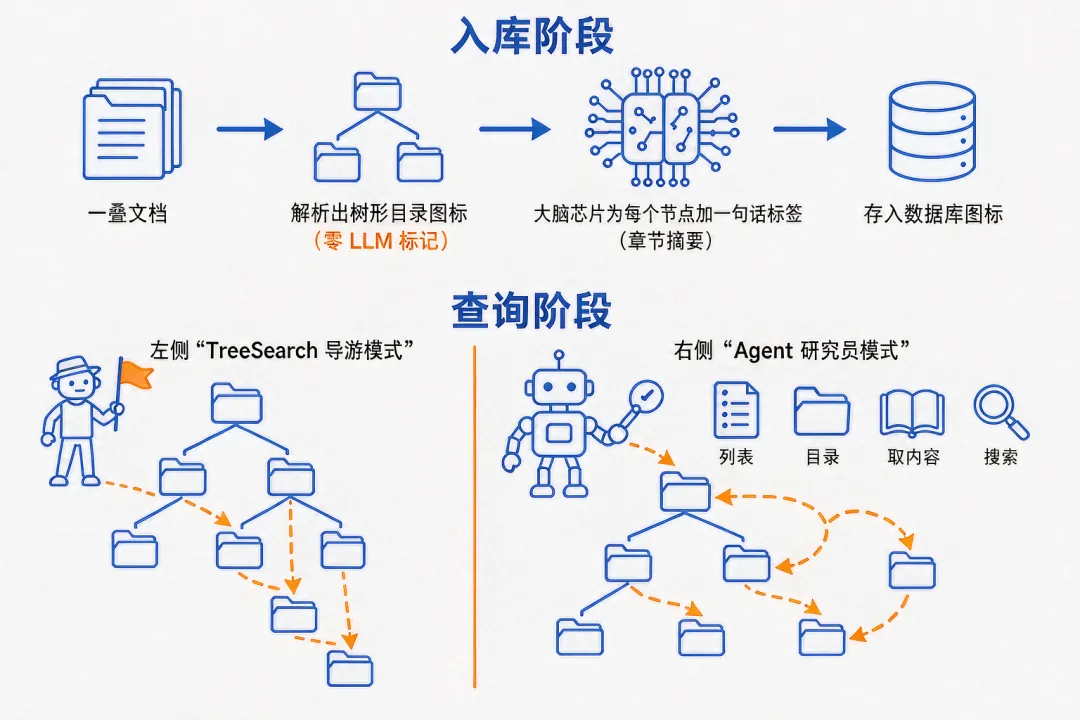
入库阶段:文档 → 解析 Markdown 标题 → 构建结构树(零 LLM)→ LLM 为每个章节生成一句话摘要→ 结构索引写入 KV 存储(STRUCTURE_INDEX_KEY_PREFIX + docId)查询阶段(两条路,可独立使用):路径 A · TreeSearch:问题 → LLM 逐层推理选枝(目录 → 章节 → 小节)→ 取选中章节的原文 → 生成答案路径 B · StructureAgent:问题 → LLM 自主调用 4 个工具探索文档→ 直到攒够证据 → 生成答案
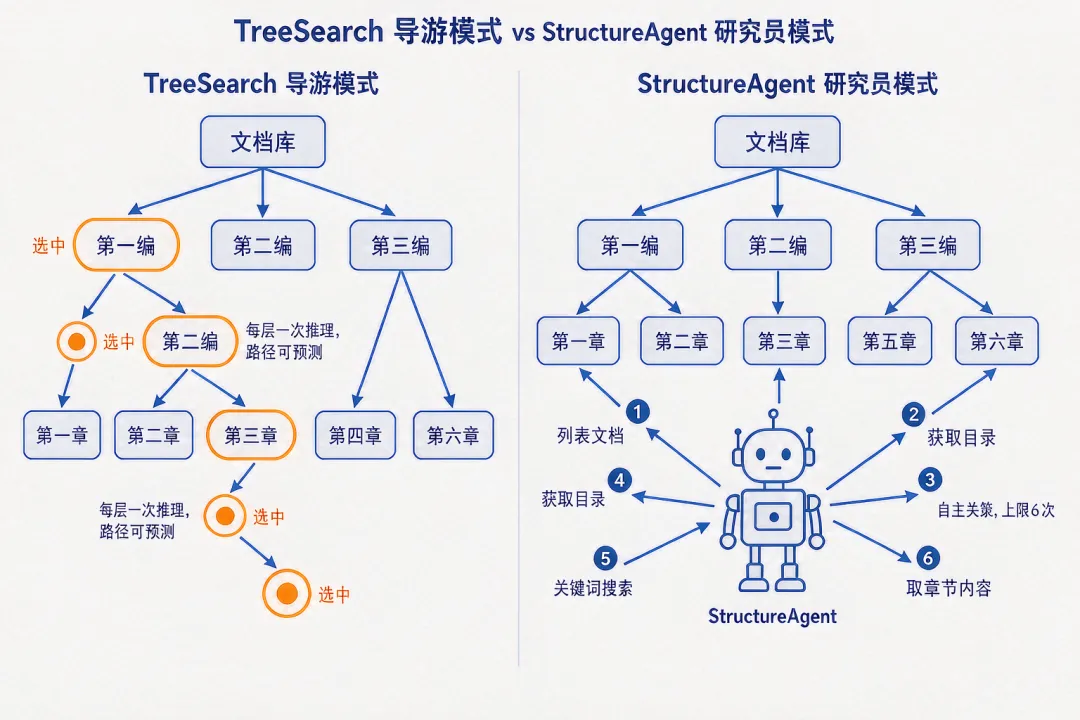
两条路的区别一句话说清:TreeSearch 是"导游带着走"(流程固定,LLM 只在每一层做选择题);StructureAgent 是"研究员自己逛"(LLM 自己决定下一步干什么)。下面分别拆。
入库:零 LLM 建树 + LLM 摘要
建树:能不调 LLM 就不调
pipeline/src/structure.rs 的 StructureTreeBuilder 是个纯粹的解析器:
pub fn build(&self,content: &str,doc_id: &str,doc_title: Option<String>,) -> Option<DocumentStructureIndex> {if content.trim().is_empty() {return None;}if crate::heading::has_headings(content) {let sections = self.build_tree_from_headings(content);if !sections.is_empty() {return Some(DocumentStructureIndex {doc_id: doc_id.to_string(),doc_title,doc_description: None, // 等摘要器来填sections,total_chars: content.len(),version: 1,});}}None // 没有标题的文档:坦率返回 None,不硬造结构}
三个设计细节:
has_headings前置判断:没有 Markdown 标题的文档直接返回None,调用方跳过结构索引——一份流水账日志硬要建目录树,只会给查询阶段喂垃圾;- 父栈法建树:
build_tree_from_headings用一个栈维护"当前章节链",遇到#到####的标题就按层级挂到父节点下,最大深度max_depth默认 4 层——再深的层级对检索导航没有价值,只会稀释 LLM 的注意力; - 字节偏移对齐:
content_start/content_end用字节偏移而非字符数,与 Rust 解析器的产出保持一致,后续按章节取原文时不会切出乱码边界。
摘要:给每个章节配"一句话导购"
光有目录标题还不够——“3.2 环境准备"这个标题告诉 LLM 的信息太少了。summarizer.rs 的 DocumentSummarizer 负责给树"填肉”:
pub async fn generate_doc_description(&self, content: &str) -> Option<String> {if content.trim().is_empty() {return None;}let truncated: String = content.chars().take(8000).collect();// DOC_DESCRIPTION_PROMPT:用一句话描述整份文档match self.llm_service.complete(&LlmRequest::new(prompt).with_temperature(0.0)).await{Ok(result) => { /* 空结果也返回 None */ }Err(e) => {tracing::warn!("Failed to generate document description: {e}");None // LLM 挂了?不要这份摘要,树照常用}}}
注意这个返回值是 Option<String> 而不是 Result:摘要是增强,不是必需。LLM 超时、限流、输出为空,都只是"这棵树暂时没有摘要",而不是"入库失败"。这个"增强型功能必须可降级"的原则,和第 10 篇并发入库的设计一脉相承。
temperature(0.0) 也值得一说:摘要是给后续检索导航用的"路标",要的是稳定可复现,不是文采。
路径 A:TreeSearch——逐层推理的"导游模式"
query/tree_search.rs 的 TreeSearchEngine 模拟的是人类专家翻目录的动作:每次只看一层,选出最值得深入的 1~3 个分支,再钻进去看下一层。
小文档优化:别用大炮打蚊子
搜索入口先做一次判断:
// Small document optimization: ≤8 top-level leaf nodes → select// all without any LLM call.if top_level.len() <= 8 && top_level.iter().all(|s| s.children.is_empty()) {tracing::debug!("Small document ({} leaf sections), selecting all without LLM",top_level.len());return Ok(TreeSearchResult {selected_sections: top_level.clone(),reasoning_chain: Vec::new(),total_llm_calls: 0,});}
一份只有 8 个扁平章节的文档,全部章节加起来也没多少字——直接全选,零 LLM 调用。这种"便宜路径先走"的思路在 EasyRAG 里反复出现(第 6 篇的查询路由也有类似的快速通道),省的都是真金白银的 token。
逐层导航:每层一次结构化推理
对真正的大文档,引擎在两个 Prompt 之间交替:
- NAVIGATE(顶层):给 LLM 看文档标题、整体描述和顶层章节列表(含各章节摘要),要求输出 JSON:
{thinking, selected_sections, confidence}; - DRILL_DOWN(下钻):进入选中的章节后,把父章节摘要 + 子章节列表再给 LLM,继续选择,且支持选
__self__——“答案就在父章节本身,不用再往下钻了”。
每一步推理都记录在案:
pub struct ReasoningStep {pub level: usize,pub sections_considered: Vec<String>,pub sections_selected: Vec<String>,pub thinking: String, // LLM 的完整推理过程pub confidence: String, // high / medium / low}
这个 reasoning_chain 是 TreeSearch 最被低估的产出:它让检索过程变得可解释、可调试。答案不对时,你能逐层回看"LLM 在第二层为什么放弃了 3.2 节"——是传统向量检索的 score 列表给不了的诊断能力。
两个安全阀:max_depth(默认 3 层)和 max_sections_per_level(默认每层最多选 3 个分支),防止在又深又宽的文档上组合爆炸,把一次查询变成几十次 LLM 调用。
路径 B:StructureAgent——自主探索的"研究员模式"
TreeSearch 的导航路径是固定的(永远自顶向下)。但有些问题需要更灵活的策略:先搜关键词定位,再翻目录确认上下文,最后精读两节——路线只有走到一半才知道。这就是 query/agent.rs 的 StructureAgentStrategy,PageIndex 式的自主文档探索。
给 LLM 发四件工具
let tools = vec![ToolDefinition { name: "list_documents", /* 库里有哪些文档 */ },ToolDefinition { name: "get_document_structure", /* 拿某文档的目录树 */ },ToolDefinition { name: "get_section_content", /* 按章节路径取原文 */ },ToolDefinition { name: "search_sections", /* 按关键词搜章节标题/摘要 */ },];
系统 Prompt 里写清了"研究策略":先看结构 → 推理哪些章节相关 → 取内容验证 → 不够就探索相邻章节 → 综合成答案。并且立了规矩:每次调用工具前先解释推理、优先窄而准的检索、答案里必须引用章节路径、最多 6 次工具调用。
工具循环:一个朴素的 ReAct 循环
while tool_calls_used < self.max_tool_calls {let response = self.llm_service.complete_with_tools(messages.clone(), self.tools.clone()).await?;if !response.has_tool_calls() {// LLM 不再要工具了:攒够证据,直接产出最终答案return Ok(AgentQueryResult { answer, tool_call_trace, ... });}for tool_call in &response.tool_calls {let result = self.execute_tool_call(tool_call, ...).await;messages.push(ChatMessage {role: MessageRole::User,// TOOL_RESULT_PREFIX 契约:前缀不能改!content: format!("[Tool Result: {}]\n{}", tool_call.name, result),});tool_calls_used += 1;}}// 6 次用完还没答?把全部探索记录作为历史,要求立即给出最终答案
这个循环本身平淡无奇,真正的工程含量在三个"看不见的契约"里:
契约 1:工具结果的消息伪装。 注意工具结果是以 User 角色、带 [Tool Result: xxx] 前缀的消息塞进历史的。为什么不用 API 原生的 tool 消息?因为要兼容 Ollama 这类不支持完整 tool-calling 协议的后端——openai.rs / ollama.rs 两个客户端识别这个固定前缀,再各自转换成 API 原生格式。代码里的注释写得明明白白:
TOOL_RESULT_PREFIX contract: ... Do NOT change this format without updating those implementations.
改一个字符串,崩两个客户端。 这种跨模块的隐式契约,要么写进注释,要么写进契约测试(第 15 篇),最好都有。
契约 2:工具失败不炸循环。execute_tool_call 返回的是 String 而不是 Result<String>——工具执行失败时,错误被格式化成 "Error executing xxx: ..." 文本喂回给 LLM:
match result {Ok(text) => text,Err(e) => {tracing::warn!("Tool call {} failed: {e}", tool_call.name);format!("Error executing {}: {e}", tool_call.name)}}
一次存储抖动不应该让整个查询 500。让 LLM 看到"这个工具失败了",它自己会换条路走——这是 Agent 系统比固定流水线更有韧性的地方,前提是你别把异常吞掉。
契约 3:文档清单来自状态存储,而不是向量探测。list_documents 最早是"去向量库里查 ‘document’ 这个词看看能捞出哪些 doc_id"——脆弱且依赖 embedding 质量。后来改成走 docStatusStorage 枚举所有 Processed 状态的文档,还能顺带告诉 LLM 每份文档 has_structure=true/false,让它别在没有目录树的文档上浪费工具调用。旧的向量探测路径保留为降级兜底。
全程留痕
每次工具调用都记录 ToolCallRecord(工具名、参数、结果预览、LLM 当时的推理),最终产出 referenced_sections——答案引用了哪些章节路径,一目了然。这和 TreeSearch 的 reasoning_chain 是同一个信念:Agent 可以自主,但不能不透明。
两条路怎么选
LlmService | ||
工程上的答案不是二选一:有 tool calling 能力就用 Agent 兜底复杂问题,没有就降级 TreeSearch——StructureAgentStrategy 只在 ToolCallingLlmService 可用时才被构造,不可用则静默回退,调用方无感。
踩坑记录
三个坑,都和"把控制权交给 LLM"有关。
坑 1:Agent 在错误的文档里打转。 早期 list_documents 用向量探测,库里文档一多,LLM 拿到的清单本身就是错的,后面 5 次工具调用全部浪费在一份不相干的文档上。修复:文档清单改走 docStatus 状态存储枚举(契约 3),并用 has_structure 标记帮 LLM 提前避开没有目录树的文档。
坑 2:工具结果格式一改,双客户端齐崩。 有次重构想把 [Tool Result: xxx] 前缀"顺手优化"掉,幸亏契约测试拦住——OpenAI 兼容客户端和 Ollama 客户端都靠这个前缀识别工具结果消息。教训:跨实现的隐式契约必须有测试钉死(呼应第 15 篇)。
坑 3:结构树 JSON 撑爆上下文。 一份 200 页手册的完整结构树 JSON 可能上万 token,直接喂给 LLM 又贵又稀释注意力。修复:get_document_structure 截断到 3000 字符、get_section_content 截断到 4000 字符,宁要"够用的导航",不要"完整的负担"。
写在最后
| 好 | 好 | ||
| 好 | |||
| 强(推理链) | 强(工具轨迹) |
GraphRAG 补的是"碎片之间的关系",结构检索补的是"碎片的位置"——一个靠抽实体建图,一个靠白拿作者的目录。如果知识库里是手册、财报、论文、白皮书这类强结构文档,目录树路线的投入产出比极高:入库只要一次 Markdown 解析加几次摘要,查询侧立刻获得"可导航"的能力。
判断要不要上结构检索,也只需要问自己一个问题:你的文档有目录吗? 有,就别浪费。
你的知识库里长文档多吗?有没有遇到过"明明告诉了它章节,它还是答错"的情况?评论区聊聊。