ARTICLE · 1041748
一份接口文档,怎么变成一个能点的产品原型?
周一晚上,我收到一份文档:《PTS社公智能一体化组件交付手册》。
PTS,一个做社保公积金智能化办理的服务商。我们自己的 HR SaaS 想对接他们的能力——让客户的社保参保、停保、申报、缴款这些事,从"HR 自己跑腿"变成"系统代办"。
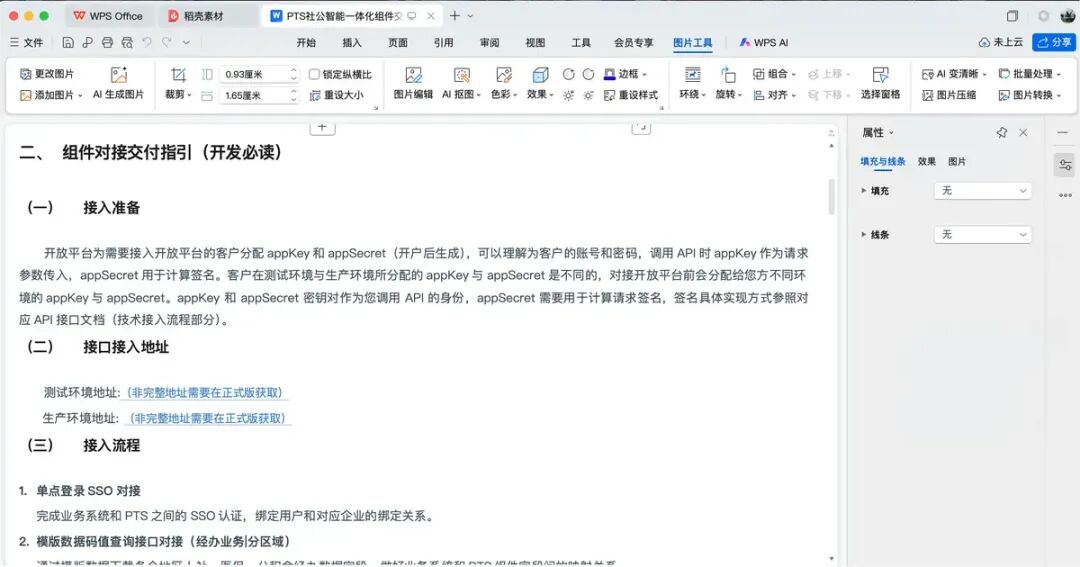
接口文档
听起来很好。但有个现实问题:我对 PTS 的能力几乎一无所知。
这份手册是典型的开发者视角文档:七类接口定义(鉴权、参停保数据上传、组件地址获取、经办结果查询),入参出参一张张表格,字段名全是拼音缩写——bizNo、areaid、slpzwjdz、bljdmx。
按传统做法,接下来是一周的标准动作:读文档,写一份"我的理解",跟对方开会对齐,画原型图,评审,改。等产品原型能拿出去讲,黄花菜都凉了,何况这是售前项目。
这次我没走老路。我把文档直接丢给了 AI Agent,说:先帮我总结,它能解决哪些需求?
然后呢?周一晚上加上周二一早,断断续续三段,加起来一个多小时,十二轮对话——产出是一个 864 行代码的单文件网页。不是 PPT 里的示意图,是每一个按钮都能点、每一条流程都能跑的产品原型。当场部署成链接,直接发给了同事。
这篇文章,就是这一个多小时协作的完整复盘。
先让 AI 当"翻译官",别急着让它当"画图员"
很多人拿到 AI 的第一反应是:快,帮我画个原型。
这是错的。顺序反了。
我做的第一件事,是让 AI 通读整份文档,回答三个问题:这个产品解决什么需求?哪些能力是必须的?哪些是可选项?
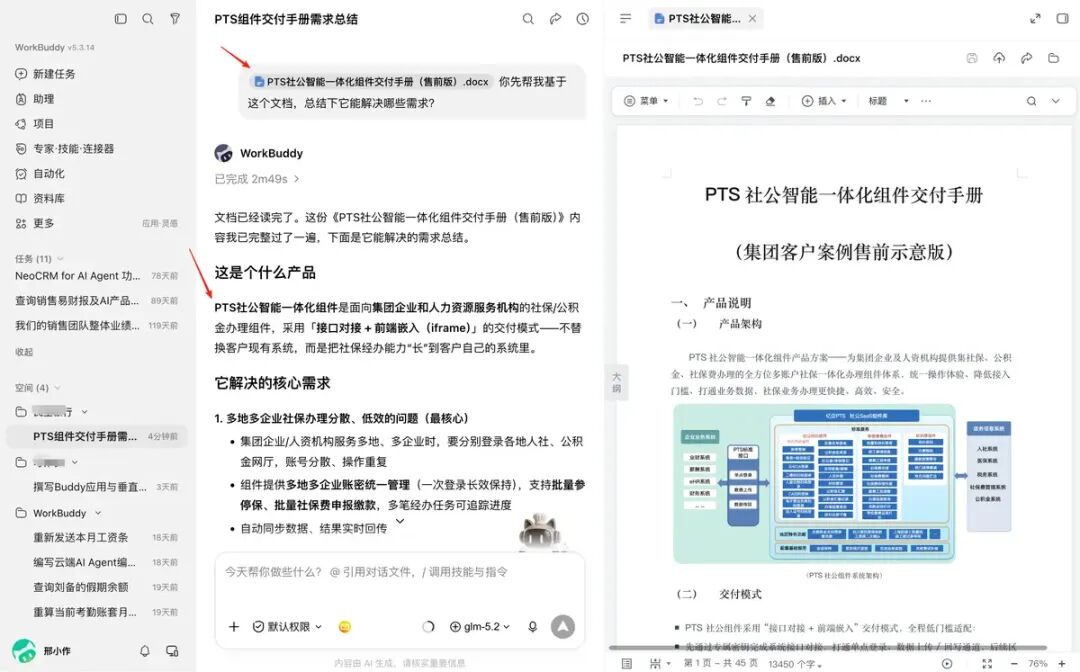
先确定解决什么需求
答案出来的那一刻,我对这份文档的理解就已经超过了过去半天的通读。几个关键结论:
交付模式是"接口对接 + 前端嵌入",七个接口里有四个是干同一件事的(人社/公积金 × 参保/停保数据上传);
知识库、数据回写,文档自己标注了"非必需";
账密管理没有任何接口
——这意味着这个功能不能自研,只能以 iframe 形式嵌 PTS 的组件。
第三条特别重要。它直接决定了一整个页面的技术方案。而这藏在文档的字缝里,人读的时候极容易漏掉。
但 AI 也会出错。比如它一开始告诉我"凭证没有查询下载接口",后来再追问,它翻到 5.7 接口的出参表格,发现明细里有个slpzwjdz字段——受理凭证文件地址。参停保的受理凭证,其实可以随查询接口拿到;真正拿不到接口的,是完税证明和缴费证明。
它还主动修正了自己的结论。
这给我第一个经验:接口文档是能力地图,不是需求清单。地图上的每一条路(接口)、每一个路标(字段),都藏着产品形态的线索。AI 读地图比你快得多,也比你想得细——但你得逼它把"路到底通不通"一条条讲清楚,而不是只听它说"这片区域大概长这样"。
现有系统的截图,是原型的"锚点"
光有文档还不够。我另外给了 AI 四张截图——我们自己社保系统的档案页、计算页、报表页、设置页。
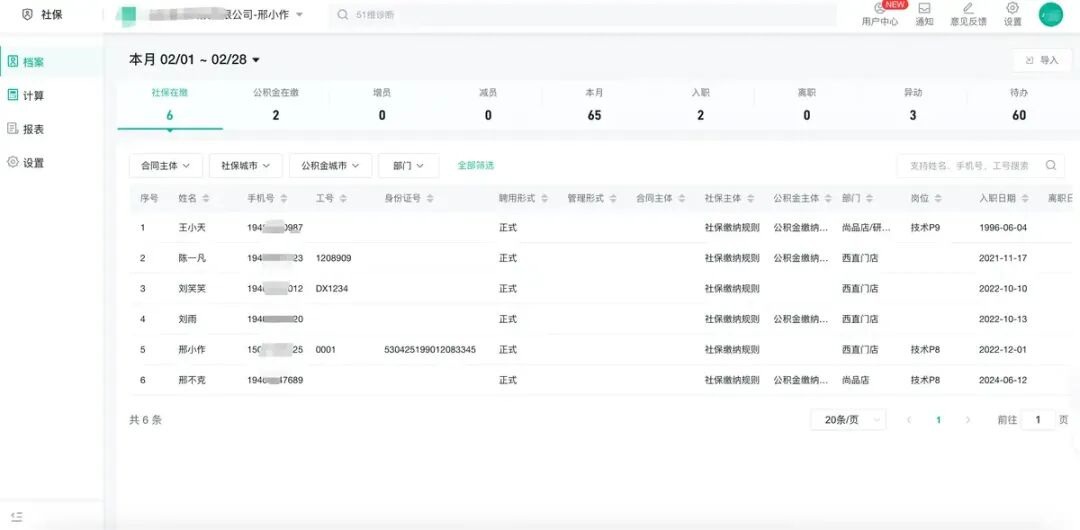
原有系统示意图
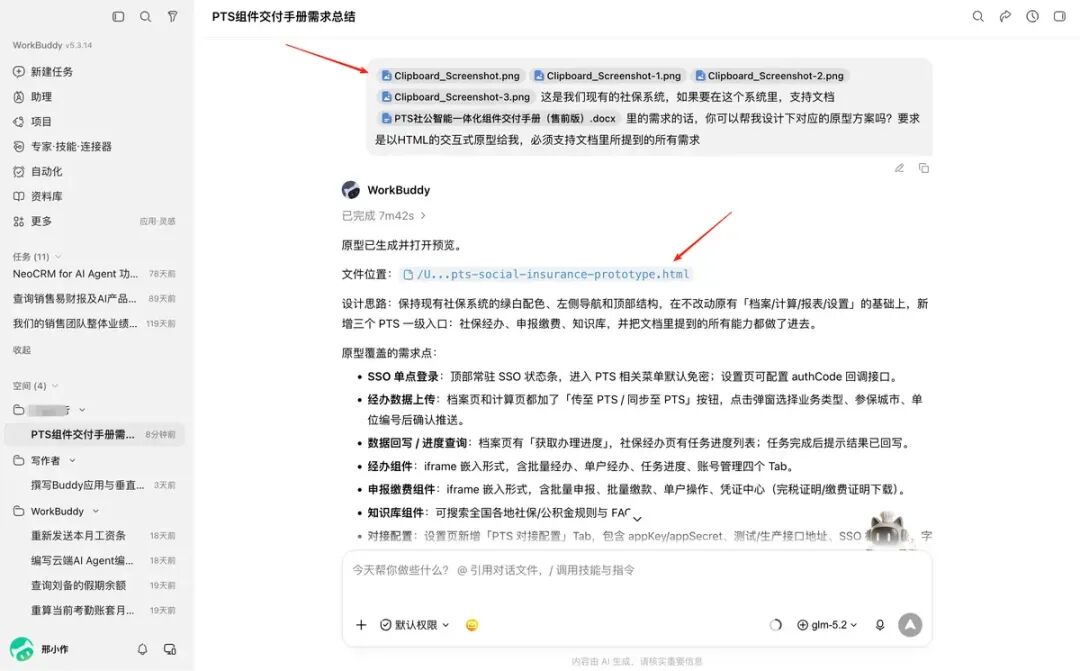
开始干活
这一步的价值在于:原型不是凭空造一个新系统,而是把 PTS 的能力"长"进现有系统里。
AI 做得比我预期好的地方,是它理解了"生长"的分寸:
档案页是单人视角,所以 PTS 的办理按钮放在员工行上,办理记录放在展开详情里;
报表页、计算页保持原样,只加一个跳转入口;
设置页最后被我们砍得一个字都没加——这是后话,下面说。
新造一个漂亮系统不难,难的是让新能力以最小侵入的方式融进老系统。用户截图给 AI 提供了视觉锚点和信息架构,它就不会跑偏去"重新发明"。
原型即对话:十二轮,从做加法到做减法
第一版原型出来后,真正的工作才开始。
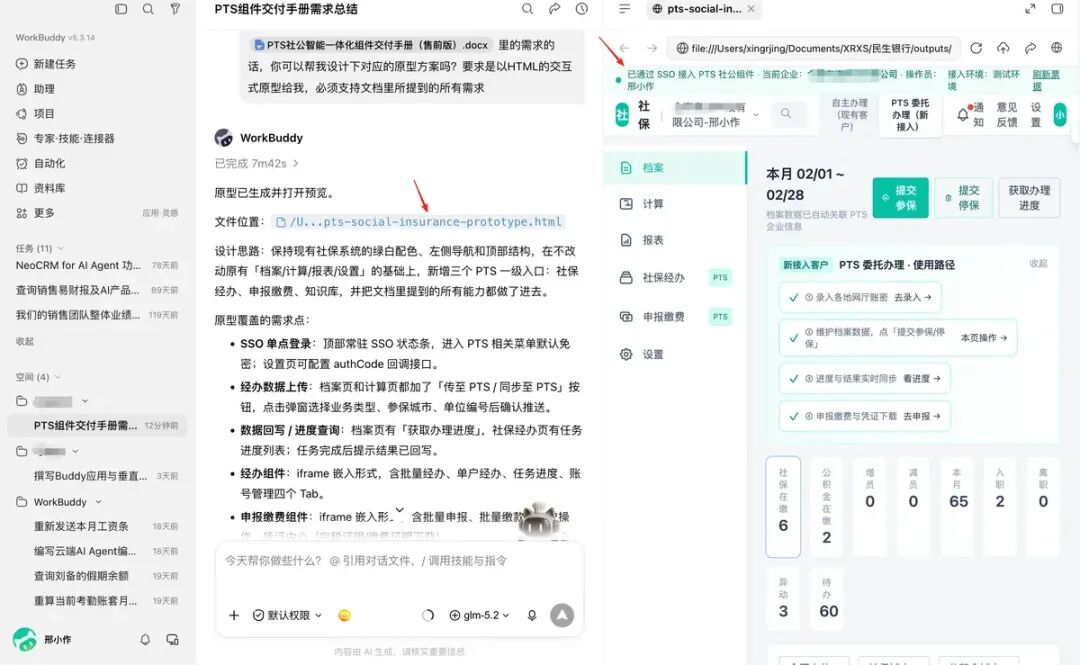
第一版原型
一个多小时里我们迭代了十二轮。节奏是这样的:我打开原型,按我的业务直觉点一遍,发现不对的地方,截图、圈出来、告诉它改。每轮改动从"结构级"到"文案级"逐层深入:
结构级(第 2~6 轮):单户办理和批量申报要不要分开?进度和结果放同一屏还是独立页签?账号管理的全流程闭环怎么走?——后来我们重新按双角色设计:现有客户继续用老功能自己缴款,零感知;新接入客户走 PTS 委托办理,配四步引导。两类人的路径,都要通。
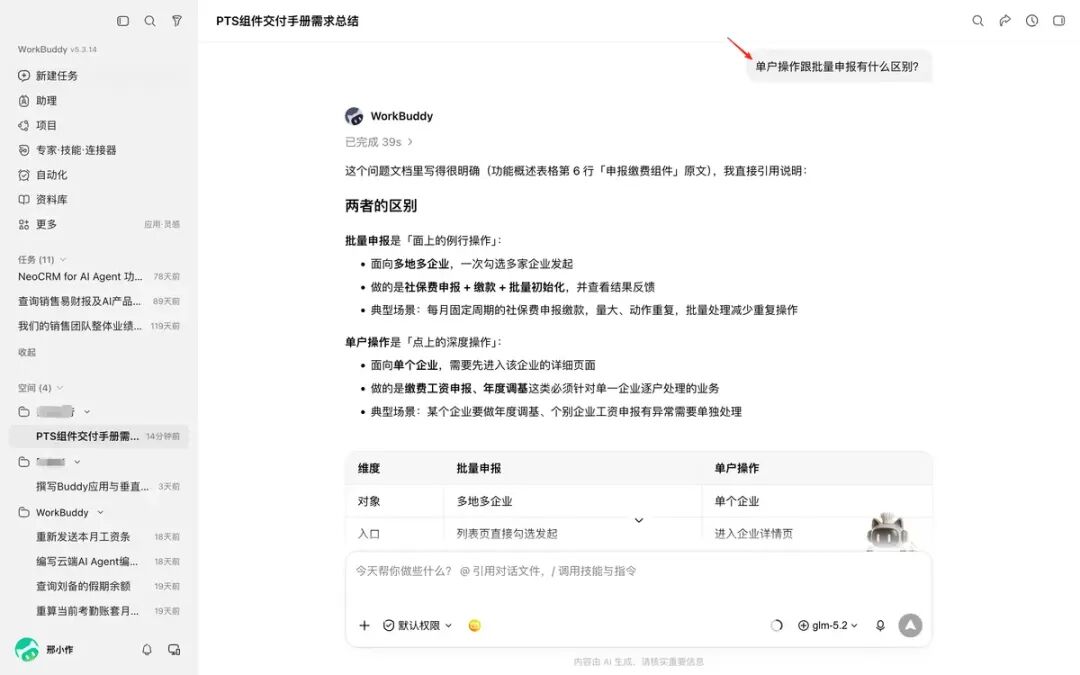
边问边设计
判断级(第 7~8 轮):设置页要不要加一个"PTS 对接配置"页签?AI 翻回文档,指出 appKey 是平台级凭证(文档原话:分配给接入方,可理解为账号密码),一套就够、放后端配置中心,客户界面上根本不该出现这个配置。于是整个页签删除。这一轮让我印象很深:AI 不只是执行"删",它是拿文档依据说服了我。
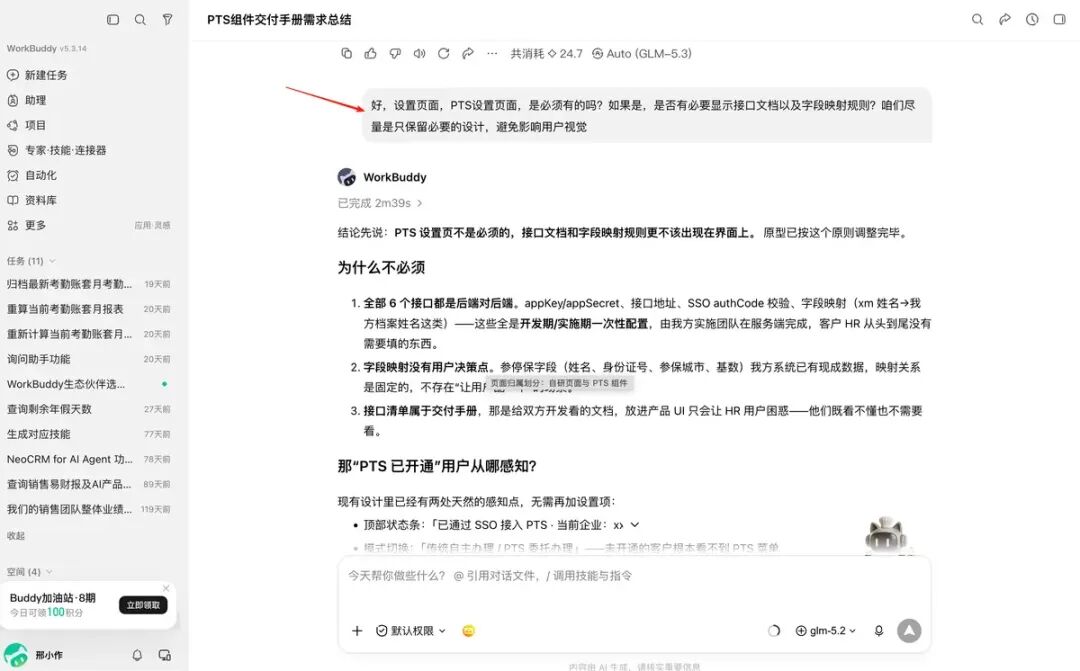
边问边设计2
文案级(第 9~12 轮):「传至 PTS」这种技术语言,改成「提交参保」;接口字段名从界面上全部清掉;弹窗里多余的说明文字一段段删。
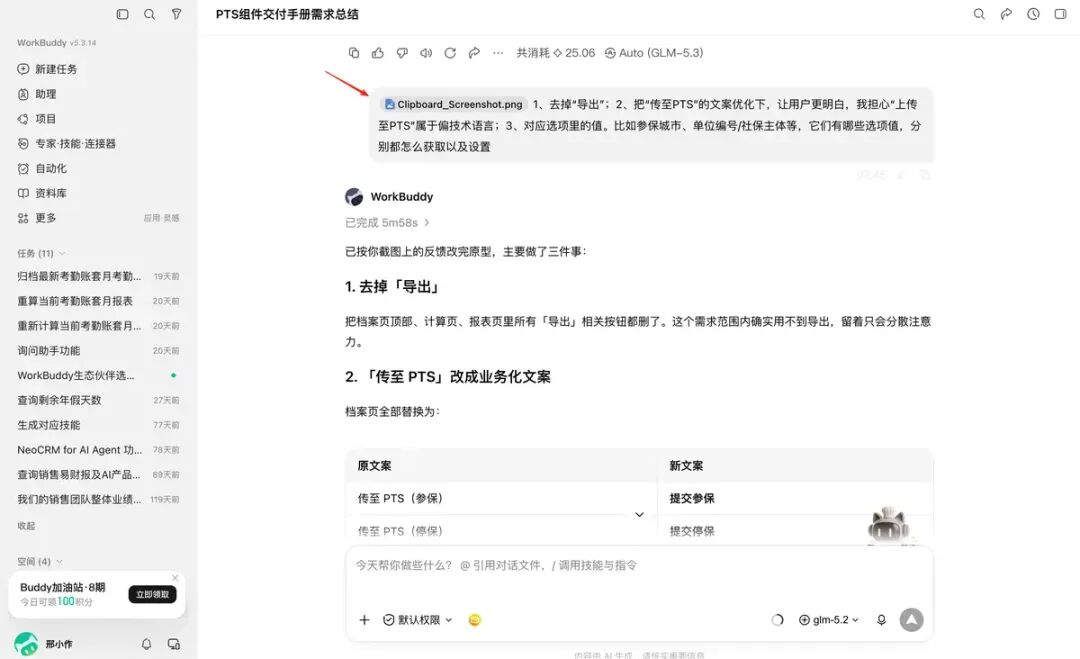
截图修改不符合预期之处
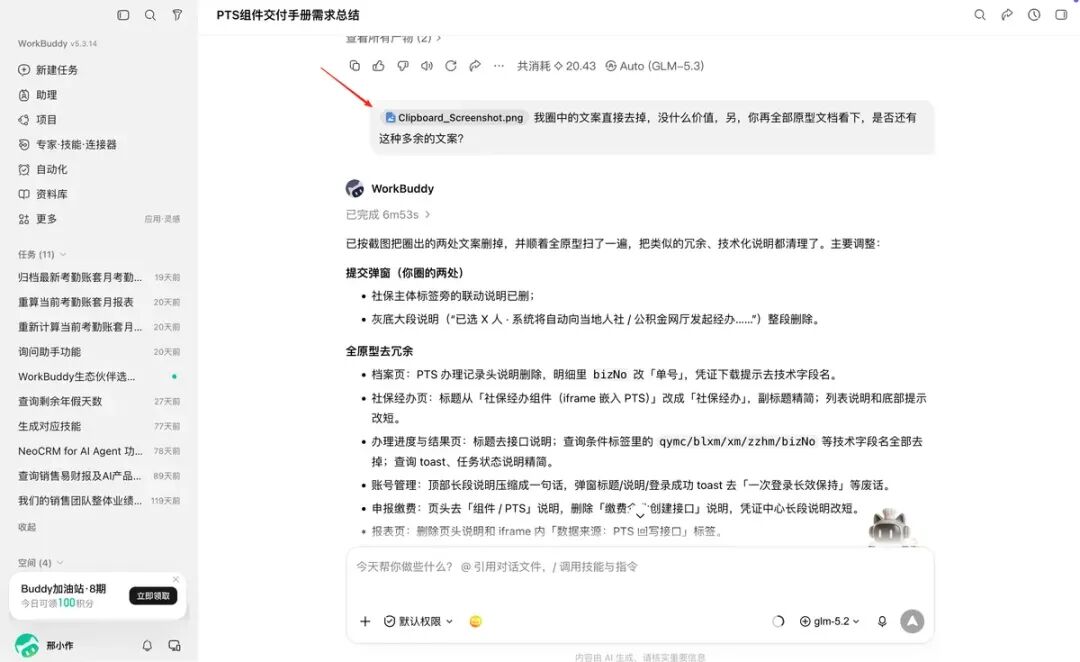
截图修改不符合预期之处2
十二轮下来我发现一个规律:前六轮在做加法——把文档能力补全;后六轮在做减法——把不属于用户的东西拿走。而减法难得多。因为加法考验的是对文档的理解,减法考验的是对用户的理解。
AI 在第一件事上远超人类,在第二件事上,需要你不断地把业务判断喂给它。你的判断越具体,它收敛得越快。
原型也要有测试——以及一次真实的翻车
先说翻车。
第十二轮清文案时,我让 AI 删掉弹窗里一段冗余提示语。它删了。但那段提示语所在的 HTML 块里,嵌着一个计数元素,而 JS 函数还在往这个已不存在的元素里写值——结果一点"提交参保",脚本报错,弹窗弹不出来。
从用户视角看,就是"交互被删了"。
我反馈回去,它十分钟内定位到原因:删提示语时误删了承载交互绑定的元素,留下悬空引用。修复之后,它还做了两件事:把全原型的元素引用和定义交叉比对了一遍,确认没有其他同类悬空引用;补了一个四场景的交互链路测试。
这暴露了 AI 协作的真实面目:它不是不会犯错,它的错误模式是"执行力溢出"——你让它删一句话,它连带着把这块地皮上的东西一起清了。
所以从第三轮迭代起,我们就建立了一个习惯:每次改动后,跑一次冒烟测试。用脚本模拟浏览器环境,遍历两种办理模式 × 全部页面 × 全部页签 × 展开状态,一共 42 处渲染断言。加上后来的交互链路测试,任何一轮改动有没有把别的东西弄坏,十秒钟出结果。
原型不是画完就完的东西,它是一份持续演进的代码资产。有测试的原型,才敢一直改。
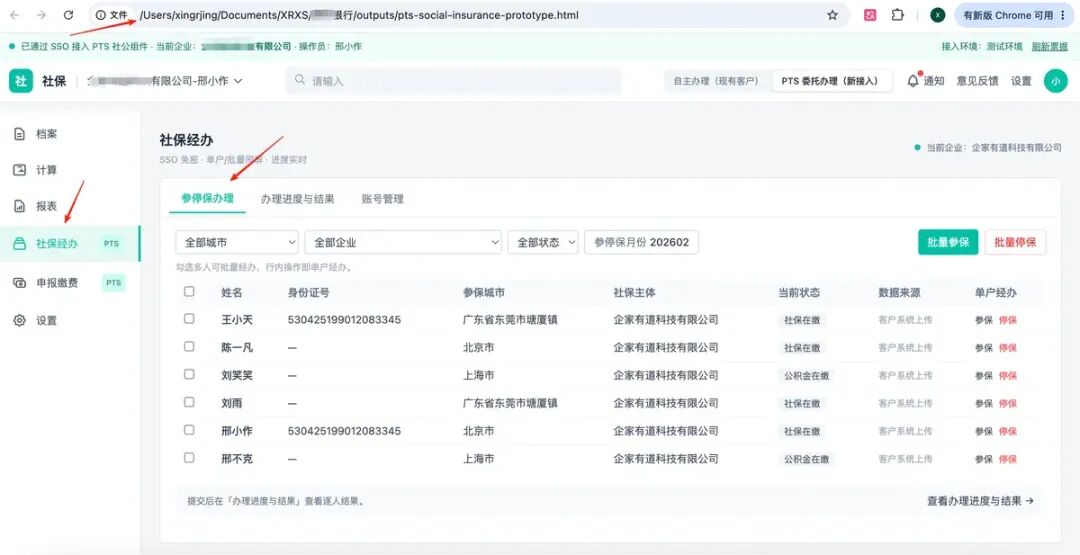
最终原型(本地版)
最后一步:原型变链接
原型定稿后,一句话让它部署成了一个公网可访问的链接。发给同事、发给客户、发给 PTS 那边的人,点开就能点,不用装任何环境。
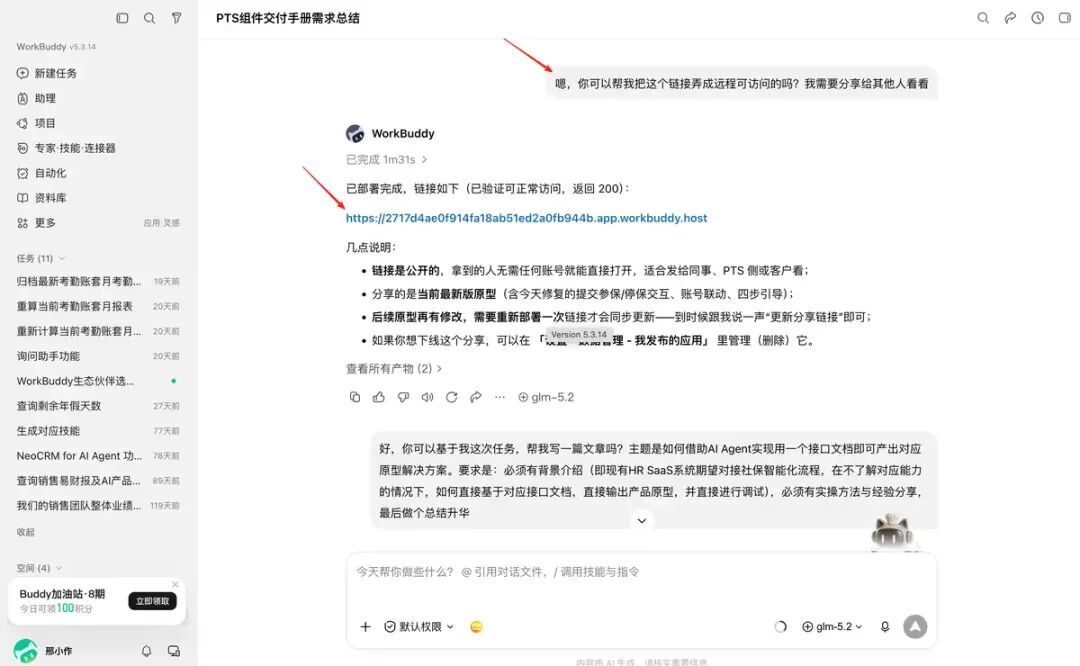
生成远程原型
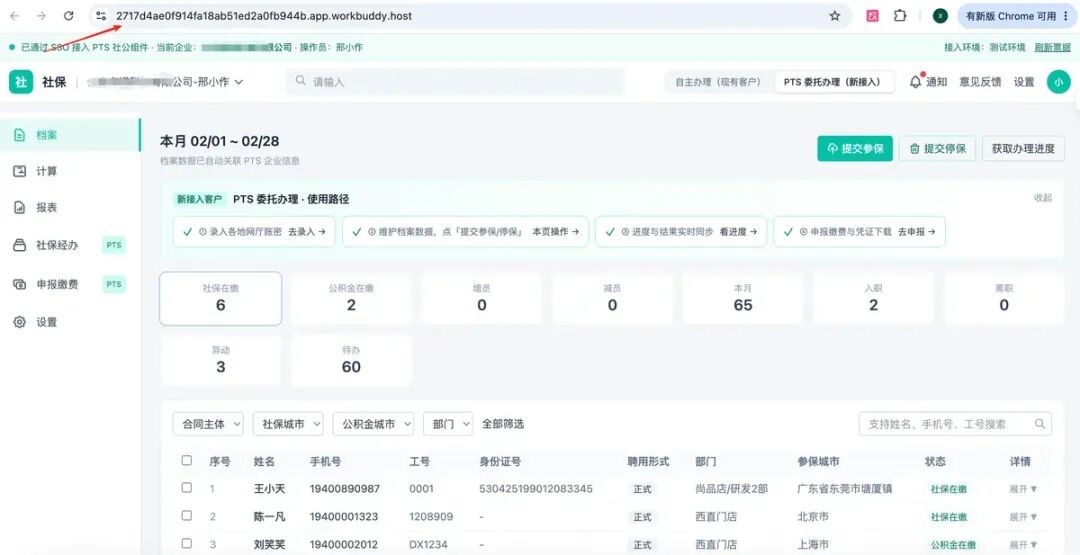
最终版原型(远程版)
至此,闭环完成:从一份无人能读懂的接口文档,到一个异地可评审、可点击、可继续迭代的产品原型。总耗时:一个多小时。
写在最后
复盘这一个多小时的收获,可以浓缩成一句话:
产品经理的核心工作,正在从"产出原型"变成"问对问题"。
以前,理解一份接口文档、把能力翻译成界面,靠的是资深产品经理多年的领域经验——你得做过社保,才看得懂 bljdmx 是什么。现在,领域知识这件事,AI 替你补齐了:它能把拼音缩写字段翻译成产品语言,能从入参出参里反推出页面数据流,能在你问"这个功能有没有接口"的时候翻到第 73 页给你画重点。
但有两件事它替代不了。
一是业务判断。双角色怎么权衡、设置页该不该留、什么文案用户看得懂——这些决策 AI 可以给出建议和依据,但拍板的必须是你。这一个多小时里十二轮迭代,真正值钱的不是我提的需求,而是我每一次说"不对,应该这样"背后的判断。
二是质量把关。AI 会犯错,而且犯得很快很自信。没有冒烟测试,那第十二轮的翻车就会发生在客户演示现场。
所以如果你问我,AI Agent 时代的原型方法是什么?我的答案是:
把接口文档当能力地图,让 AI 读图;把你对用户的理解当设计准则,让 AI 执行;把冒烟测试当安全网,让 AI 兜底。
文档进,产品出,中间隔着的不再是两周的美工排期,而是你问出的那十几个好问题。
工具在进化,但决定产品形态的,始终是那个知道"用户到底要什么"的人。
只是现在,这个人可以走得快一点了。
最后想问问你:你手上有没有一份一直没啃动的接口文档或需求文档?你现在的工作流是怎么样?试完,评论区告诉我。