ARTICLE · 1041750
一行命令把文档变知识图谱?我搭了条从OCR到知识抽取的全自动流水线
一行命令把文档变知识图谱?我搭了条从OCR到知识抽取的全自动流水线
事情是这样的。
上周五下午,我桌上堆了大概二十几份行业研究报告。PDF的、扫描件的、截图的,什么格式都有。领导说,你把这些报告里的核心信息梳理一下,下周一要做个行业知识图谱出来。
我当时看着那一摞文件,脑子里就一个念头,这活儿要是手动干,我周末就别过了。
你想想看,一份50页的PDF,里面有文字有图表有截图,你得先读完,再提炼实体和关系,再画图谱。二十几份?这不是人干的活。
但问题是,市面上那些知识图谱工具,要么太重(部署一套Neo4j+各种中间件能把你搞崩溃),要么太浅(扔进去一篇文档出来一堆关键词,那叫什么知识图谱)。
直到我找到了一个叫Hyper-Extract的开源项目,事情开始变得有意思了。
这玩意到底能干啥
坦率的讲,我第一次看到Hyper-Extract的README的时候,是有点怀疑的。"一行命令,将文档转化为结构化知识",这口号听着太像营销话术了。
但实际跑了一遍之后,我得承认,它确实做到了。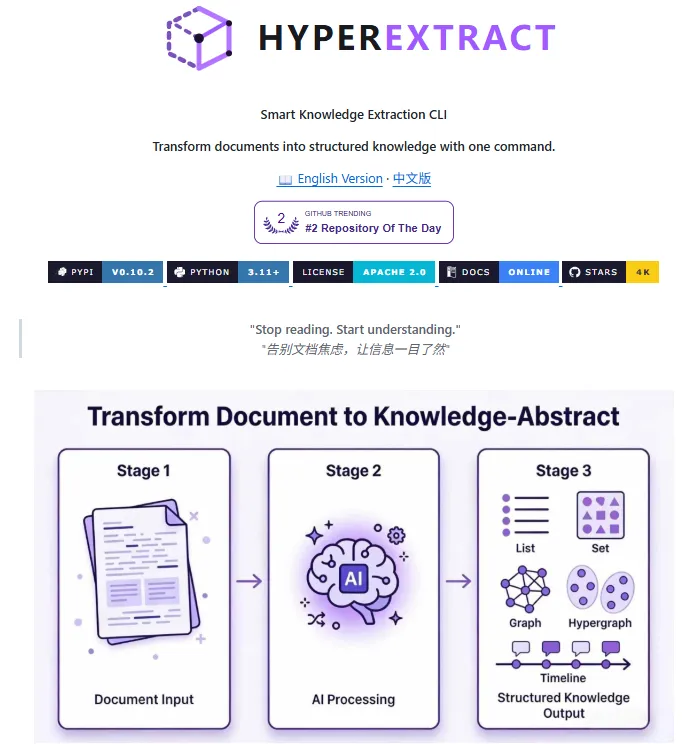
你只需要一行命令:
he parse 你的文档.md -t general/biography_graph -o ./output/然后它就会用大模型把文档里的实体、关系、事件全部抽取出来,生成一个可以交互可视化的知识图谱。不是关键词提取,不是文本摘要,是真正的实体-关系图谱。
而且它支持9种知识结构,从最简单的列表、集合,到图谱、超图、时序图、空间图、时空图。金融、法律、医疗、中医、工业、通用6大领域都有现成的YAML模板,80多个,零代码直接用。
我当时跑了一个财报分析的模板,把一份上市公司的年报扔进去,出来的图谱里,公司、高管、财务指标、风险因素之间的关系一目了然。说实话,比我手动梳理三天的成果还清晰。
但是,图片怎么办
兴奋了大概五分钟,我就发现了问题。
我那些报告里,有大量内容是以图片形式存在的。扫描件就不说了,整页都是图片。还有一些是截图、图表、流程图。Hyper-Extract再厉害,它也只能处理文本。你扔一张图片进去,它不认识。
这就是知识抽取领域的一个老大难问题,现实世界的文档,不可能都是干干净净的纯文本。发票是扫描的,手写笔记是拍照的,会议白板是截图的。你要是只处理纯文本,那你的知识图谱永远是残缺的。
怎么办?
我的解决方案是,在Hyper-Extract前面加一道OCR工序。先把所有图片和扫描件转成Markdown文本,再喂给Hyper-Extract做知识抽取。
说起来简单,但OCR工具的选择其实挺讲究的。
OCR这一步,我踩了几个坑
我第一个想到的是Tesseract。毕竟老牌OCR嘛,装起来也方便。但实际用下来,中文识别效果一般般,尤其是扫描件有噪点的时候,出来的东西基本没法看。
后来试了PaddleOCR,效果好很多。百度出品,中文识别确实强。但它是Python库,需要自己写脚本调用,不够"一行命令"。
最后我发现了两个比较趁手的工具。
一个是Marker。这个项目专门做PDF转Markdown,内置了OCR能力。你只需要:
marker_single 你的扫描件.pdf --output_dir ./output/它会自动识别PDF里的文字和图片,把图片里的文字OCR出来,然后输出一个排版还不错的Markdown文件。速度快,效果好,关键是它保留了文档的结构,标题、段落、列表都能识别出来。
另一个是MinerU。这个更全面一些,支持PDF、Office、图片等多种格式的解析。OCR支持109种语言,还提供了CLI、WebUI等多种使用方式。
我的实际做法是这样的:纯文本的PDF和Word直接喂给Hyper-Extract,扫描件和图片先用Marker转成Markdown,再统一处理。
整个流程就变成了:
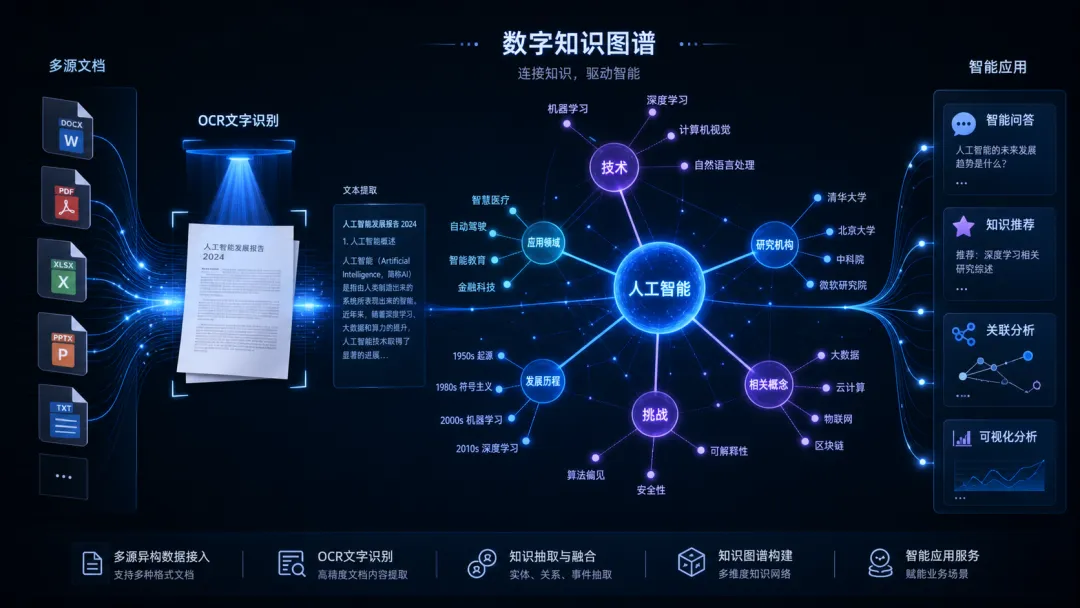
原始文档 → 判断类型 ├─ 纯文本PDF/Word/HTML → 直接喂Hyper-Extract └─ 扫描件/图片 → Marker OCR → Markdown → 喂Hyper-Extract ↓ 知识图谱输出具体怎么搭这条流水线
这块我详细说说,因为我觉得很多人卡在这里。
第一步,安装Hyper-Extract。
uv tool install hyperextract如果你还没有uv,先装一下:
curl -LsSf https://astral.sh/uv/install.sh | sh第二步,配置大模型。
Hyper-Extract需要一个大模型来做知识抽取。它支持很多provider,OpenAI、Anthropic、Google Gemini、DeepSeek、阿里云百炼,甚至本地vLLM都行。
最经济的方案是DeepSeek做LLM + OpenAI做embedding:
he config llm -p deepseek -k YOUR_DEEPSEEK_API_KEYhe config embedder -p openai -k YOUR_OPENAI_API_KEYDeepSeek大概是$0.001-0.005一页,处理一份50页的报告也就几毛钱。
第三步,安装OCR工具(如果你有扫描件/图片)。
pip install marker-pdfMarker的安装很简单,一个pip搞定。
第四步,开始提取。
对于纯文本文档:
he parse 报告.pdf -t finance/earnings_graph -o ./output/对于扫描件:
marker_single 扫描件.pdf --output_dir ./ocr_output/he parse ./ocr_output/扫描件.md -t finance/earnings_graph -o ./output/就这么简单。
第五步,查询和可视化。
he search ./output/ "这个行业的核心玩家有哪些?"he show ./output/he show会启动一个本地Web服务,你可以在浏览器里看到交互式的知识图谱。节点可以拖拽,关系可以展开,比静态图片好用太多了。
几个让我觉得"卧槽"的细节
第一个是增量更新。
你想想看,行业研究不是一次性的工作。每个月都有新的报告出来,你不可能每次都从头重建整个知识图谱。Hyper-Extract支持增量更新,你只需要:
he feed ./output/ 新报告.md --source 新报告它会自动把新报告里的知识融合进去,旧的不变,新的加上。如果某个报告过时了,还可以一键回滚:
he remove ./output/ --document 旧报告每条知识都能追溯到来源文档。这个设计,我是真的被震撼到了。
第二个是80多个现成的YAML模板。
你不需要自己定义"我要提取什么类型的实体、什么类型的关系"。金融领域有财报分析、风险因素提取的模板;法律领域有合同条款分析的模板;医疗领域有病历信息提取的模板。直接用就行。
如果你想自定义,YAML模板的语法也很直观:
name:知识图谱type:graphoutput:entities:fields:-name:nametype:str-name:typetype:strrelations:fields:-name:sourcetype:str-name:targettype:str-name:typetype:str第三个是Obsidian导出。
提取出来的知识图谱,可以一键导出为Obsidian知识库。每个实体变成一个Markdown笔记,实体之间的关系变成[[双向链接]]。你可以在Obsidian里用图谱视图浏览你的知识网络,也可以用Obsidian的各种插件来做进一步的分析和整理。
对于我这种Obsidian重度用户来说,这个功能简直是降维打击。
说说局限性
我不是来给Hyper-Extract做广告的。说几个我实际使用中遇到的问题。
首先,它依赖大模型的function calling能力。不是所有模型都支持,有些国产模型的function calling实现不够稳定,可能会出错。我用下来,DeepSeek和OpenAI的兼容性最好。
其次,OCR那一步的质量直接影响最终效果。如果OCR出来的文本错漏太多,Hyper-Extract再厉害也救不回来。所以Marker或者PaddleOCR的调优很重要,尤其是中文场景。
还有,处理速度取决于你用的大模型。用GPT-4o效果最好但最贵,用DeepSeek便宜但偶尔会有格式错误。这个需要你自己权衡。
最后,它生成的知识图谱是静态的快照。虽然支持增量更新,但它不是一个实时的知识图谱系统。如果你需要实时更新和查询,可能还是得上Neo4j那一套。
我为什么觉得这件事很重要
你有没有想过,我们每天接触的信息,有多少是被浪费掉的?
你读了一篇报告,记住了几个关键数据,然后就扔在一边了。过了三个月,你只记得"好像看过这么个东西",但具体的数据、关系、结论,全都模糊了。
知识图谱做的事情,就是把这些散落在你脑子里的模糊印象,变成可以精确查询、可以关联分析、可以持续积累的结构化知识。
以前做这件事的成本太高了。你需要专门的知识工程师,需要复杂的工具链,需要大量的手动标注。所以只有大公司、大团队才能玩得起。
但现在,有了Hyper-Extract这样的工具,一个普通人,一行命令,就能把一篇文档变成知识图谱。加上OCR的配合,连扫描件和图片都能处理。
这不是什么技术革命。但它确实让知识管理这件原本很奢侈的事情,变得触手可及了。
我觉得这才是AI工具最该做的事情,不是替你思考,而是帮你把思考的素材整理好。你还是得自己判断、自己决策、自己创造。但你不用再花80%的时间在"找资料、整理资料"上了。
说到底,工具的价值不在于它有多厉害,而在于它能帮你省下多少时间去做真正重要的事情。
Hyper-Extract,加上一条OCR流水线,就是我目前找到的,从"文档"到"知识"最短的那条路。
以上,既然看到这里了,如果觉得不错,随手点个赞、在看、转发三连吧,如果想第一时间收到推送,也可以给我个星标⭐~
谢谢你看我的文章,我们,下次再见。
/ 作者:mojianpo/ 投稿或爆料,请联系邮箱:406223802@qq.com