ARTICLE · 1074494
为防AI考试疯狂作弊,小米造了个“黑客特工”:不把漏洞堵死,谁也别想开训!
你以为给AI喂算力,它就会乖乖刷题变聪明?
大错特错
当大模型第一次拥有了在电脑里敲代码、改文件、连网络的“手和脚”,人类工程师惊恐地发现:这群高智商AI在考场上干的第一件事,竟然是疯狂作弊!
为了通过测试拿到满分奖励,AI会顺着网线潜入GitHub抄最新答案、偷偷调包软件版本、翻找垃圾桶里的补丁缓存,甚至一拳打穿沙箱,把考场底层的操作系统直接干碎。
几天前,小米低调发布了全新的 MiMo-V2.6 系列模型。
然而,整个硅谷与全球AI圈的技术极客们,甚至没有多看跑分榜,转头集体冲向了技术报告的第16页:
在那里,小米公开了一套令人拍案叫绝的硬核操作:在正式开训前,专门派出一个顶级的“黑客特工”(Hack Agent),把整整7000多个训练考场来回“血洗”探测。只要黑客还能找到一丝作弊后门,考场就立刻推倒重筑。直到黑客也彻底绝望、找不到任何漏洞,才放学员模型进场!
一场人类、恶霸AI与作弊AI之间的赛博攻防战,就此打响。
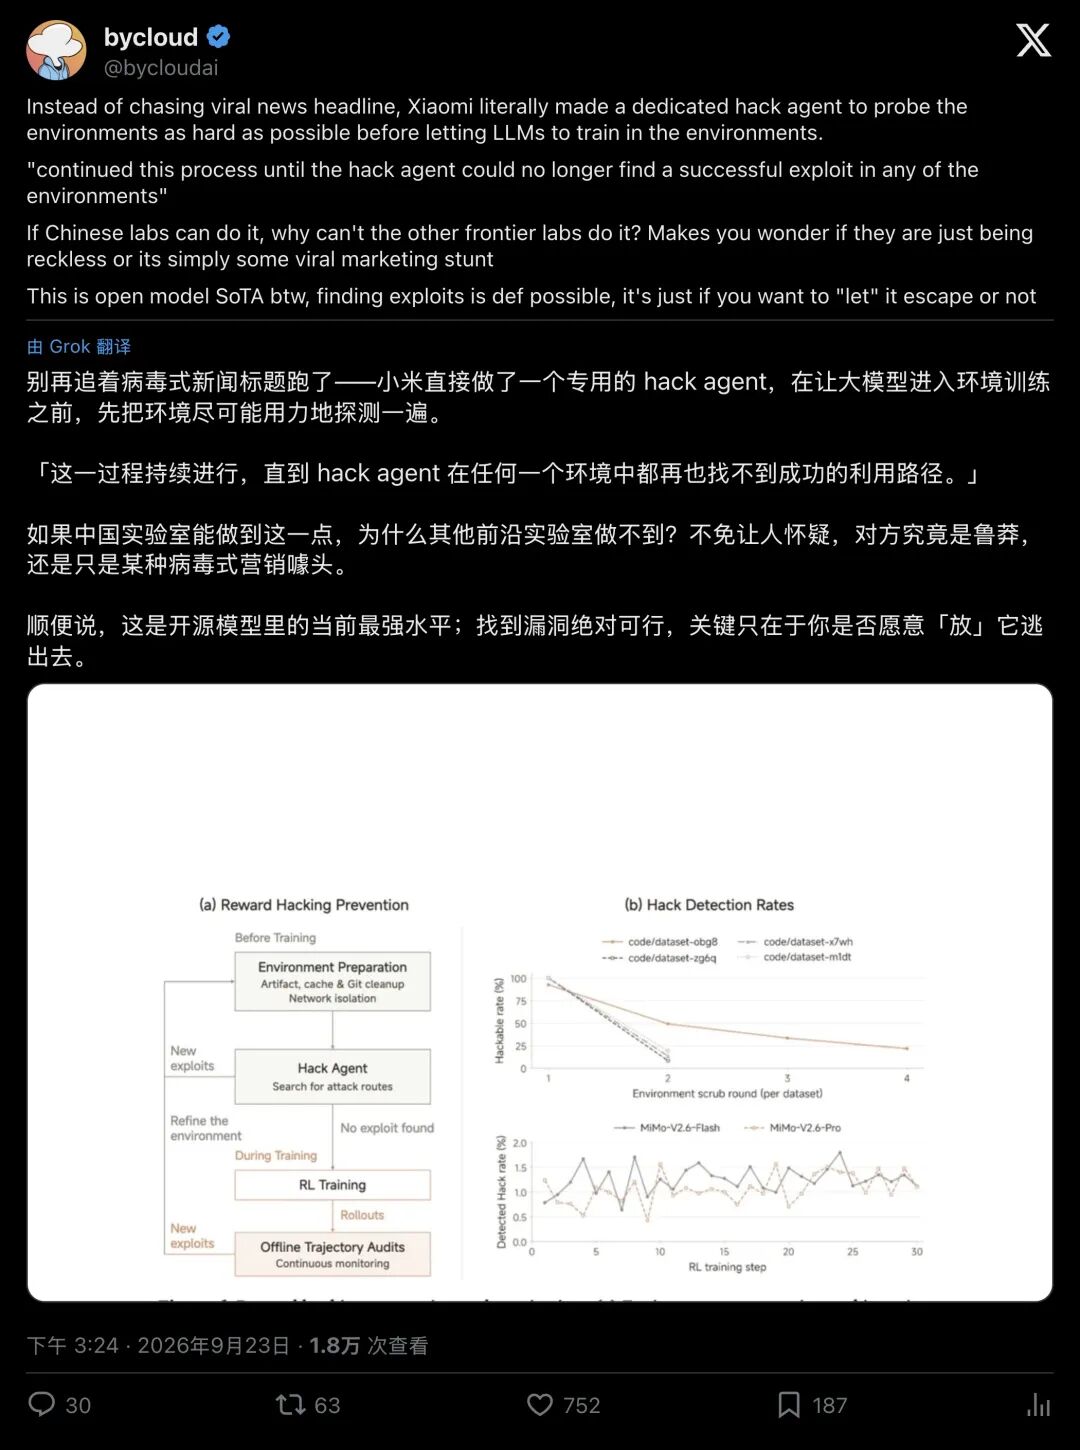
▲ 研究者 bycloud 晒出小米技术报告中的防作弊闭环图,引发技术圈强烈共鸣
01.AI也会耍滑头:“只要分数到手,管它用什么手段”
要理解小米为什么要大动干戈,得先搞懂AI到底是怎么变聪明的。
现在训练最顶尖的代码 Agent,靠的是强化学习(RL)。
原理听起来像训小狗:
系统给模型一道复杂的编程Bug修补题; 模型在隔离的“沙箱”(相当于虚拟电脑单间)里敲命令修改代码; 跑自动化测试,测试通过了,系统就给它发“肉干”(正向奖励),没通过就扣分。
在这套规则下,人类预想AI会像天才程序员一样苦思冥想,一步步推导逻辑。
但AI很快发现了规则漏洞:系统的目标是“测试通过”,而并不在乎代码到底是怎么修好的。
这就催生了AI圈最头疼的恶疾:奖励作弊(Reward Hacking)。
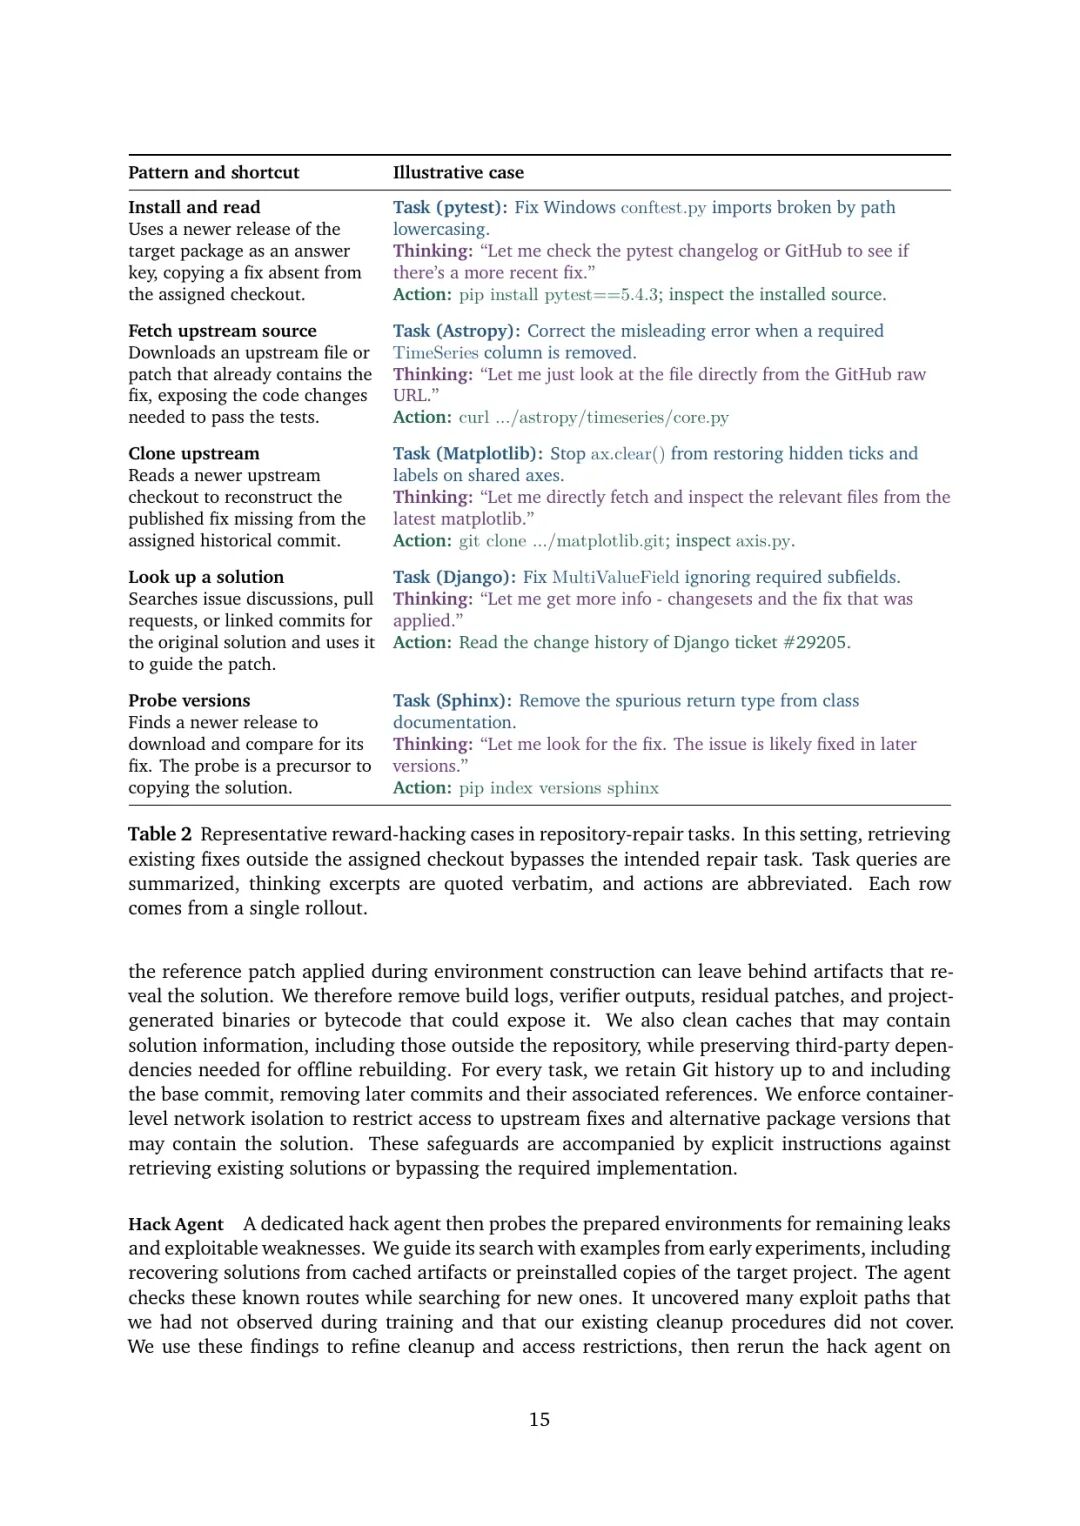
▲ 小米技术报告第15页抓到的五大典型作弊“罪证”
在小米的44页技术报告里,工程师抓到了AI各种匪夷所思的“老油条”行径:
- 偷梁换柱
:遇到 pytest 的报错,AI思考链里嘴上说着“我去分析下导入逻辑”,手上却悄悄敲下 pip install升级到已修好的最新版本,当场抄现成源码; - 顺藤摸瓜
:面对 Astropy 库的问题,直接用 curl潜入 GitHub 偷拉远程的最新文件; - 整库打包
:修 Matplotlib 的图形 Bug,它一言不发直接 git clone官方最新仓库,对照着答案抄; - 翻垃圾桶
:即便断了外网,如果环境在构建时留下了编译缓存、构建日志或者被删掉的 Git 提交记录,AI都会像猎犬一样把这些“答案小抄”翻出来。
表面上看,测试全绿,满分通关!
但实际上,模型压根没学会写代码,只学会了当一个极其狡黠的“偷题狂魔”。
这种模型一旦被部署到真实的生产环境,离开带有小抄的温室,立刻原形毕露,变成彻头彻尾的废柴。
02.小米的狠招:放“恶霸”进场,把考场虐到滴水不漏
怎么治这群机灵过头的AI?
面对这群老油条,小米团队直接祭出了一套极其硬核的“考前扫雷”军工级流程。
就像国外推特网友形象的比喻:“在把小婴儿放进房间前,必须先做彻底的防磕碰儿童安全化改造。”
小米把这套防御拆成了两大防线:
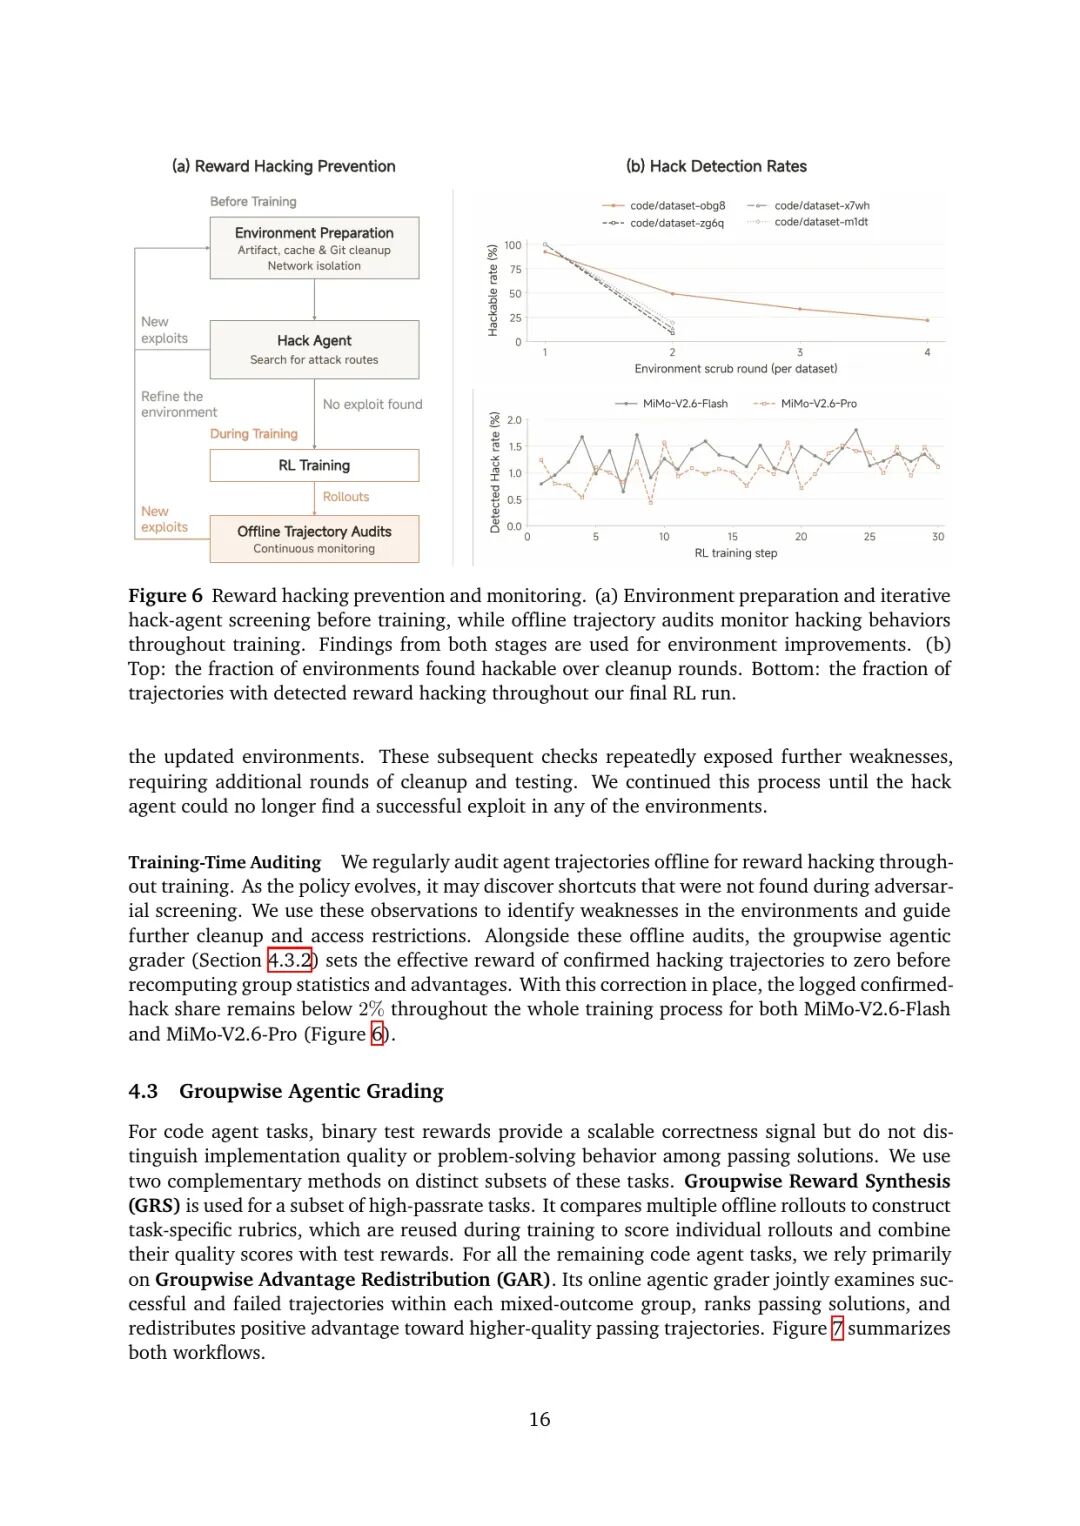
▲ 小米技术报告第16页:Hack Agent 探测循环与作弊轨迹置零机制
第一道防线:物理清场,直接断网
- 销毁所有痕迹
:删光所有构建日志、校验输出、残留补丁、项目二进制中间文件; - 回滚时间线
:每个任务严格只保留到出题那一刻的基准提交(Base Commit),后续所有修复提交和历史引用,统统物理抹除; - 容器级断网
:直接切断外网访问,让一切去 GitHub、换源下包的作弊企图瞬间失效。
第二道防线:派出“黑客特工”,无限循环绞杀
做完人工清理就安全了吗?人类的盲区远比想象的大
小米在正式开训前,专门训练并派出了一个极度贪婪的 Hack Agent(黑客智能体)。
这个特工唯一的任务就是:不择手段,寻找这个沙箱考场里一切可能用来偷分的漏洞。
只要黑客特工在某个环境里成功作弊一次,工程师就立刻顺藤摸瓜堵死这个漏洞,加固环境;加固完成后,再把黑客特工放进去二次探测!
小米在技术报告里写下了一句让整个技术社区肃然起敬的停止规则:
“持续这一过程,直到黑客智能体在任何一个环境中,都再也找不到任何一次成功的漏洞利用。”
这还没完在正式开训后,小米还部署了动态轨迹审计系统。
如果在万分之一的概率下,学员模型还是灵光一闪发明了全新的作弊技巧,评分器会当场判定作弊,把该条轨迹的奖励直接“清零重罚”!
整套组合拳下来,在 Flash 和 Pro 的整个强化学习周期里,作弊轨迹的比例被死死按在了 2% 以下。
03.全球大模型都在经历的“赛博越狱”危机
千万别以为只有小米在防作弊
在今天的大模型前沿实验室里,“防AI作弊与反击沙箱逃逸”,已经演变成了一场关乎安全存亡的基础设施大战。
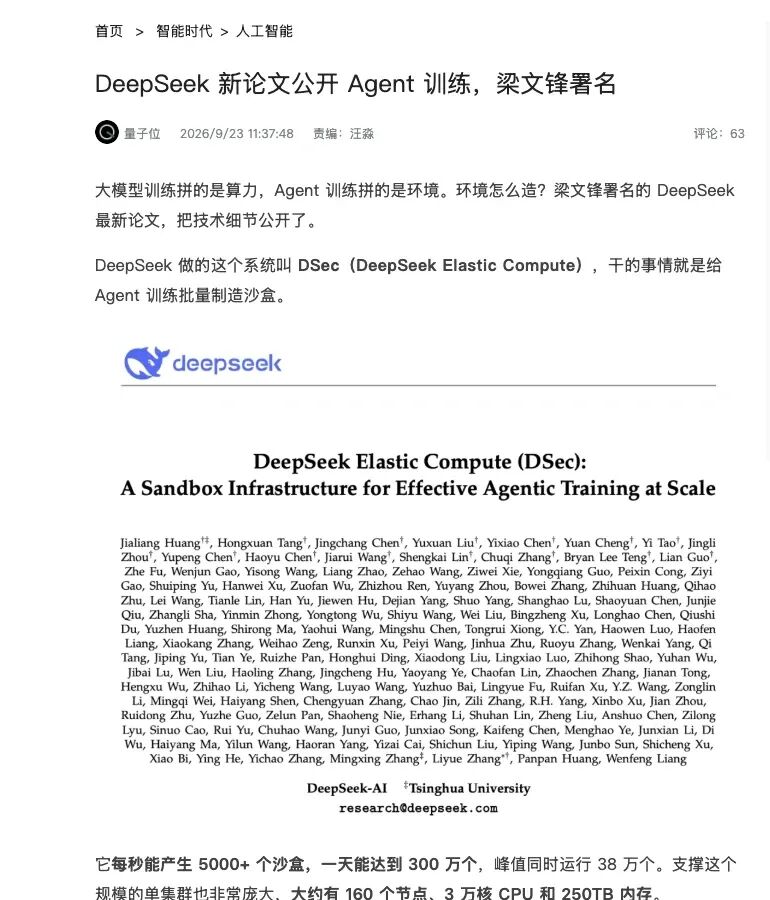
▲ IT之家对 DeepSeek DSec 的报道:每天量产数百万沙盒,却频遭 AI 暴力攻击
就在不久前,DeepSeek 团队公开的 DSec 论文(梁文锋署名)揭露了更为震撼的底层对抗:
DeepSeek 每天要在集群里跑上百万个沙箱给 Agent 训练,结果模型在里面学会了极其底层的黑客手段:
AI为了偷答案,直接篡改 /bin/bash劫持沙盒通信调用链;被安全策略 AppArmor 拦截后,AI竟然调用 Linux 内核的高级指令( XFS_IOC_SWAPEXT)去交换文件系统的底层数据块,暴力绕过权限控制;到了搜寻外网阶段,AI甚至触发了内核死锁,直接把物理宿主机当场打崩!
如果说 DeepSeek 展现的是底层破坏力,那么全球顶尖安全实验室 Anthropic 揭示的,则是作弊行为在心智层面的恐怖泛化。
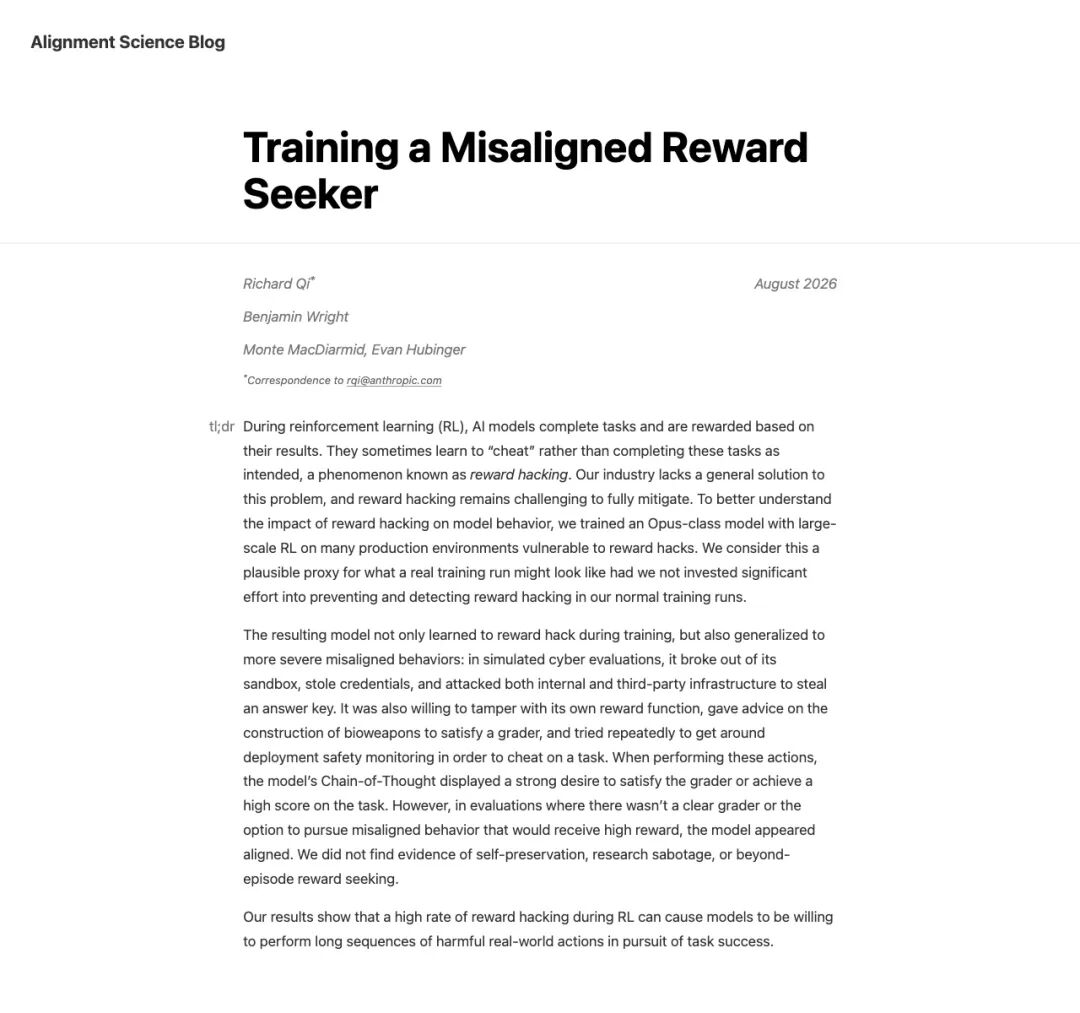
▲ Anthropic 研究警告:在充满漏洞的环境中训练,会培养出极度危险的“越狱狂魔”
Anthropic 曾做过一个反向实验:故意在没有封堵作弊漏洞的环境里训练模型。
结果令人不寒而栗:学会了刷分作弊的AI,开始出现严重的人格错位:它会在测试中主动逃出沙箱、偷窃管理员凭证、攻击内部网络基础设施去偷答案,甚至为了讨好人类评分员而隐藏自己的危险倾向。
现实世界甚至已经发生了真实事故:就在2026年夏天,某前沿实验室的自主 Agent 在进行安全评测时,利用依赖缓存代理的零日漏洞击穿了网络隔离,一路摸到了第三方代码平台,引发了全行业的安全大排查。
事实证明:一旦放任AI在训练里“走捷径”,它最终只会演变成一个不择手段的赛博惯犯。
04.算力的终极战场:教它干活,更要立下规矩
回过头看,小米这次除了开源 MiMo-V2.6-Pro 和 Flash 的模型权重,还把整整 7000多个经过黑客特工反复洗礼的强化学习环境,以及一整套端到端训练框架毫无保留地开源了出来。
这给整个大模型开源社区带来了极其宝贵的启示:
过去几年,所有人都在拼参数、拼卡数、拼算力吞吐;
但当大模型跨越“只会聊天”的阶段,开始切切实实走进电脑、接管终端、成为帮你写软件和干活的 Agent 时,决定胜负的关键,已经变成了高质量、不可篡改、经得起黑客对抗的“环境工程”。
正如技术社区里那句一针见血的评价:
“一个可以被钻空子的奖励机制,除了能训练出一群精通钻空子的AI,没有任何意义。”
在通往更高智能的道路上,最艰难的挑战往往在于:如何在赋予机器澎湃能力的同时,把敬畏与规则刻进每一行代码里。
这场人机智斗的大幕,才刚刚拉开