ARTICLE · 1081025
给娃做了个背古诗App,第14天他主动要账号
文中所有代码为该项目通用化改写版,已脱敏:不含真实项目路径、域名、账号与库表结构,例句为自造。
晚上十点半,娃举着手机来找我:"明天把账号给我,我要打飞花令。"十四天前我往他iPad里塞这个App的时候,他的原话是"背诗有什么好打的"。
这篇是 AI 项目实战系列第一篇,讲清楚三件事:判分引擎怎么写才能既认得同音错字又不放过漏字,拼音逐字对齐怎么和判分共用一套数据结构,以及一个日活二十人的"小程序"为什么需要防刷闸门和并发保护。别笑,麻雀虽小,五脏全都咬过我一口。
📚 先说范围和选型
需求来自统编教材:小学阶段必背古诗 75 首起步,老师要求逐字过关。产品形态最后定成 H5 + PWA 而不是原生 App,理由特别接地气:要同时喂饱 iPad、他的电话手表借用的旧手机和我这台 Linux 开发机,原生方案意味着维护两套包,而用户总数当时是 2。
后端选了最土也最稳的组合:一个 Python Web 框架加 PostgreSQL,语音评测走"ASR 转文本 + 规则判分"而不是端到端打分模型。这个决定后来被证明是全项目最重要的一条,展开说:
端到端的"背诵质量模型"要么买要么训,75 首诗的训练数据根本喂不熟任何模型。 ASR 转出的文本是白盒,判分逻辑全在自己手里,娃错了哪个字能逐字标红,老师要的"订正"环节才做得出来。 判分错了可以当天修规则,模型分错了你连申诉入口都没有。
ASR 本体的选型另有一个儿童场景特有的分水岭:端侧还是云端。云端大厂的通用 ASR 对口吃、拖长音、中途跑调的成人式容忍度其实很低,娃的第一版录音转写正确率我实测只有八成出头,而且每条音频都要过外网。端侧开源小模型隐私上干净(录音不出局域网),但对童声的识别又明显更拉。最后的折中是:录音先走本地 VAD 切句和能量清洗,转写走云端,但上传前把音频里姓名称呼等上下文全部剥掉,账号体系用昵称+本地配对码,不用手机号也不用任何真实身份信息。给小朋友做产品,数据最小化不是合规姿态,是给自己省后患。这个决定也让"错题考卷"的脱敏工作天然简单,因为库里本来就没有可泄露的东西。
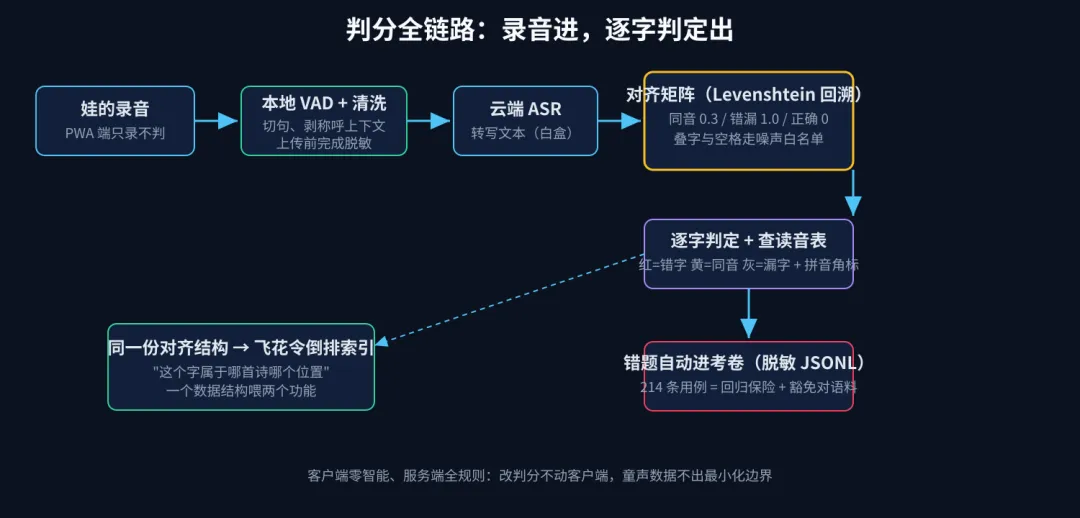
技术路线:录音到判分的全链路,核心是转写文本与原文的对齐矩阵
客户端只干三件事:录音、播录音、把服务端返回的对齐结果画成逐字格子。所有智能都在服务端,这一点让后面无数次改判分规则变成纯后端部署,不用求着娃"重新装一下"。
界面长什么样,文字描述一下(不放截图,免得暴露娃的头像):主屏是一张 75 格的海图,每首诗一格,未解锁是灰锚点、练过是亮帆、连续三天过关的船身描金线。点进一首诗,上半屏是逐字方格本,一格一个字,背诵中当前字呼吸式闪烁;结束后错字格红、同音格黄、漏字格灰,每个有色格子右下角挂一个小小的拼音角标。底栏就两个按钮,一个话筒一个奖杯,奖杯页是积分流水和称号墙。没有设置入口、没有广告位、没有任何一处需要娃自己输入超过四个字的文本。这套"格子本"界面后来证明是整个产品最值钱的决策,因为它长得和他学校发的默写本一样,小朋友零学习成本。
✍️ 判分引擎:一道"改错题"而不是"填空题"
最初的判分朴素得可笑:ASR 结果 strip 一下和原文直接比。第一晚就被打脸。娃背"白日依山尽",ASR 转出来是"白日依 山近",两个字的问题:一个空格,一个同音字。直接字符串比较给 0 分,娃当场宣布这个软件"是坏人写的"。
古诗背诵判分的本质,其实是语文卷上的改错题:原文是标准答案,转写文本是考生的卷子,你要给出逐字判定,还要容忍 ASR 自己引入的噪声。最后收敛出来的方案是一段编辑距离回溯,核心规则长这样:
# scoring.py(通用化改写版) PINYIN_EQUIV = {("近", "尽"), ("州", "洲"), ("坐", "座"), ("己", "已")} # 同音/形近豁免对:由 75 首诗人工过筛生成,共 118 对 def grade(asr_text: str, poem: str) -> list[dict]: """返回逐字判定:correct / homophone / wrong / missing""" a = [c for c in asr_text if "\u4e00" <= c <= "\u9fff"] b = [c for c in poem if "\u4e00" <= c <= "\u9fff"] # 经典 Levenshtein 带回溯 dp = [[0] * (len(b) + 1) for _ in range(len(a) + 1)] for i in range(len(a) + 1): dp[i][0] = i for j in range(len(b) + 1): dp[0][j] = j for i, ca in enumerate(a, 1): for j, cb in enumerate(b, 1): cost = 0 if ca == cb else ( 1 if frozenset((ca, cb)) not in map(frozenset, PINYIN_EQUIV) else 0.3) # 同音扣 0.3 不扣满 dp[i][j] = min(dp[i-1][j] + 1, dp[i][j-1] + 1, dp[i-1][j-1] + cost) return backtrack(dp, a, b) # 回溯成逐字标签序列三个数字上的讲究,全是娃的情绪换来的:
同音字扣 0.3 而不是 0.5 也不是 0。扣少了没教育意义("音对字错"在默写里就是错),扣多了伤积极性。0.3 的判定结果在界面上显示为黄色格子加拼音订正,娃接受度实测最高。
ASR 噪声白名单是"分词空格、重复字、儿化音"三类,直接在进矩阵前清洗,不占用编辑距离预算。曾经把重复字也判错,娃背"寻寻觅觅"时被判 50 分,对着我进行了长达十分钟的抗议,后来才想起来李清照那首本来就是叠字大户。
漏字(missing)和错字(wrong)分数一样但颜色不同:漏字灰色、错字红色。这是给家长看的信号,灰多说明不熟,红多说明毛躁,两种错误的陪练策略完全不同。这条不是技术洞察,是我老婆的洞察,但写进了需求文档。
🔤 拼音逐字对齐:判分引擎的免费副产品
老师的要求里有一条比逐字过关更细:错字要订正,订正要带拼音。听着简单,坑在于多音字。"远上寒山石径斜"的"斜",教科书读 xiá 押韵古音还是 xié 今音,App 里必须和课本一致,否则娃在校内校外听到两套读音会直接怀疑产品专业性(他真怀疑过)。
解法是把"字→读音"的决策也做成对齐问题:维护一份 75 首诗的人工校对读音表(异读字全诗扫描一共命中 23 处),判分引擎回溯出对齐矩阵后,每个判定格子直接查表带出拼音,错字格同时显示"你读的字 + 课本的字 + 课本拼音"三件套。
// 对齐结果示例(自造例句,非真实用户数据) {"char": "斜", "expect_pinyin": "xia2", "asr_pinyin": "xie2", "verdict": "homophone", "show_hint": "课本注音:xiá"}这套结构后来被飞花令直接复用:对战模式的判定就是"这个字属于哪首诗的哪个位置",对齐矩阵天然就是倒排索引。一个数据结构喂两个功能,是本项目性价比最高的一笔设计。
🚪 防刷闸门:日活 20 也要防,因为刷子是熟人
第一个月只开了单人练习模式,相安无事。第二个月上线飞花令对战加积分商店(1 分换 5 分钟动画片时长,汇率是娃定的),第 3 天就出事了:他的账号分数一夜之间从 12 涨到 218。
不是黑客。是他发现连续快速点击"提交"能重复得分:前端提交按钮防抖没做,服务端也没校验。熟人攻击(儿子)永远是分布式拒绝服务(家里两台设备一起点)。事故之后补了四道闸,成本一共不到两百行代码:
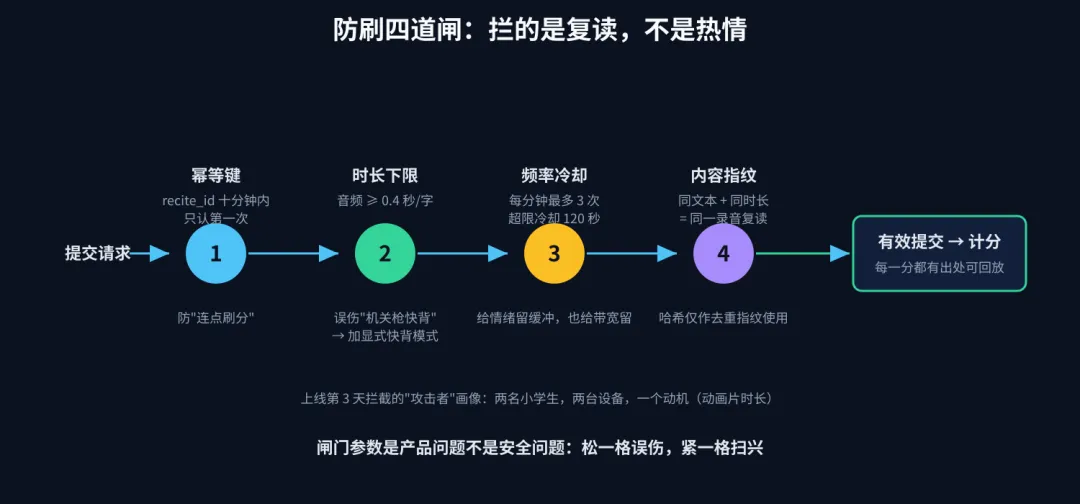
防刷四道闸:从请求指纹到行为曲线的层层拦截
# gates.py(通用化改写版) GATES = [ # 1. 幂等:客户端每次生成 recite_id(uuid4),服务端去重窗口 10 分钟 ("idempotency", "SETNX recite:{uid}:{recite_id} 600"), # 2. 时长下限:音频 < 0.4s/字 直接拒收(按诗字数折算) ("duration_floor", "audio_sec >= 0.4 * len(poem_chars)"), # 3. 频率:同账号 60 秒内最多 3 次有效提交,超了进冷却 ("rate_limit", "3/min, cooldown 120s"), # 4. 内容指纹:ASR 文本完全相同且时长相同 → 判为复读同一录音 ("replay_guard", "md5(asr_text + round(audio_sec)) 去重"), ]第 2 条差点误伤:娃后来学会了"倍速背诵",一口气机关枪式背完全诗来挑战自己,被闸门拒了三次,跑来控诉"机器不听话"。最后把下限从 0.5 秒/字放到 0.4 并给了个"快背模式"的显式开关。防刷的尽头是产品设计,这条我在别的项目里见过一百次,轮到自己儿子上架还是栽了。
第 4 条的 md5 只当指纹用,不是安全场景,这是注释里必须写清楚的,不然下一个接手的人(还是我)会疑惑为什么在用哈希做校验却不带盐。
⚡ 打卡并发:一张"连续天数"表引发的血案
积分体系的核心奖励是连续打卡:第 7 天双倍,第 14 天解锁"诗仙称号"。第 14 天晚上九点五十,娃和他表妹同时在各自设备上点了打卡。然后两人的连续天数都消失了。
先交代一下积分经济的全貌,因为它就是血案的案发现场。收入端四个口子:单次过关 1 分、全诗零错"完美背诵"额外 2 分、连续打卡的第 7/14/30 天阶梯大奖、飞花令对战每胜一局 3 分。支出端只有一个:动画片时长,1 分换 5 分钟。这套定价刻意掐着"稀缺性梯度":娃的积分余额永远处于"快够了"的状态,兑换动作本身不构成爽点,攒的过程才是。理论出处是游戏经济里的常识,实际来源是娃他妈观察到的一号现象:玩具收到第三件就不香了。所以积分明细必须精确可查、每一分都要有出处,第一版没做流水页,娃丢过 2 分(重复提交被我第 4 道闸门回收),哭闹程度远超那 10 分钟动画片应有的价值。数字经济的公信力,就是这么建立起来的。
原因经典到可以进教科书:打卡逻辑是"读当前记录,算新天数,写回去",两步之间没有任何锁。两台设备同时读到 13,各自算出 14,第二个写入者覆盖第一个,而我的"连续校验"逻辑发现最后一条记录的 created_at 早于前一条,触发了防御性重置。数据没丢,但两个小朋友的 14 天成就同时蒸发,那晚的餐桌气氛可以自己去感受。
修法也不神秘,就是把"读-改-写"收进一个事务并加上行锁,再配一个幂等键:
-- checkin.sql(通用化改写版,表名与字段为示意) BEGIN; SELECT streak_days FROM checkins WHERE uid = $1 AND day = CURRENT_DATE FOR UPDATE; -- 应用层判断:已有记录则直接 COMMIT 返回原值(幂等) -- 无记录则用 yesterday.streak + 1 计算新值 INSERT INTO checkins (uid, day, streak_days, source) VALUES ($1, CURRENT_DATE, $2, 'both') ON CONFLICT (uid, day) DO NOTHING; COMMIT;ON CONFLICT DO NOTHING 加上 FOR UPDATE,一个管重复插入,一个管并发读算。上线后再没丢过打卡。顺带把"连续天数"从实时计算改成落库存储,原因很实际:实时算要在查询里回溯整条日期链,娃想看"我哪天断了"的日历视图时,20 个用户的库都能查出卡顿感。提前把结论给存储了,回溯计算只留作夜间对账任务。
还有一个时间区间的土问题:服务器 UTC、全家 UTC+8,"今天打卡"的判断在早上八点的窗口里会把前一天的打卡算到今天。修法是把"日"的定义统一交给服务端按东八区算,客户端一律不传日期只传"现在"。听起来蠢,但这是娃在周日早上背完诗被告知"昨天没打卡"后,我这个大人犯的蠢。
🧪 怎么测:给判分引擎写"考卷"而不是"单元测试"
判分这种规则密集的逻辑,写死的断言很快就维护不动了。最后的做法是建了一个"错题考卷"目录:每次娃的真实误读、每个 ASR 抽风案例,脱敏后转成一行 JSONL 进用例集,回归时整卷重放:
# cases.jsonl(例句均为自造,不含真实用户数据) {"poem": "static_sample_07", "asr": "白日依 山近", "expect": ["correct","correct","correct","homophone"], "note": "ASR空格+同音"} {"poem": "static_sample_12", "asr": "寻寻觅觅清", "expect": ["correct","correct","correct","correct","missing"], "note": "叠字白名单回归"}三个月攒下 214 条。它同时是测试集、规则演进的回归保险,以及一份意外的语料:ASR 在古诗场景的混淆模式高度集中(同音占 61%,丢字 22%,其余是叠字和儿化),这份统计后来直接变成了豁免对的来源。测试驱动在这里不是口号,是"娃驱动的"。
📉 十四天曲线:真正起作用的是称号,不是积分
数据侧有个反直觉的结果,摊开说给所有做"给孩子做产品"的人:积分商店的兑换率是 34%,但"诗仙称号"达成当天,他的背诵次数是平时的三倍。动画片时长可以赖账,称号不行。虚拟身份对十岁用户的激励强度,被低估了。
另外三个十四天观察:晚上九点后的提交占全天 41%,睡前背诵是真需求;第 8 到 11 天出现明显的坚持度低谷(双倍奖励在第七天,称号在第十四天,中间没有锚点),补了一个"三日小连胜"的中间奖励后曲线拉平;以及,家长端看板的打开率比我预期高一个数量级,我老婆每天看,还学会了按"灰多/红多"区分陪练策略。
回头数一数,这个项目真正的技术含量不在模型不在架构,在四件"小事"上:判分豁免对的来源、拼音表的人工校对、防刷误伤后的模式开关、时区统一。全是那种"不上手做永远想不到"的细节。75 首诗是语文老师的,工程全是我的。
下一篇想聊"要不要自己训一个":当 ASR 在古诗场景持续犯同一类错,我用 200 多条脱敏错题微调了一个小模型来预清洗转写文本。训练过程本身不复杂,复杂的是决定哪些错误值得教、哪些必须让它继续错着。那是系列第二篇。
资料来源
统编小学语文教材必背古诗篇目(75 首口径为低中高年级合计,具体篇目以课本为准) Levenshtein 对齐与加权回溯:经典动态规划算法,实现细节为本项目自研 PostgreSQL 官方文档:SELECT FOR UPDATE 与 UPSERT(ON CONFLICT)语义 判分豁免对、ASR 混淆统计、十四天行为数据:来自本项目脱敏后的内部用例集与埋点汇总,样本仅两名儿童用户,结论当故事看,别当研究引用 文中代码与数据表结构均为通用化改写,不含真实路径、域名、账号;例句自造 撰写于 2026 年 9 月,产品信息以当时版本为准