ARTICLE · 1087249
卸载到 CPU:单卡省 8 倍显存,64 卡后还债
上期把 ZeRO 三档的账算完了,结尾留了一句:装不下的时候,最后一招是把状态搬出 GPU。很多人对这招的第一反应是——PCIe 只有 12 GB/s,搬来搬去不是白折腾?这个直觉对了一半。在显存不够的规模上,卸载不慢,它是唯一能跑的方案;真正的代价,要到卡数上量之后才开始收。
今天的账分三段算:每步最少要搬多少、慢在哪一步、以及为什么把参数切开之后,单节点那条 12 GB/s 的 PCIe 能变成 48 GB/s。
01 · 搬东西也有理论下限
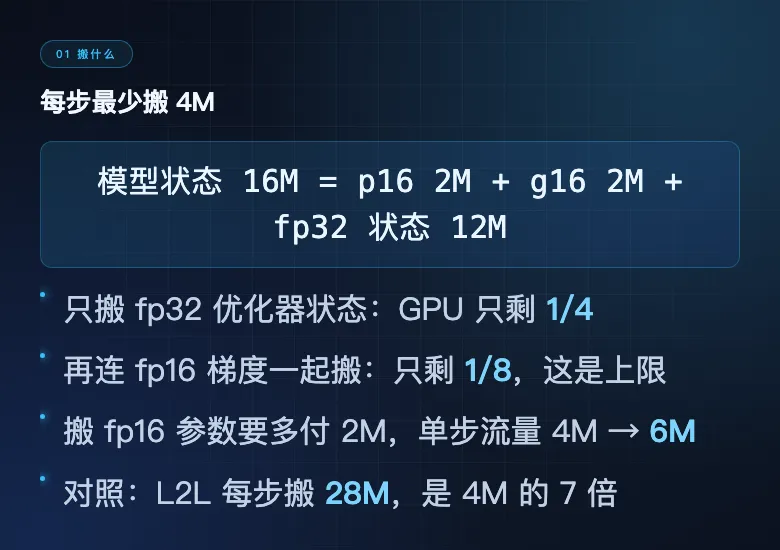
混合精度训练下,一个参数量为 M 的模型,模型状态是 16M:fp16 参数 2M、fp16 梯度 2M、fp32 的 Adam 状态 12M,也就是动量、方差、fp32 主权重各 4M。要省显存,只能把这些中的一部分搬出 GPU。既然是搬,先问一句:最少要搬多少?ZeRO-Offload 的论文用数据流图算到了底——任何把模型状态搬出去的方案,单步搬运量的下限都是 4M,因为前反向计算和优化器更新构成了一个环,要切开它至少切两条边,而每条边的权重都不低于 2M。
一、只把 fp32 优化器状态搬到 CPU。GPU 上留下 fp16 参数和 fp16 梯度,模型状态从 16M 降到 4M,只剩原来的 1/4。
二、再把 fp16 梯度一起搬。GPU 上只剩 fp16 参数,16M 降到 2M,只剩 1/8。这就是卸载的极限——8 倍是上限,不是平均值。
三、fp16 参数必须留在 GPU。如果把它也搬走,前向和反向每次都要取回来,单步流量从 4M 涨到 6M,省下的显存是用更贵的带宽换的。
ZeRO-Offload 走的就是第二条路:fp16 参数留 GPU,前反向在 GPU 上算;fp16 梯度、fp32 优化器状态、以及优化器更新本身全部放 CPU。它本质上是 ZeRO 第二档的分片加卸载——梯度按数据并行度切开,每张卡只把自己那一份往 CPU 传,聚合到 CPU 的流量与卡数无关;每张卡也只更新一部分参数,CPU 的更新工作被并行分掉,卡越多,单次更新越短。
作为对照,另一个方案 L2L 每步要在 GPU 和 CPU 之间搬 28M,是 4M 的 7 倍。搬得越多越慢,多出来的流量最后都体现在吞吐上。
02 · 单卡上它不慢,因为没得选
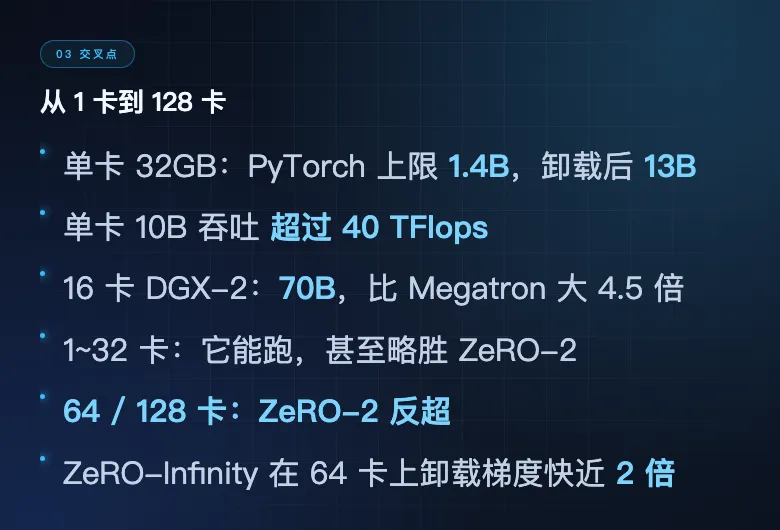
先看上限。32GB 显存的 V100 上,PyTorch 数据并行能训下的最大模型是 1.4B,再大就 OOM;Megatron 和 ZeRO-2 在单卡上并没能把这个上限顶上去,因为它们靠的是多卡显存聚合。ZeRO-Offload 把单卡上限推到 13B,比它们大 9 倍以上。吞吐更值得看:用单张 V100 训 10B 模型,它能跑到 40 TFlops 以上;而在不做任何卸载时,能装下的最大模型(约 1.4B)只有 30 TFLOPS。参数大了七倍,吞吐反而更高。
为什么没被 PCIe 拖死?因为搬运的时机是对的:梯度在反向传播里算出一块就立刻传一块,能和后面的反向计算重叠,GPU 不用停在那里等。CPU 那一侧的 Adam 也不是裸跑。DeepSpeed 的实现用了 SIMD、循环展开和多线程,比 PyTorch 的 CPU 版 Adam 快 5 倍以上,1B 参数规模下能到 6.4 倍;和 GPU 版 PyTorch Adam 相比,性能差距已经不大。
还有一个开关叫延迟参数更新:把优化器更新推迟一步,让它和下一轮的前反向重叠。论文里端到端吞吐最多再提升 1.5 倍,代价是训练曲线在最初几千步收敛略慢,5K 步之后追平。
再把规模放大一层:在单台 DGX-2(16 张 V100)上,配合模型并行,ZeRO-Offload 能训到 70B,相比 PyTorch、Megatron、ZeRO-2、L2L 分别提升 50 倍、4.5 倍、7.8 倍和 4.2 倍。
03 · 真正的软肋是「不能重叠的那一块」
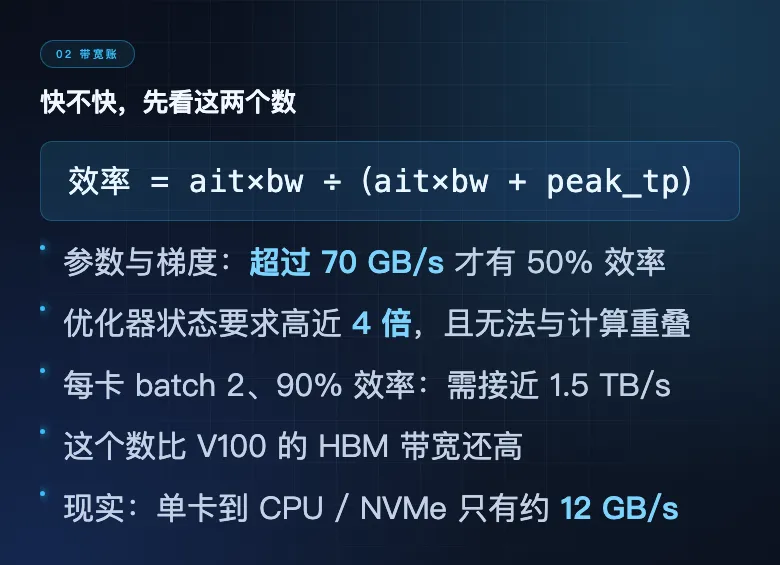
卸载的瓶颈不在「搬得慢」,而在「有些东西没法重叠着搬」。
论文把训练对带宽的需求拆成两块。参数和梯度:要拿到 50% 以上的效率,带宽得超过 70 GB/s,这已经接近 DGX-2 节点内 GPU 之间的通信带宽。优化器状态:它的更新发生在前后向全部结束之后,无法与计算重叠,所以对带宽的要求比参数梯度高出近 4 倍;按论文的测算,每卡 batch 为 2 时想拿到 90% 的效率,有效带宽要接近 1.5 TB/s,比单张 V100 的 HBM 带宽还高。
效率 = ait × bw ÷(ait × bw + peak_tp)ait = 算术强度(每搬一字节能算多少次),bw = 可用带宽,peak_tp = 峰值算力参数与梯度:要超过 70 GB/s 才有 50% 效率优化器状态:要求高近 4 倍,且无法与计算重叠而单卡到 CPU / NVMe 的现实带宽:约 12 GB/s(PCIe Gen 3)
再看实测的交叉点。1 到 16 卡这一段,ZeRO-2 直接 OOM,ZeRO-Offload 能把模型训起来,这是从不可行到可行。32 卡时它甚至略胜 ZeRO-2:省下的显存换成了更大的 batch,计算效率更高。但到 64 卡和 128 卡,ZeRO-2 反超了——两边能用的 batch 已经差不多,它却多了一趟 CPU 与 GPU 之间的搬运。
所以「到底慢多少」分两段回答:在显存不够的规模上,它不慢,它是唯一解;到了卡数足够多、ZeRO-2 自己就装得下的规模,它开始为那趟搬运付费,卡越多越明显。
04 · 把「一个人扛」改成「一排人一起搬」
为什么搬东西这条路的有效带宽上限只有 12 GB/s?因为 ZeRO-Offload 的参数在每张卡上都有一份完整副本,走的是广播式路径:某张卡要用的参数,先得通过它那一条 PCIe 从 CPU 或 NVMe 取回自己显卡,再广播给其他卡。整个过程只有一条 PCIe 在干活,其余通道空转;参数必须先到 owner GPU 这一点,也逼着你把 batch 做得足够大,才能靠算术强度撑住这点带宽。
ZeRO-Infinity 换掉了这个前提:参数和梯度直接按数据并行度切开,每张卡只负责读自己那 1/dp 的份额,再用 all-gather 把完整参数拼出来。所有 PCIe 于是同时工作——单台 DGX-2 上,CPU 方向的有效带宽从约 12 GB/s 提到约 48 GB/s,折合每卡 3.0 GB/s;NVMe 方向约 25 GB/s,每卡 1.6 GB/s。再往上按节点数线性叠加:64 个 DGX-2 节点能聚出超过 3 TB/s 的 CPU 内存带宽和超过 1.5 TB/s 的 NVMe 带宽。
效果对着数字看:同样给 8B 模型卸载梯度,ZeRO-Infinity 在 64 卡上比 ZeRO-Offload 快近 2 倍;训 1T 参数的模型从 64 卡扩到 512 卡是超线性的。规模上,512 张 V100 能训 32T 参数的模型,是 3D 并行约 650B 上限的 50 倍,吞吐超过 25 PFLOPS,相当于峰值算力的 40%;单台 DGX-2 就能微调 1T 参数的模型,而论文的估算是,3D 并行光是装下这个模型就需要 800 张 V100。
也有掉速的地方。模型从 10T 涨到 20T,吞吐从 43 TFlops/GPU 掉到 34 TFlops/GPU,论文给的原因不是 NVMe 慢,而是激活检查点把 CPU 内存吃满,每卡 batch 被压得太小。激活检查点卸载本身倒是不贵:hidden size 到 8K 以上时,不到 1 GB/s 的带宽就能维持 50% 以上的效率,32K 和 64K 时几乎没有影响。
往前看一步:论文测算,单卡算力比 V100 涨 10 倍时,512 卡的集群只要每卡 30 GB/s 的慢速内存带宽就能维持效率;而 2018 年的 Summit 超算,V100 到 CPU 内存的通道就已经有 40 GB/s 每卡。慢速内存不是天花板,带宽的账才是。
05 · 落到配置里就三个开关
stage 选到 1、2、3;offload_optimizer.device 选 cpu 或 nvme,注意优化器的计算无论如何都在 CPU 上执行,这个选项决定的是优化器状态放哪;offload_param.device 同样可选 cpu 或 nvme,但它只在第三档有效。两个名词这样对应:ZeRO-Offload 是第二档加优化器卸载,参数仍留在每张卡上,所以模型规模的上限还是单卡显存;ZeRO-Infinity 是第三档加 infinity offload engine,参数也能一起搬走,官方文档说它能卸载更多数据,带宽利用和计算重叠也更好。
参数里有几个值得留意。pin_memory 默认开启,锁页内存让 CPU 与 GPU 之间的异步 DMA 跑满带宽,也让梯度卸下去这个动作能和反向计算重叠,代价是占 ulimit -l 的额度,限制紧时报 OOM 就把它关掉;buffer_count 建议不低于优化器维护的状态数,Adam 是 4;buffer_size 默认 1e8,max_in_cpu 默认 1e9;异步 I/O 那组默认 1MB 块、队列深度 8。另外有两个省内存的开关:ratio 控制只在 CPU 上更新的参数比例,默认 1 就是全量;梯度累积步数多或卡数多时打开 round_robin_gradients,它把梯度拷贝到 CPU 的活按更细粒度分给不同进程。还有一笔账可以算——把 fp32 主权重换成 bf16 后,卸载出去的状态大约只要 6 字节/参数,而保留 fp32 动量时要约 10 字节/参数。
选型顺序可以固定成一条:先开第二档分片;装不下,把优化器状态和梯度卸到 CPU 内存;还装不下,参数也一起卸(第三档);NVMe 放最后,因为它慢一个数量级。另外记住论文里那句话——ZeRO-Offload 需要较大的 batch 才能保持效率,限制来自数据分区方式和 PCIe 带宽。所以真要卸载,先把每卡 batch 尽量拉大。
写在最后
三句话:一、卸载的上限是 8 倍显存,代价是每步最少 4M 的搬运,多搬一点都不划算;二、单卡和中小规模上它不慢,优化器状态不能与计算重叠才是真正的软肋;三、把参数切开一起搬,单节点的有效带宽能从 12 GB/s 抬到几十 GB/s,规模越大越划算。
下一篇换换口味,不再算显存,讲推理侧的优化:连续批处理、分页显存、投机解码这些手段分别在省什么。
你现在跑训练用的是哪一档?有没有试过把优化器状态卸到 CPU,吞吐掉了多少?留言报一下模型大小、卡数和 PCIe 代际,我帮你算算这趟搬运值不值。