ARTICLE · 1117411
装再多 App,内存也不爆的底牌:写时复制(COW)
几十个 App 合住同一份框架内存,却谁也不挤着谁——内核这笔账的精髓是:能不搬的,一页都不搬。
引言:说好的复制,内核按了暂停
先看一个实验。一个 Python 进程实打实吃掉 1GB 内存,然后 fork 出一个子进程,子进程什么都不做就退出(下文第五节有完整说明):
$ python3 fork-speed.pyfork 1GB 进程,第 1 次: 8.4 msfork 1GB 进程,第 2 次: 6.3 msfork 1GB 进程,第 3 次: 6.4 msfork 的语义是「复制一个进程」——子进程理应拿到父进程全部内存的副本。1GB 的复制,6 毫秒?顺手再看空闲内存(MemAvailable),fork 前后分毫未动,这 1GB 像是从未被复制过。
这不是障眼法,而是内核把「复制」当成承诺而非动作:fork 时先记账、不动手,等某一方真的要写了,才兑现其中一页。这套机制叫写时复制(Copy-on-Write,COW),它是 fork 能一直便宜到今天的基础,也是 Android「装再多 App 内存也不爆」的底气。这篇文章讲清楚:
fork 那一刻内核做了什么,为什么 1GB 只要几毫秒 第一次写入时发生什么:一页 4KB 的完整旅程 亲手观测 COW:RSS 会说谎,Private_Dirty 不敢 zygote 怎样靠 COW 让每个 App 共享整套框架 同一款把戏还藏在哪:mmap、posix_spawn、Redis 快照
一、fork 那一刻:只做一半的复制
fork 的经典语义来自 Unix:子进程获得父进程地址空间的完整副本。字面执行就是逐字节把 1GB 拷一份——真这么干,少说几百毫秒,内存直接砍半,上世纪的机器根本玩不起。
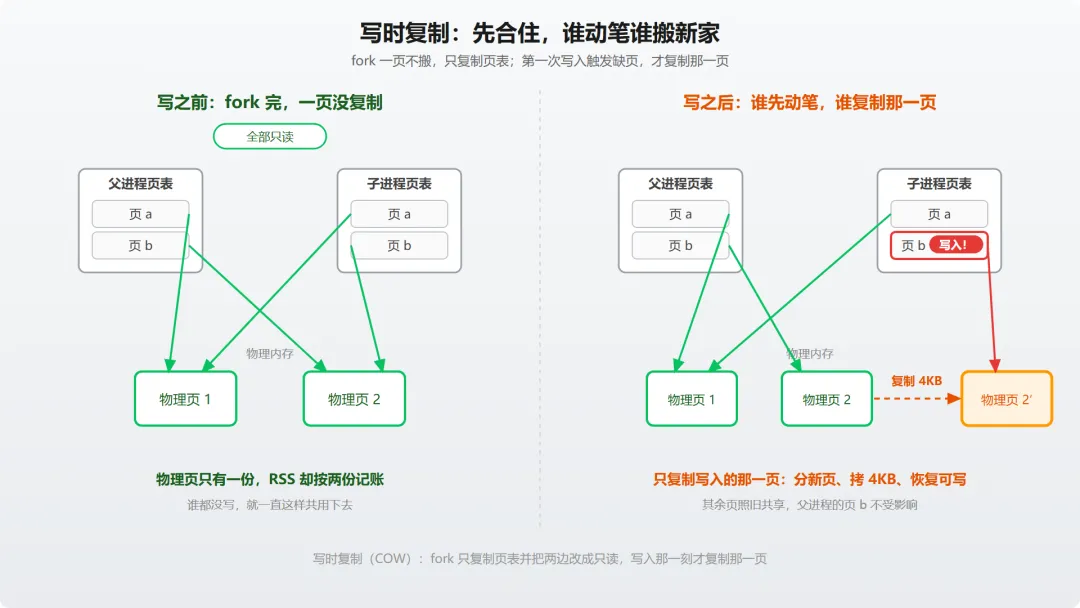
内核的实际做法在 dup_mmap()(kernel/fork.c):遍历父进程的每个内存区域(VMA),为子进程复制一份页表,而不是页。数据还躺在原来的物理页上,只是从此两本页表都记着它们。
页表有多小?x86-64 上一个 4KB 页对应一个 8 字节的页表项(PTE),1GB 就是 262144 页,最底层页表合计约 2MB(加上多级结构的零头也大不了多少)。fork 复制的是这 2MB,不是那 1GB——量级差五百倍,这就是 6 毫秒的全部秘密。
复制页表时,内核做了一个决定性的小动作。mm/memory.c 的 __copy_present_ptes():
/* If it's a COW mapping, write protect it both processes. */if (is_cow_mapping(src_vma->vm_flags) && pte_write(pte)) { wrprotect_ptes(src_mm, addr, src_pte, nr); pte = pte_wrprotect(pte);}注释原话就是答案:COW 映射的页,父子两边一起改成只读。于是 fork 完成时,整份地址空间变成一纸合住协议:
两本页表,指向同一排物理页 所有页标记为只读——不是数据只读,是「写会触发缺页」的只读 地雷埋好了,引信是任何一方的第一次写入
有个细节值得停一秒:把父进程自己的页也改成只读,是有代价的——父进程接下来的每次写都要吃一次缺页。内核认这笔账,因为它赌的是大部分内存父子总有一方不会写。赌赢的概率,就是 COW 存在的理由。
二、第一次写入:一页的完整旅程
现在子进程往「页 b」里写了一个字节。
MMU 一查页表:只读。写操作当场被拦下,CPU 抛出缺页异常,闯进内核。缺页处理程序一看:这页就在内存里、VMA 本身可写、PTE 却是只读——三个条件凑齐,这是一次写保护缺页,交给 do_wp_page()(mm/memory.c)处理。
do_wp_page() 的态度很克制:私有映射先看看能不能不复制——比如这页其实只归当前进程独占,直接把只读改回可写就收工;确认真有人在共享,才走 wp_page_copy()(源码节选):
new_folio = folio_prealloc(mm, vma, vmf->address, pfn_is_zero);...err = __wp_page_copy_user(&new_folio->page, vmf->page, vmf);...ptep_clear_flush(vma, vmf->address, vmf->pte);...entry = maybe_mkwrite(pte_mkdirty(entry), vma);...set_pte_at(mm, vmf->address, vmf->pte, entry);四步:分配一个新物理页;把旧页的 4KB 拷过来;子进程页表里这条 PTE 换成指向新页;恢复可写。返回用户态,那条写指令从哪里跌倒从哪里爬起,重新执行——进程对这一切毫无感知。
这就是「一页的旅程」的全部:没有批量,没有预感,谁写哪页就复制哪页,一次 4KB。写 100MB 就是 25600 次这样的旅程,一页不多,一页不少。
顺带把它挂回老地方。这趟旅程在《缺页的两种价格:Linux 的 Major Fault 与 Minor Fault》里叫 minor fault——数据就在内存里,不用碰盘,微秒级办完。COW 是 minor fault 的三大来源之一(另外两个:匿名页第一次触碰、文件页已在缓存),也是其中最有戏剧性的一种:缺页的原因不是「没数据」,而是「数据先不给」。
三、实测:RSS 会说谎,Private_Dirty 不敢
三十行 Python,把 COW 抓个现行。父进程吃满 100MB 后 fork,子进程先看账、再逐页写、再看账:
import os, time, sysSIZE = 100 * 1024 * 1024 # 100 MBdef rollup(pid, key): with open(f'/proc/{pid}/smaps_rollup') as f: for line in f: if line.startswith(key + ':'): return int(line.split()[1]) / 1024def mem_avail_mb(): with open('/proc/meminfo') as f: for line in f: if line.startswith('MemAvailable:'): return int(line.split()[1]) / 1024def min_flt(pid): with open(f'/proc/{pid}/stat') as f: return int(f.read().rsplit(') ', 1)[1].split()[7])buf = bytearray(SIZE)for i in range(0, SIZE, 4096): buf[i] = 1 # 触碰每一页,让 100MB 真正落进物理内存t0 = time.perf_counter()pid = os.fork()if pid == 0: # ---- 子进程 ---- time.sleep(0.5) print(f'子进程写之前: Rss {rollup(os.getpid(), "Rss"):.1f} MB, ' f'Private_Dirty {rollup(os.getpid(), "Private_Dirty"):.1f} MB', flush=True) flt0 = min_flt(os.getpid()) for i in range(0, SIZE, 4096): buf[i] = 2 # 每页的第一次写:一次 COW 缺页 flt1 = min_flt(os.getpid()) print(f'子进程写之后: Rss {rollup(os.getpid(), "Rss"):.1f} MB, ' f'Private_Dirty {rollup(os.getpid(), "Private_Dirty"):.1f} MB', flush=True) print(f'期间 minor fault: {flt1 - flt0}', flush=True) sys.stdout.flush() os._exit(0)# ---- 父进程 ----print(f'fork 后 MemAvailable(子进程还没动笔): {mem_avail_mb():.0f} MB, ' f'fork 用时 {(time.perf_counter() - t0) * 1000:.1f} ms', flush=True)os.waitpid(pid, 0)print(f'子进程写完全部页面后 MemAvailable: {mem_avail_mb():.0f} MB', flush=True)实测输出(WSL2,内核 6.18,Python 3.12):
父进程: Private_Dirty 103.9 MB, MemAvailable 14901 MBfork 后 MemAvailable(子进程还没动笔): 14906 MB, fork 用时 1.3 ms子进程写之前: Rss 107.9 MB, Private_Dirty 0.7 MB子进程写之后: Rss 108.3 MB, Private_Dirty 100.8 MB期间 minor fault: 25614子进程写完全部页面后 MemAvailable: 14811 MB六行数字,四件事:
子进程一页未写时,Rss 高达 107.9MB,Private_Dirty 却只有 0.7MB——RSS 把共享的 100MB 整份记在了它头上,而它真实拥有的不足 1MB。「fork 之后内存翻倍」从头到尾只是账面幻觉 逐页写完后 Private_Dirty 涨到 100.8MB:复制真的发生了,但每页 4KB、只发生在被写的那页 期间 25614 次 minor fault,对上理论值 25600(100MB ÷ 4KB),多出的十几次来自栈和解释器自己的写入 MemAvailable 在 fork 后纹丝不动(14901 → 14906,多出的 5MB 是噪声),子进程写完才真金白银掉下去约 95MB。fork 不花内存,写才花
拿走就能用的一条:看进程真实内存占用,别看 Rss,看 /proc/<pid>/smaps_rollup 的 Private_Dirty(4.14 以后的内核都有;更细可看 Pss)——Android 上对应 adb shell dumpsys meminfo <包名> 的 Private Dirty 列,评判一个 App 吃多少内存,业界口径就是它。
四、Android 落点:zygote,全体 App 的母带
现在回答标题的问题。Android 上每打开一个 App,系统并不是从零启动一个进程:有个叫 zygote 的常驻进程,开机时就加载好 ART 虚拟机、常用的 framework 类和系统资源,然后所有 App 进程都由它 fork 出来。
fork 的瞬间,COW 接管一切:zygote 那几十上百 MB 的框架内存一页都没复制——新 App 的页表全部指向 zygote 的页,只读共享。App 读 framework 代码、用系统资源,全程不花私有内存的一分钱;只有自己写堆、产生 JIT 编译产物、改全局状态时,被写的那些页才逐渐「搬出去」变成私有。
所以「装再多 App,内存也不爆」的完整答案是分层的:
共享是常态:框架与资源几百个进程共用一份,COW 保证不写不复制 私有是例外:每个 App 真正付钱的,只有自己的业务数据 兜底另有其人:写多了内存终究会紧,紧张时负责挑进程下手的,是 lmkd——《谁在悄悄杀你手机里的 App:Android 的 lmkd》讲的就是它
启动快也沾这份光:fork 一个早已热身的 zygote,比从零加载整套框架快得多,这是 Android 应用秒开的前半程(后半程在《冷启动、温启动、热启动:深入理解 Android 应用启动的三种形态》里)。
五、同一款把戏,还藏在哪
COW 不是 fork 的专属。内核里凡是「语义要复制、物理想省」的场合,都是它的舞台,各举一例:
mmap 的 MAP_PRIVATE。 私有文件映射:读时共享同一份文件页,一写就复制出私有副本——改的是自己的影子,原文件毫发无伤。动态链接器映射 so 库用的就是这条路。
fork + exec 的空忙。 shell 执行一条命令,fork 出子进程后立刻 exec 加载新程序——刚铺好的页表、埋好的只读雷全部作废。所以有了 vfork(共享父进程地址空间,干脆不做那套复制)和 posix_spawn(把 fork + exec 合成一个更省的调用)。fork 后必 exec 的场景直接用 posix_spawn,这个建议在《缺页的两种价格:Linux 的 Major Fault 与 Minor Fault》里也出现过。
Redis 的 BGSAVE。 主进程 fork 一个子进程去落盘 RDB 快照:子进程从 fork 那一刻看到的是冻结的世界,主进程继续服务不中断,几 GB 数据「秒级定影」靠的就是 fork 只复制页表这一手。代价是那之后两边各写各的、各自触发各自的 COW——落盘期间主进程写入越多,内存涨得越快,这笔账迟早要还。
结语:先合住,谁动笔谁搬新家
回到开头那 6 毫秒。fork 之所以便宜,是因为它把「复制」从动作降级成了承诺;COW 的高明,不在于复制得多快,而在于让大多数复制永远不必发生——父子进程各写各的页,从一开始就不是对方的页。
下次在内存报表里看到两个进程各占几 GB,不妨会心一笑:那是记账口径的幻觉,物理内存只有一份。哪天用 smaps_rollup 拆开这层幻觉,看到 Private_Dirty 那列小小的数字,你就看到了内核这本「先合住、后买单」的账本。而 Android 那边,zygote 把整套框架合租给几百个 App,省下的是几百份复制;被写热的页终究要各付各的,内存真紧了,得有人决定请谁离场——《谁在悄悄杀你手机里的 App:Android 的 lmkd》讲的就是这套请客离场的算法。
参考资料:
Linux 内核源码(v6.12):kernel/fork.c(dup_mmap)、mm/memory.c(__copy_present_ptes、do_wp_page、wp_page_copy) fork(2) man page;proc(5) man page(smaps_rollup 各字段) Robert Love,《Linux Kernel Development》第 3 章 Process Management;Android 开源项目(AOSP)文档:Zygote 进程说明 本号前作:《一次缺页,装下一片:深入理解 Linux 内核的 Fault Around 机制》、《谁在替你回收内存:深入理解 Linux 内核的 kswapd》;《缺页的两种价格:Linux 的 Major Fault 与 Minor Fault》(发表后补挂链接)