ARTICLE · 1121964
AI 让交付变快,也让线上变脆:门禁和监控要补哪几道
"
AI 是放大器——放大好团队的优势,也放大差团队的混乱。它交付的每一分速度背后,都有一张寄给质量保障的账单。这篇讲怎么付,别等到线上再付。
—— 不是Bug是Feature
本文看点
01
一、一组反直觉的数据
02
二、AI 为什么会放大不稳定
03
四、第二道门:灰度与回退,给失败留退路
DATA
一、一组反直觉的数据
先看一个大型行业调研的结果。
Google Cloud 的 DORA 团队 2025 年 9 月发布《AI 辅助软件开发现状》报告,调研了近五千名技术从业者。三个数字放在一起看,非常有意思:
90% 的人在工作中使用 AI——采用已近普及
80% 以上认为 AI 提升了自己的生产力——体感是正面的
但 AI 采用率与软件交付不稳定性呈正相关——用得越多,交付越不稳
注意最后一个发现的方向:不是某个团队体感不好,是行业级数据里,吞吐量和不稳定性一起在涨。
更扎心的是 DORA 专门检验过一种常见的乐观假设:「失败得快,修复得也快,不稳一点没关系」。数据分析没有找到支持——更快的失败速度并没有通过更快修复补回质量。速度带来的不稳定,靠速度自己是还不上的。
DORA 给这些发现起的总结论只有四个字:AI 是放大器。 它放大高绩效组织的优势,也放大混乱组织的短板——流程糙、平台弱的团队,用 AI 只是更快地生产技术债。
这篇要回答的问题就由此而来:既然行业数据显示“提速的代价落在质量侧”,那质量保障这一侧要补哪几道,才能把账付掉、把风险拦住?
— 一边越堆越高,一边越来越散:速度与稳定的天平
WHY
二、AI 为什么会放大不稳定
先把机制说透,补丁才知道往哪打。三个机制:
机制一:产出速度超过验证速度。 上一幕反复说过:AI 省下的编写时间被重新分配到审计与验证上。如果验证环节没有跟上产能——人还是那些人,门禁还是那些门禁——变更就会带着未充分验证的风险涌向线上。不稳定性上升,本质是验证带宽被击穿。
机制二:变更面在扩大。 AI 让“顺手改一下”的成本趋近于零,单次变更的代码量和变更频次同时上升。变更越多,出错的机会越多,而且互相纠缠——这条也是不稳定性上升的直接来源。
机制三:信任缺口。 同一份 DORA 报告里,对 AI 输出高度信任的开发者只有约 4%。一边大量使用、一边几乎不信,这种拧巴的状态意味着大量代码在“半信半疑”中被合入——没有充分的验证,也没有充分的拒绝。
三个机制指向同一个结论:补丁不在 AI 那头,在质量保障这头。 具体就是两道:上线前的门禁,上线后的监控。## 三、第一道门:上线前,把前面的闭环拧成一股 | GATE1
好消息是,前几篇的工作在这里全部汇合了。前面单独看是几个方法,合起来就是一道门禁:
— 闸门不是墙:放行该放的,拦下该拦的
红线层(08 篇):资金、权限、不可逆操作,无条件全审全测——这一层不打分、不商量
清单层(05 篇):AI 产出先过 12 项校验清单,编造、跳步、断言缺失在最低成本处被抓住
抽检层(07 篇):按风险分档抽检,命中率超标整批回退,连批命中回改提示词
指标层(09 篇):新增代码覆盖率门槛 + 关键路径变异抽查,拦住“高覆盖、弱断言”
这四层叠起来,门禁就有了一个重要性质:它拦的不是“慢”,是“未验证”。 已验证的变更走快速通道,未验证的才被扣下来。这也是对 DORA 那个发现的正确回应——不是把 AI 拖慢,是让验证带宽跟上产能。
给 AI 辅助的变更再加一条建议:评审加严一档。 行业调研的普遍建议是 AI 生成的代码需要更严格的评审,落到测试这边就是:AI 辅助产生的变更,进灰度的标准更严、抽检比例更高(07 篇的转移规则直接适用)。
GATE2
四、第二道门:灰度与回退,给失败留退路
DORA 那个“快速失败补不回来”的发现还有下半句要读:失败本身不可怕,可怕的是发现得晚、回退得慢。数据补不回来,是因为多数团队的发现和回退不够快——那要补的就是这两段。
发现要快:灰度发布。 不要把 AI 参与的变更直接全量推给所有用户。按 1% → 10% → 全量的节奏放量,每个阶段观察信号再决定下一步。出问题的时候,受影响的只是一个可承受的小群体。
止损要快:回退预案。 每次变更上线前必须先回答一个问题:出了事怎么退?回退按钮在哪、要几分钟、数据要不要兼容。答不上来的变更不配上灰度。AI 时代变更频次高,这个问题比以前更要先答——回退预案是变更的保险丝,没有保险丝的电器不插电。
隔离要早:特性开关。 新功能用开关包着上线,出事一键关闭,不用回滚部署。对 AI 功能尤其重要——AI 输出质量问题多,开关能让你把“功能下线”和“代码回滚”这两件事分开处理。
SIGNALS
五、上线后:四个信号判断「真的没事」
门禁拦得住已知风险,拦不住未知风险——所以上线不是终点,是观察期的开始。四个信号,按顺序看:
信号一:技术信号。 错误率、延迟、资源占用。这是最基础的一层,AI 参与的变更里,最常见的线上表现就是某些长尾输入触发的错误率毛刺。
信号二:业务信号。 下单转化、支付成功率、关键流程的完成率。技术指标全绿但业务指标掉头,往往意味着“功能没坏,但体验坏了”——这类问题用户会说,监控不一定会响。
信号三:变更关联。 每条告警必须能回答“和最近哪次变更有关”。AI 时代变更频次翻倍,没有变更关联的告警就是噪音——你会习惯性忽略它,直到出大事。
信号四:用户反馈。 客服工单、应用商店评论里和本次变更相关的关键词。它是四个信号里最慢的,但经常是最早发现“ AI 输出让用户觉得怪”的渠道。
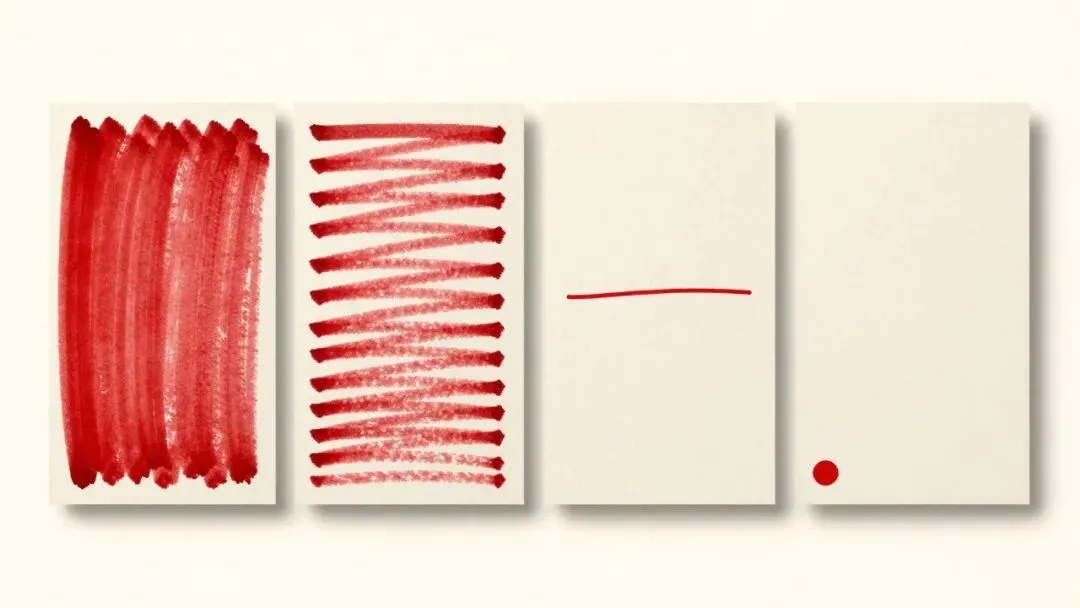
— 从技术到用户:四层信号逐级往外看
BUDGET
六、错误预算:给「多可靠才算够」定价
四个信号怎么看才不是天天救火?Google SRE 体系给过一个答案:错误预算。
逻辑是这样的:100% 可靠是不可能也不必要的——为了最后那一点可靠性,你会慢到失去竞争力。所以先和业务方谈定一个服务等级目标(SLO),比如“季度内 99.9% 的请求正常”——这个目标的另一面就是预算:0.1% 的失败额度,就是你这个季度可以花的“不可靠预算”。
预算是花销,也是阀门:
预算还充裕 → 正常发布,包括激进的 AI 变更
预算烧过半 → 收紧门禁,减少非必要变更
预算烧完 → 暂停发布,全员优先修稳定性,直到预算回血
这套机制对 AI 时代有一个特别契合的性质:AI 提速等于变更变多,变更变多等于烧预算变快——错误预算天然就是 AI 提速的调节阀。 提速带来的不稳定不再需要靠吵来解决,看预算表就行:预算还多,尽管跑;预算见底,自动刹车。
这也是把 DORA 那组数据落成制度的方式:既然数据说提速和不稳定正相关,那就给不稳定定价、限额、设闸门——让它变成一个可管理的变量,而不是一场争论。
TAKEAWAY
七、一张卡带走
数据先摆正:90% 采用、80%+ 认为提效、4% 高度信任;吞吐量与不稳定性一起在涨,“快速失败”补不回来
三个机制:验证带宽被击穿、变更面扩大、半信半疑地合入——补丁全在质量侧
门禁是闭环:红线、清单、抽检、指标四层合体,拦“未验证”不拦“快”
灰度回退:放量有节奏、回退有预案、功能有开关——给每次失败留退路
四个信号:技术、业务、变更关联、用户反馈,上线后逐级往外看
错误预算:给不可靠定价限额,预算表就是 AI 提速的刹车片
到这里,「判断」这一幕收尾:测什么、测多深、能不能发都有了答案。下一篇进入最后一幕「测 AI」——被测对象从代码换成 AI 本身:没有标准答案的时候,测试的断言怎么写、评测集怎么搭。那一篇会从零搭一个可直接照抄的评测集模板。
我是 不是Bug是Feature,八年测试老兵,专注 AI 质量工程。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。