ARTICLE · 1128546
乳腺超声AI给出参考病例,也带来了新的核对工作
知影 · 医疗设备决策研究 医疗产业解读
B-RAD提供了可核对的相似病例,也让诊断证据的来源与人工核对的代价变得更重要。
如果AI给出一个BI-RADS类别,同时展示它找到的相似图像、关注的病灶和判断理由,医生就多了一条核对路径。
这个变化有吸引力:接受或推翻AI时,可以指向具体证据,而不只是面对一个分数。问题也随之出现:这些证据靠什么取得可信度,核对之后改变的决策又是否更好?
10月3日,npj Digital Medicine上线已接收、尚待最终编辑的B-RAD乳腺超声研究。
[1] 理解它的临床价值,要把两件事分清:模型能否复现专家的分级判断,以及医生借助它后,是否更妥当地处理了有病与无病的病例。
论文分别提供了线索,不能拼成一个笼统的“准确率提升”。
0.952这张答卷,参照的是谁
独立机构队列包含289例,83.7%属于BI-RADS 4–5。
文中0.952的AUROC对应专家分级的2/3与4/5分流,不能读成以病理恶性为结局的AUC;另一个BUS-CoT外部队列的同项AUC为0.799。[1]
复现专家分级本身可以有价值,尤其是在评估一致性时。但它回答的是“系统如何接近这套判读参照”。
如果要进一步回答哪些患者能避免延误、哪些良性病例可能承受额外检查,就必须换到能够核验这些后果的证据上。参照标准发生变化,指标的临床含义也跟着变化。
另一项100例读者实验,包含35例恶性与65例良性。其四分类准确率仍参照专家BI-RADS,而活检阈值相关的敏感度、特异度等指标才按病理评价。
[1] 这是更贴近决策的一张答卷,但仍是读者实验;它没有直接观察这些建议在真实就诊路径中带来的长期结果。
因此,机构队列不能被悄悄改写成普通筛查人群,读者实验也不能被扩写成已经减少实际漏诊。两组证据合在一起的正确用途,是指出下一步该在哪种病例和哪种决策上试验。
只保留最高AUC,会把这个有用的信息丢掉。
相似病例把黑箱拆开,也可能把错误串起来
B-RAD把检索、定位和分类连起来,利用参考图帮助后续判断;目前处理的是静态二维超声图。
[1] 从使用者角度看,这种设计的潜在价值是让人看见中间环节,从而有机会发现“参考错了”或“看错位置了”。
不过,可见的证据也会影响注意力。如果参考图足够相似,医生可能更容易忽略当前病例中恰好不同、却决定风险的特征;如果初始定位有偏差,后续解释可以围绕错误区域保持连贯。
解释连贯只能说明几个步骤彼此接得上,不能保证第一步就选对了对象。
真正有用的解释,应帮助读者指出差异,而不只是确认相似。核对时值得问的是:当前病灶在哪个关键特征上不符合参考病例,模型又如何处理这个差异?
当系统无法说明时,保留“不适用”应当比努力挑出一张最相似的图更重要。这是对交互设计的评价要求,尚不能当作本研究已经验证的机制。
静态图任务还有一道边界:读者可以检查已有图像,却不能凭参考病例补回采集时没有留下的信息。
把此类工具试用于阅片支持,与用它指导完整超声检查,是不同的应用问题,后者需要自己的证据。
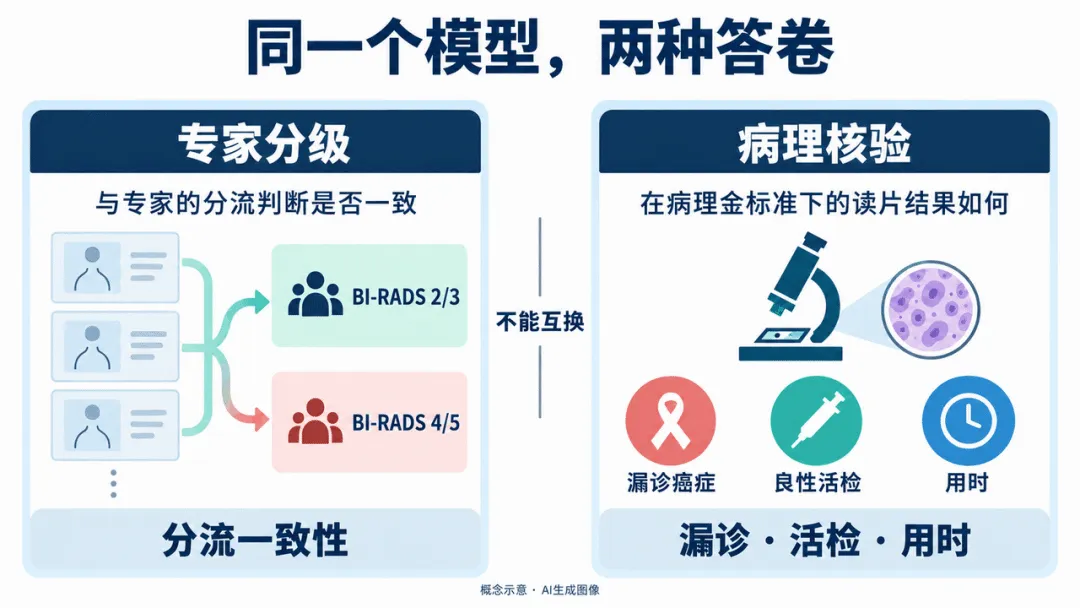
模型接近专家分级,与医生改善病理核验下的决策,是不同的评价问题。图为概念示意。右侧指离线读者实验中的漏判与活检建议,不代表已发生的临床操作或患者获益。
少漏判一些恶性病例,代价由哪一边承担
B-RAD辅助后,四位读者在实验中未建议活检的恶性病例比例均下降;但三位非住培读者把良性病例判为应活检的比例上升,住培读者则下降。四分类准确率的改善只有三位达到统计显著。
[1]
这个分歧很重要。人机协作的结果不能仅用模型能力概括,也取决于原来的读者习惯:有人可能变得更愿意提高警惕,有人可能借参考图纠正原先过于谨慎的判断。
相同界面落到不同使用者手中,未必形成相同的决策代价。
临床价值的判断还需要给不同错误赋予不同权重。决策曲线分析的原始方法研究,正是把假阳性与假阴性的相对后果纳入评价,而不是让AUC独自决定一个模型值不值得用。
[2] 这里引用的是评价原则,B-RAD本研究并没有因此自动获得一个适用于本地患者的净获益结论。
少漏判恶性病例值得重视,良性活检也需要认真对待。两者之间愿意接受多大交换,应结合适用人群、实际后续处置及患者价值取向来讨论。
若只是把增加的活检一概称为“可接受的小代价”,就把最需要证明的临床判断提前做完了。
多花的核对时间,究竟买到了什么
在这项静态病例任务中,B-RAD辅助读片时间为18.0–37.0秒,未辅助时为4.0–7.2秒。
[1] 这些数值不能直接套成完整超声检查的周转时间,却清楚提醒我们:解释需要人来读,参考图需要人来比较。
多花时间未必是坏结果。遇到决策困难的病例,如果更充分核对确实减少错误,它可以是一种合理投入。
问题在于,这笔投入的收益是否来自系统提供的信息,还是主要来自读者获得了更长的重新思考机会。两种解释指向不同的部署选择。
后一种解释应被认真检验。一个有说服力的对照,可以让读者在相近时间内完成结构化复核,或者提供同等数量、但采用不同选择方式的参考材料,再观察B-RAD的增益还剩多少。
阅读顺序、重复见到病例产生的学习、哪些错误建议被接受,也都需要核清。这里提出的是后续研究问题,并非声称这些因素已经解释了论文结果。
任务专门化也是另一个解释。原文的完整流程与通用医学多模态模型并非只有“有没有检索”这一处差别。
[1] 若把整个差距都归功于参考病例,就会跳过训练目标、定位方式和界面等共同变化。要判断哪部分值得医院付出核对时间,应尽量比较一次只改变一个关键环节的方案。
把可解释性做成可追溯的临床试验
对准备试用的科室,值得先确定一个有限问题:哪些现有决策最需要帮助?例如,可以研究它是否有助于处理原本分歧较大的病例,而不是默认让每一例都增加同样的核对步骤。
这样的选择性应用仍是待验证设想,不能借本研究直接宣布有效。
评价记录需要保留AI介入前后的判断与理由。原先正确、后来被带错的病例,和原先错误、后来被纠正的病例,都应进入分析;只记录最终一致率,看不见人机之间错误的流向。
病理或随访结局、良性病例接受侵入性检查的比例,以及人工复核负担,也应沿完整路径观察。
DECIDE-AI强调,早期真实临床评价应交代系统、使用者和实施环境的相互作用,以及安全与人因问题。
[3] 它是报告规范,不是“照着填完就能证明有效”的认证,也不能把离线读者实验变成真实临床验证。对这类可解释系统,解释被谁看、如何被采纳,恰好就是干预的一部分。
如果后续连续病例研究显示,在明确适用人群中,读者确实能利用参考证据纠正错误,同时把额外检查与核对成本控制在可接受范围,B-RAD就有理由向更广的使用范围推进。
若它主要增加了信心,却没有改善决策后果,界面再透明也需要重新设计。把参考病例摆出来,是让判断更可核查的开始;完成这次核查,才轮到讨论临床收益。
资料来源与说明
[1] Jang等:B-RAD乳腺超声检索增强诊断与读者研究,B-RAD乳腺超声研究,2026-10-03:队列、表3–4及表7,区分分流性能与决策代价;离线静态图;不等于患者获益
[2] Vickers与Elkin:决策曲线分析原始方法研究,决策曲线分析原始研究,发布日期未核或未标注(2026-10-05读取):引言、理论与讨论,说明错误后果的权衡;方法背景,未计算B-RAD净收益
[3] DECIDE-AI:AI决策支持早期真实临床评价报告规范,DECIDE-AI报告规范,2022-05-18:主文、建议与讨论,界定真实临床评价要求;报告规范,不是方法学认证
AI辅助整理与写作。