ARTICLE · 1163820
Notion悄悄取消了整站PDF导出,你的数据真的带得走吗?
Notion悄悄取消了整站PDF导出,你的数据真的带得走吗?
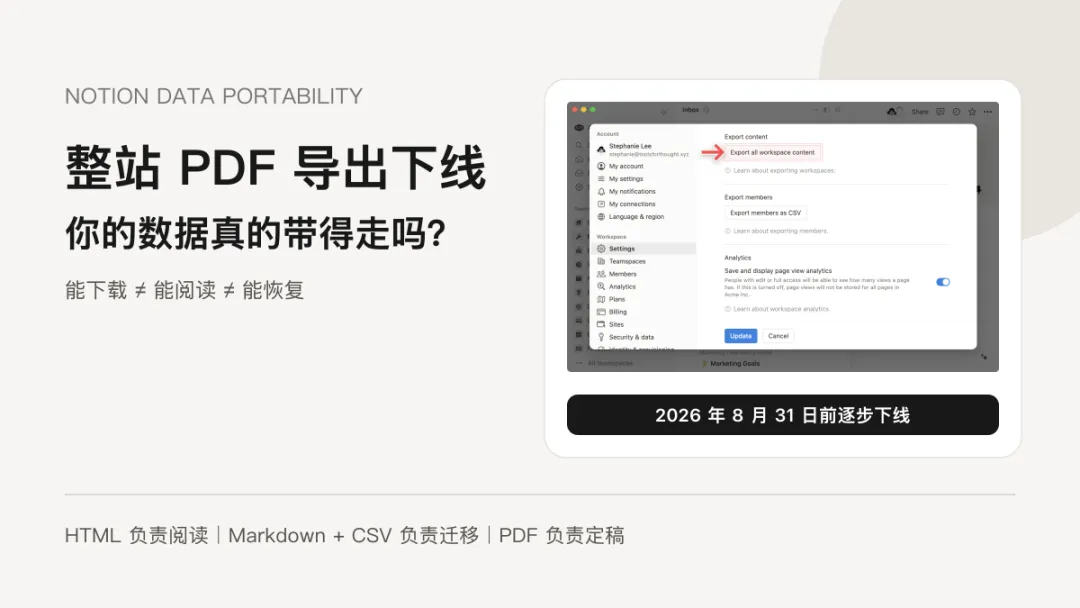
Notion 最近在帮助中心里放了一句很容易被忽略的说明:整个工作区导出为 PDF 的选项正在取消,并已在 2026 年 8 月 31 日前逐步下线。
受影响的是过去提供给 Business 和 Enterprise 工作区的批量 PDF 导出。单个页面依然可以导出 PDF;整个工作区也仍然可以导出为 HTML,或 Markdown 与 CSV。
所以,这不是“Notion 不让你导出数据了”。
真正值得警惕的是另一件事:很多人把“我下载到了一个压缩包”,误认为“我已经有了一份可以随时恢复的备份”。
这两件事差得很远。
这次到底取消了什么
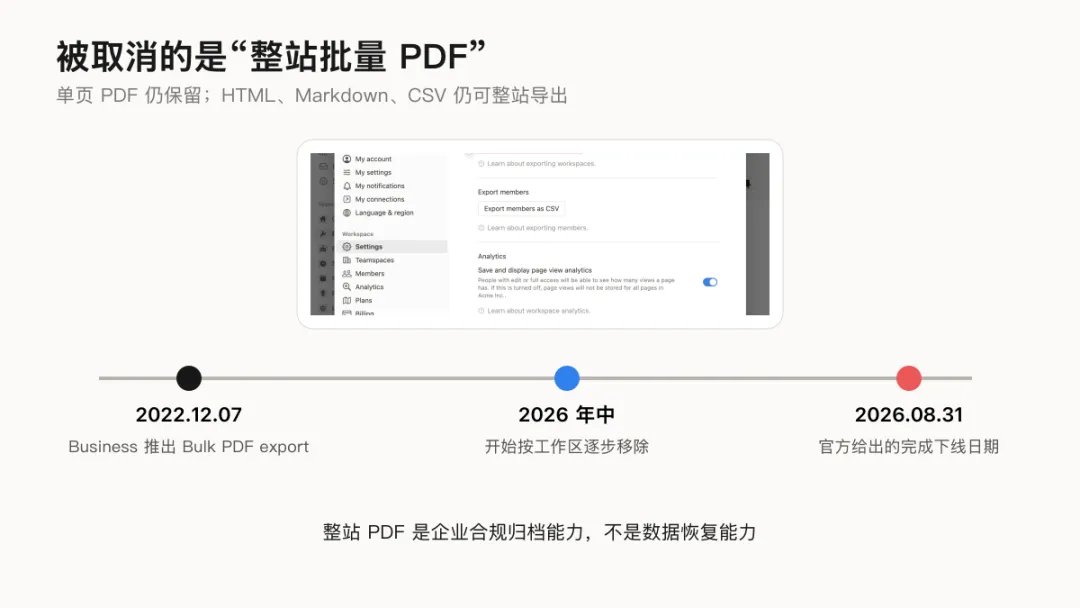
Notion 在 2022 年推出 Business 套餐时,把 Bulk PDF export 当作面向企业法务与合规场景的能力。过去,Business 和 Enterprise 用户可以把整个工作区批量导出成一组 PDF。
现在下线的是这条整站路径,不是所有 PDF 能力。
截至 2026 年 9 月,仍然保留的能力是:
• 单个页面或数据库可以导出 PDF; • Business 和 Enterprise 仍可在单页导出时开启 Include subpages,将该页面下面的子页面分别生成 PDF;• 整个工作区仍可导出 HTML; • 整个工作区仍可导出 Markdown,数据库则导出为 CSV; • 上传过的图片和附件会随工作区导出包一起下载。
区别在于,Include subpages 是从某个页面向下导出,并不等于管理员一键取得整个工作区的 PDF 副本。私有页面、没有访问权限的页面,以及被 Teamspace 设置限制的内容,依然可能不在导出包里。
⚠️ 导出成功,只能证明导出者有权看到的内容被打包了,不能证明整个工作区已经完整备份。
能下载、能阅读、能恢复,是三件事
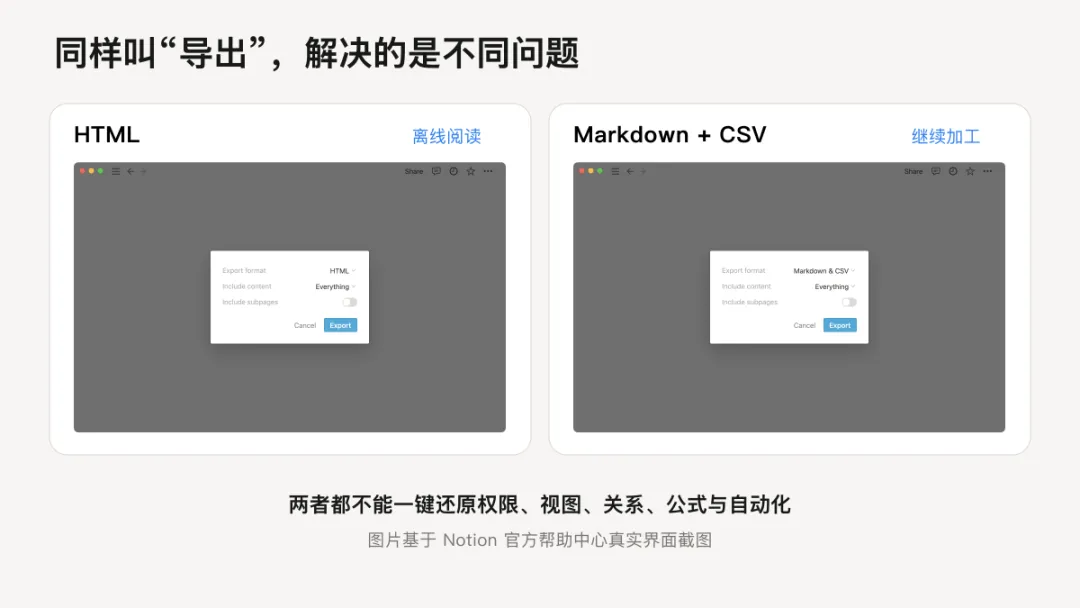
PDF解决的是“以后还能看”
PDF 适合归档定稿、合同、制度文件和审计材料。版面相对稳定,也方便交给不使用 Notion 的人阅读。
但 PDF 几乎保不住 Notion 的可编辑结构。数据库会变成静态页面,筛选、公式、关联、自动化和权限都不会跟着回来。即使把 PDF 再导入 Notion,官方也明确提醒:表格可能只会变成简单表格,标题、公式、引用、待办和 Callout 等内容可能降级为普通文本。
HTML解决的是“离开Notion也能浏览”
HTML 导出会保留页面文件、图片和附件,并附带一个 index.html 站点地图。解压后,可以顺着本地链接浏览页面层级。
它更像一份可离线打开的网站快照。HTML 还能包含页面级和块级评论,包括已经解决的评论。
但复杂布局、嵌入内容、脚本、权限和编辑历史,重新导入时都可能丢失或被压平。它适合查资料,不是工作区镜像。
Markdown与CSV解决的是“内容还能继续加工”
普通页面会变成 Markdown,整页数据库会变成 CSV,数据库里的子页面则另存为 Markdown。文本容易搜索、迁移和批量处理,CSV 也能在 Excel 或其他数据库工具中打开。
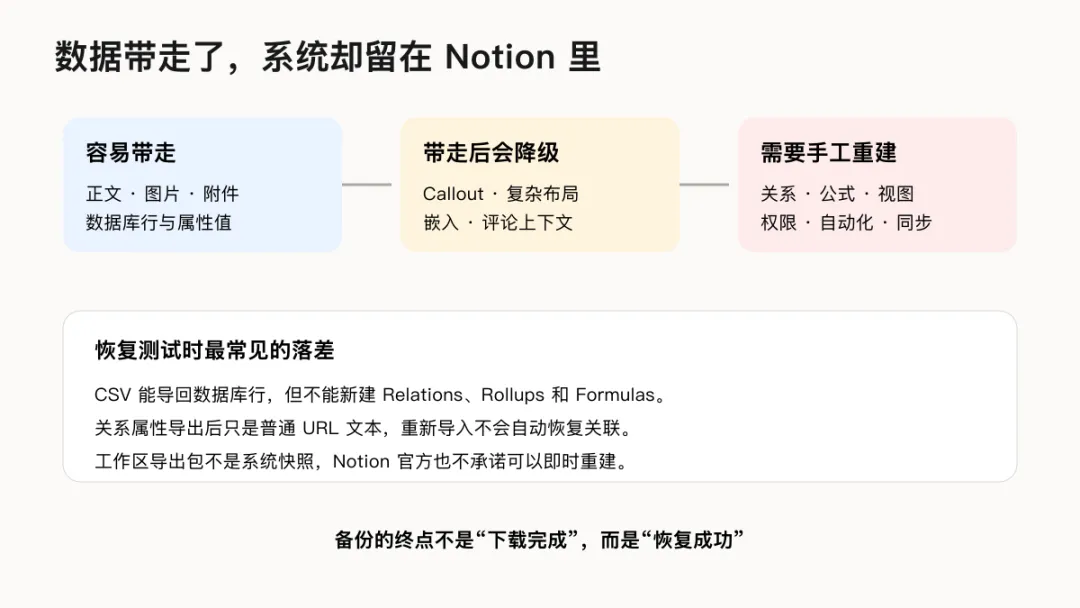
代价是 Notion 独有的结构会被拆开。Callout 因为没有对应的标准 Markdown 语法,会被导出为 HTML。关系属性会退化为普通 URL 文本;重新导入 CSV 时,不能自动重建 Relations、Rollups 和 Formulas。
你拿回了数据,却没有拿回让这些数据协同运转的系统。
哪些东西最难原样带走
如果你的 Notion 只是文章和读书笔记,迁移问题通常不大。
真正麻烦的是已经把 Notion 当成业务系统的人。以下内容即使能在导出文件中留下痕迹,也很难一键恢复成原来的工作状态:
• 数据库的多个视图、筛选、排序与分组;导出数据库时只能选择当前视图或默认视图,不能一次导出全部视图; • Relations、Rollups、Formulas 及它们之间的依赖关系; • 自动化、按钮、表单入口和外部集成; • 页面、Teamspace、成员和访客之间的权限结构; • 评论之外的编辑历史、页面历史与完整审计上下文; • Synced Blocks 的同步关系; • 部分嵌入内容、第三方小组件和复杂版式; • 私人页面,以及导出者本来就没有权限访问的内容。
Notion 自己也在备份说明中写得很直白:不能通过重新上传工作区导出文件,立即重建原来的工作区。
这句话比“整站 PDF 下线”更值得记住。
我更建议做三层备份
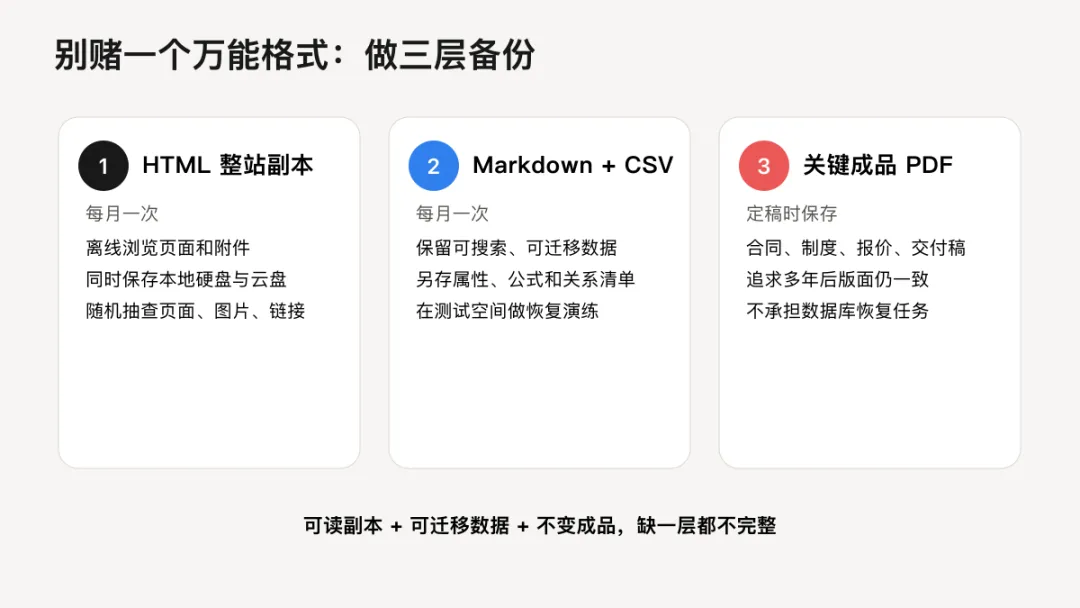
不要寻找一个万能格式。按照内容的用途,保留三层副本更实际。
第一层:每月做一次整站可读备份
在桌面端或 Web 端进入 Settings → General → Export all workspace content,选择 HTML,下载完整压缩包。
HTML 用来解决“Notion 暂时打不开时,我还能查到资料”。下载链接只有 7 天有效期,收到邮件后不要继续放在收件箱里,立刻保存到本地硬盘和另一处云盘。
大型工作区可能导出失败。官方给出的临时办法是,从各个重要的顶层页面分别导出,开启 Include subpages,分批完成。
第二层:每月保留一份可迁移数据
再导出一次 Markdown 与 CSV。
Markdown 保正文,CSV 保数据库记录。解压后随机检查几篇长文、几个数据库和附件,不要只看到 ZIP 文件存在就算完成。
对于核心数据库,另外保存一份结构清单:每个属性的类型、公式原文、关联到哪个数据库、有哪些视图和筛选条件。它可以是一张简单的表,却是将来重建系统时最值钱的说明书。
第三层:关键成品单独冻结
合同、制度、报价、交付稿和已经确认的项目方案,继续逐页导出 PDF。它们需要的是“多年后打开仍与定稿一致”,不承担恢复数据库的任务。
核心业务工作区还应保留成员、权限和自动化清单。Enterprise 团队如果需要固定周期执行导出,可以评估仍处于 Beta 的 Admin API 工作区导出能力,但它同样不等于可一键恢复的系统快照。
💡 HTML负责“还能看”,Markdown与CSV负责“还能搬”,PDF负责“定稿不变”。工作区结构、权限和自动化,则要靠单独的系统清单才能重建。
现在就做一次恢复演练
真正的备份,不是拥有一个文件,而是知道这个文件能救回什么。
今天可以挑一个不重要的测试空间:导出一个包含普通页面、数据库、Relation、Formula、评论和附件的小项目,再把 HTML、Markdown、CSV 分别导入空白空间。
你会很快看见边界:正文大多还在,附件大多能找到,数据库行也能回来;但视图、关系、公式、权限和工作流需要重新搭建。
这次整站 PDF 下线并没有堵住数据出口。它只是提醒了我们一个一直存在的事实:
Notion 允许你带走内容,但不会替你打包带走整个 Notion。