ARTICLE · 1184046
输出彻底免费!38万Token吞下整套源码,神秘AI一秒震撼硅谷:账单暴跌98%
作者小团圆
编辑快门
你的浏览器现在正开着多少个标签页?
10个?20个?还是密密麻麻挤成了几十个毫无意义的小圆点?
每一个现代人大概都经历过这种崩溃瞬间:论文查到一半、工作后台悬在半空、三个不同的 ChatGPT 窗口聊得昏天黑地,中间还夹杂着几个两周前打开、发誓“回头一定要看”的技术推文。风扇在狂转,内存被吃光,你想找一个五分钟前看过的文档,却在三十几个灰头土脸的小标签里迷路了。
科技博主 Hasan Toor 也被逼疯了。2026年10月12日下午,他盯着自己屏幕顶端整整 32 个挤成肉酱的 Chrome 标签页,火冒三丈。
但他没有像往常一样逐个去点关闭他点了一下自己刚随手写出的扩展插件 SnapTab。
点击 Analyze,本地服务瞬间扫过所有标题与网址;再点 Organize,
一秒钟整整 32 个失控的网页,像受过严苛训练的士兵一样,瞬间归入 Research、Dev、Entertainment 和 Work 四大彩色分组。
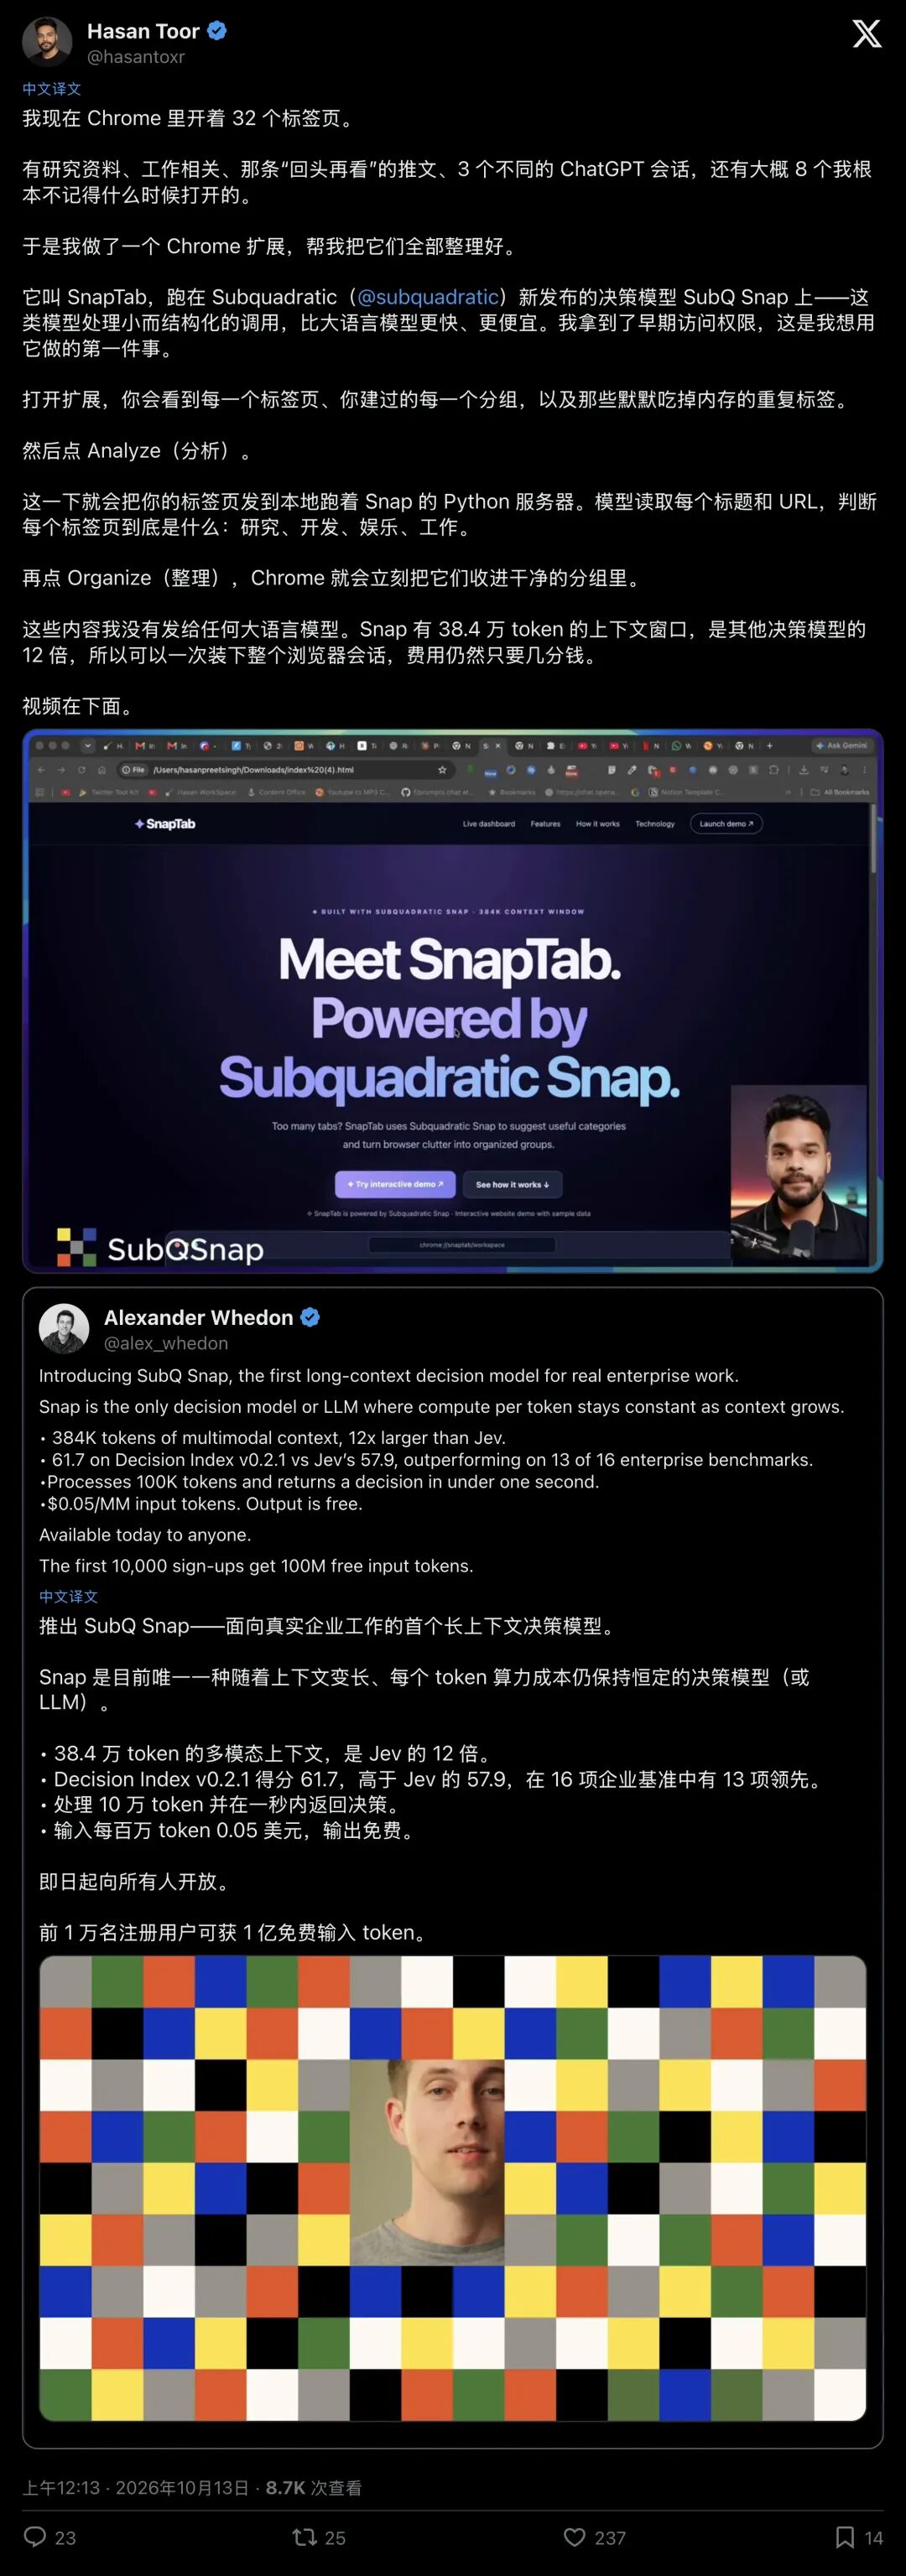
▲ Hasan Toor 演示用决策模型瞬间分类 32 个混乱标签页
尤其出人意料的是,Hasan 在推文里轻描淡写地补充了一个关键细节:
“我没有把它发给任何大语言模型,甚至连一分钱的生成费用都没花。”
一石激起千层浪短短几个小时,这篇演示在整个硅谷开发者社群中迅速激起热烈讨论。
这场混乱的幕后推手,是一家名为 Subquadratic 的基础模型公司在当天公开发布的全新产物,SubQ Snap。
它宣告了一个全新物种的降临:长上下文决策模型(Decision Model)。
01硅谷正在抛弃“大文豪”:为什么我们不再需要大模型写废话?
要读懂这场地震,我们必须先戳破过去两年生成式 AI 狂欢背后,一个荒诞却人尽皆知的秘密:
在无数极其简单的日常任务里,我们一直在用极其昂贵的大模型,干着最杀鸡用牛刀的蠢事。
想象一下这个场景:你开了一家跨国公司,花年薪百万聘请了一位博古通今、出口成章的文学博士。结果你每天把他派去大门口当保安,路过一个人就问他:“这位是推销员、访客,还是内部员工?”
文学博士不负众望他清了清嗓子,花了三秒钟酝酿情绪,洋洋洒洒给你写了一篇 300 字的辞赋,最后在末尾附上一句:“综上所述,该人员符合选项 A(访客)的特征。”
甚至,为了让自动化闸机能读懂他的话,你还得逼他用极其扭曲的口吻吐出一串格式严格的 JSON 字符串。一旦他哪天情绪波动少写了一个闭合括号,你的整个安防闸机当场死锁瘫痪。
这就是过去两年企业构建自主智能体(Agent)的荒唐日常。
大语言模型(LLM)的底层逻辑是“逐字自回归生成”。它生来就是写诗、写散文、长篇大论做开放式推理的。但现实世界中 80% 的软件控制流,根本不需要它写散文!
整理标签页,只需要回答“这属于 4 个类别里的哪一个”;客服系统分流,只需要在“退款、报修、人工”里挑一个;代码智能体执行到中途,只需要判断“下一跳调哪个 API”。
这些任务的共同特征是:选项清清楚楚,答案空间高度有界。
而新生的“决策模型”,彻底撕掉了大模型的伪装。
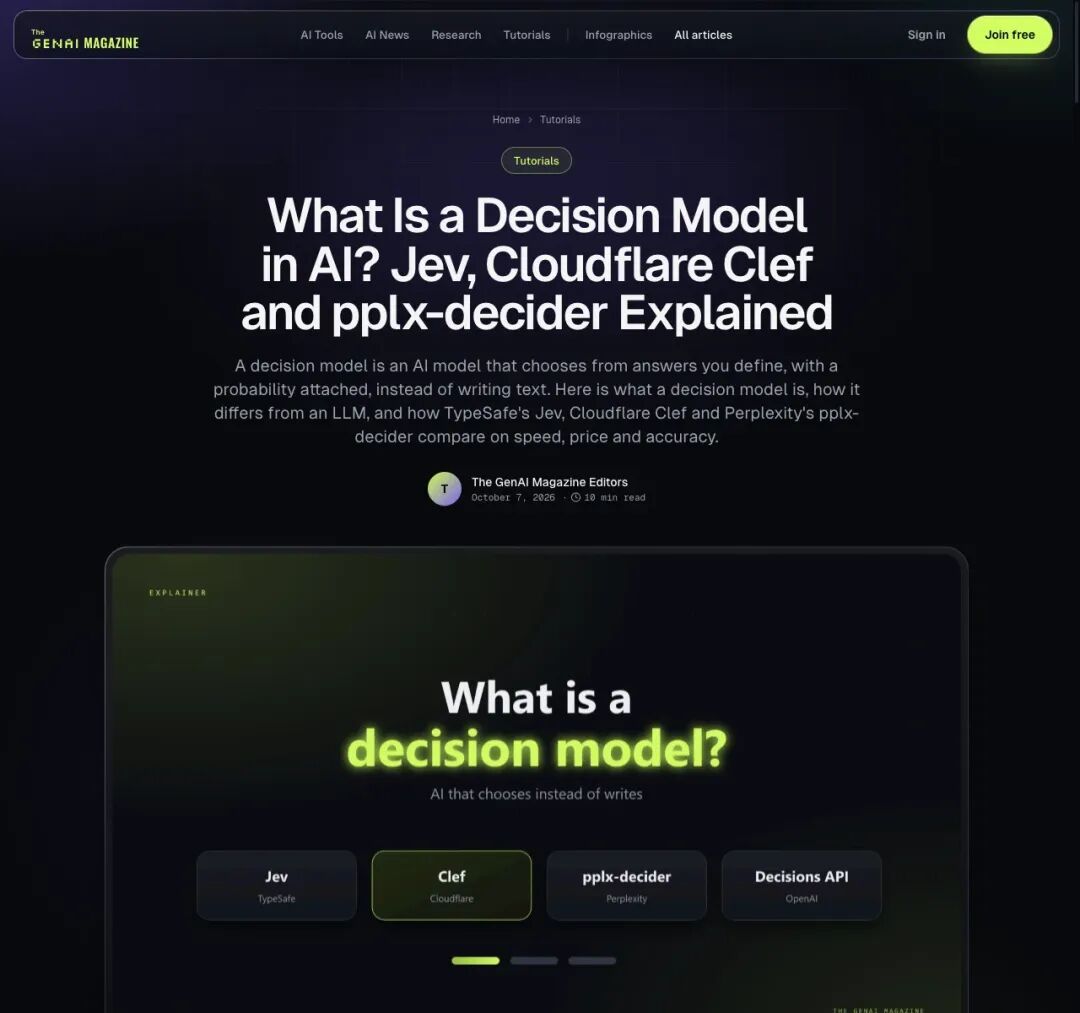
▲ 决策模型不生成长篇废话,直接输出带概率的结构化选项
它不写废话,不上演内心戏状态扔进去,预设选项列出来,模型直接对每个选项打分,返回一个纯净、精准的概率分布。
高置信度立刻自动执行,低置信度转交人工。完全省去了格式解析失败与胡言乱语的风险,也无需经历漫长的逐字吐词等待。
快、准、狠
0238.4万Token一秒吃透!它把大模型最致命的短板踏平了
既然决策模型这么好,为什么以前没能颠覆行业?
核心瓶颈显而易见:视野太窄
在 SubQ Snap 诞生之前,市面上的托管决策模型(例如此前备受关注的 Jev)最大上下文普遍卡在 3.2 万到 6.4 万 token。
而在真实的企业复杂场景里,决定一个微服务去向的线索,往往深埋在上万行的历史日志里;判断代码下一步该调哪个接口的证据,可能散落在整个庞大的代码仓库之中。
上下文一旦不够长,模型就像被蒙住眼睛的裁判,只能盲人摸象。但如果把传统大模型的上下文强行拉长,二次方注意力计算又会让成本和延迟指数级暴涨,原本为了省钱的轻量决策,瞬间变得比生成模型还要昂贵迟钝。
Subquadratic 联合创始人兼 CEO Alexander Whedon 拿出的全新架构,正是冲着这个关键死穴来的。
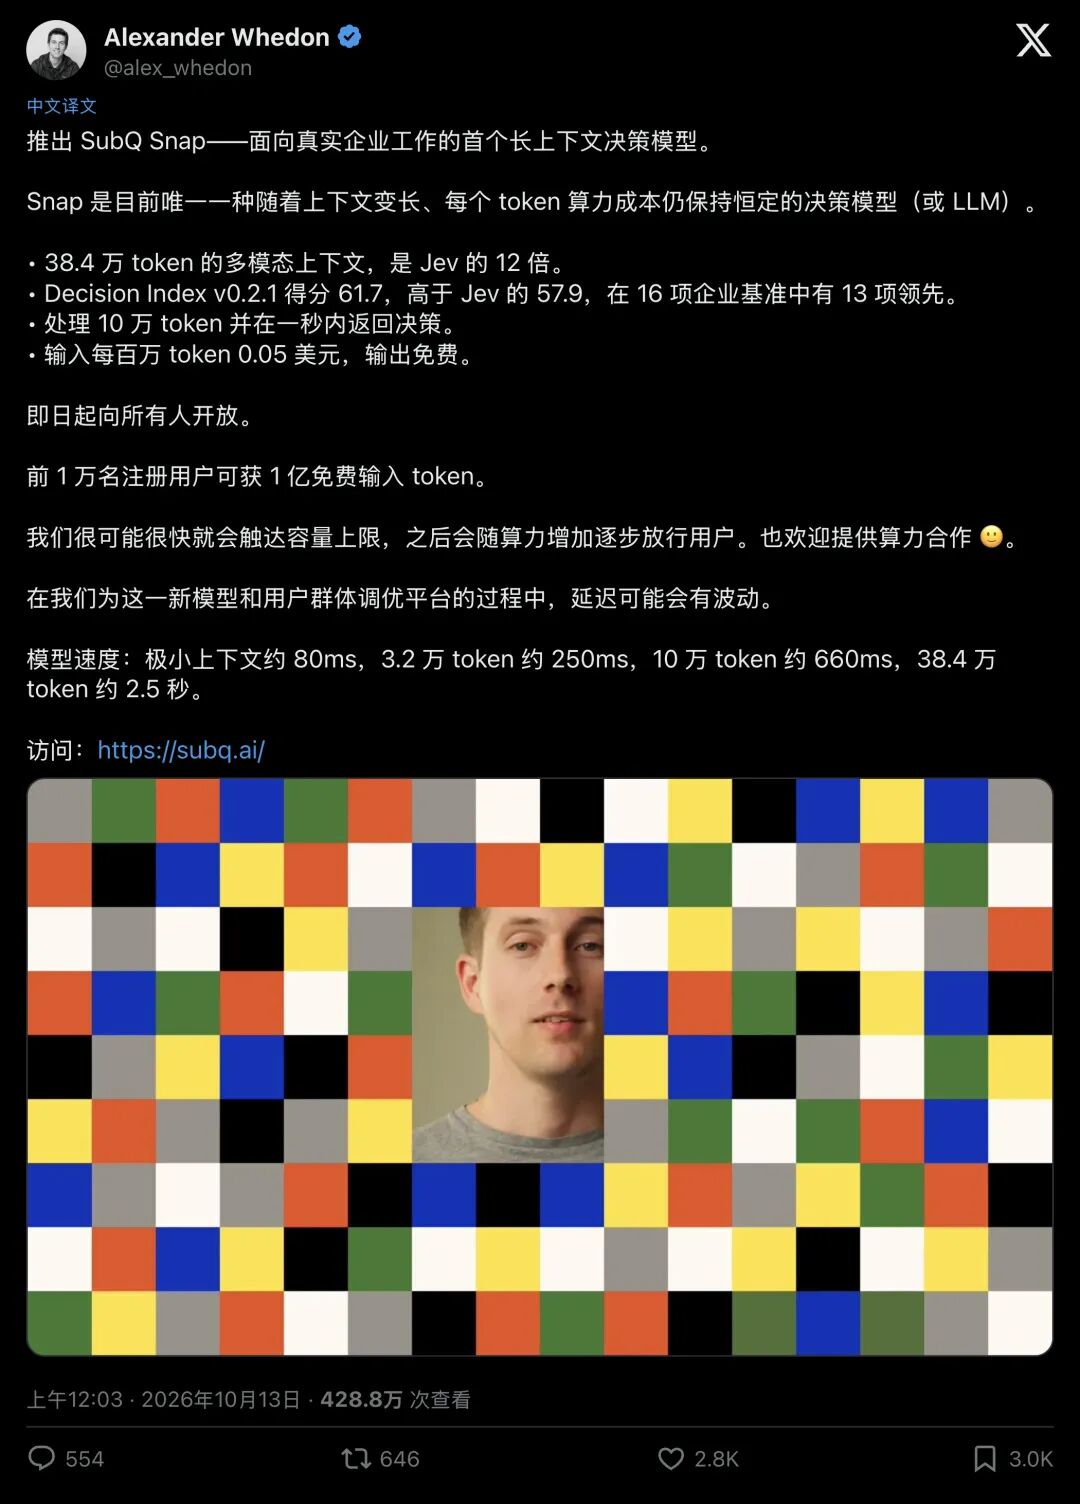
▲ Subquadratic 联合创始人兼 CEO Alexander Whedon 宣布 SubQ Snap 正式上线
Snap 交出了一份令人倒吸凉气的参数清单:
- 38.4 万(384K)多模态上下文
:直接把此前行业标杆 Jev 的窗口拉大了整整 12 倍; - 10 万 Token 决策压入 1 秒内
:极小上下文响应仅 80 毫秒,3.2 万 token 仅 250 毫秒,10 万 token 仅 660 毫秒; - 自研次二次方稀疏注意力(SSA)
:算力开销随上下文增长近似线性,彻底击碎传统注意力的二次方诅咒; - 颠覆性商业定价
:输入每百万 Token 仅 0.05 美元,输出完全免费! 前 1 万名注册用户直接赠送 1 亿免费输入 token。
每百万 Token 五分钱?输出还完全免费?
很多人第一反应是:这又是哪家厂商玩的花架子参数吧?
开发者 anish. 决定亲自用最残酷的现实场景狠狠砸向它。
他把一整本密密麻麻的超大 PDF,连同一整个完整的 GitHub 代码仓库,连皮带骨一共 17.1 万 Token 的超长数据,直接一巴掌甩给了 Snap。
数据未经任何切块(chunking)或前置摘要,长文档与工程源码原样保留。他要求 Snap 在这片代码与文献的汪洋大海中,直接决定前端界面下一秒该渲染成图表、地图还是任务清单。
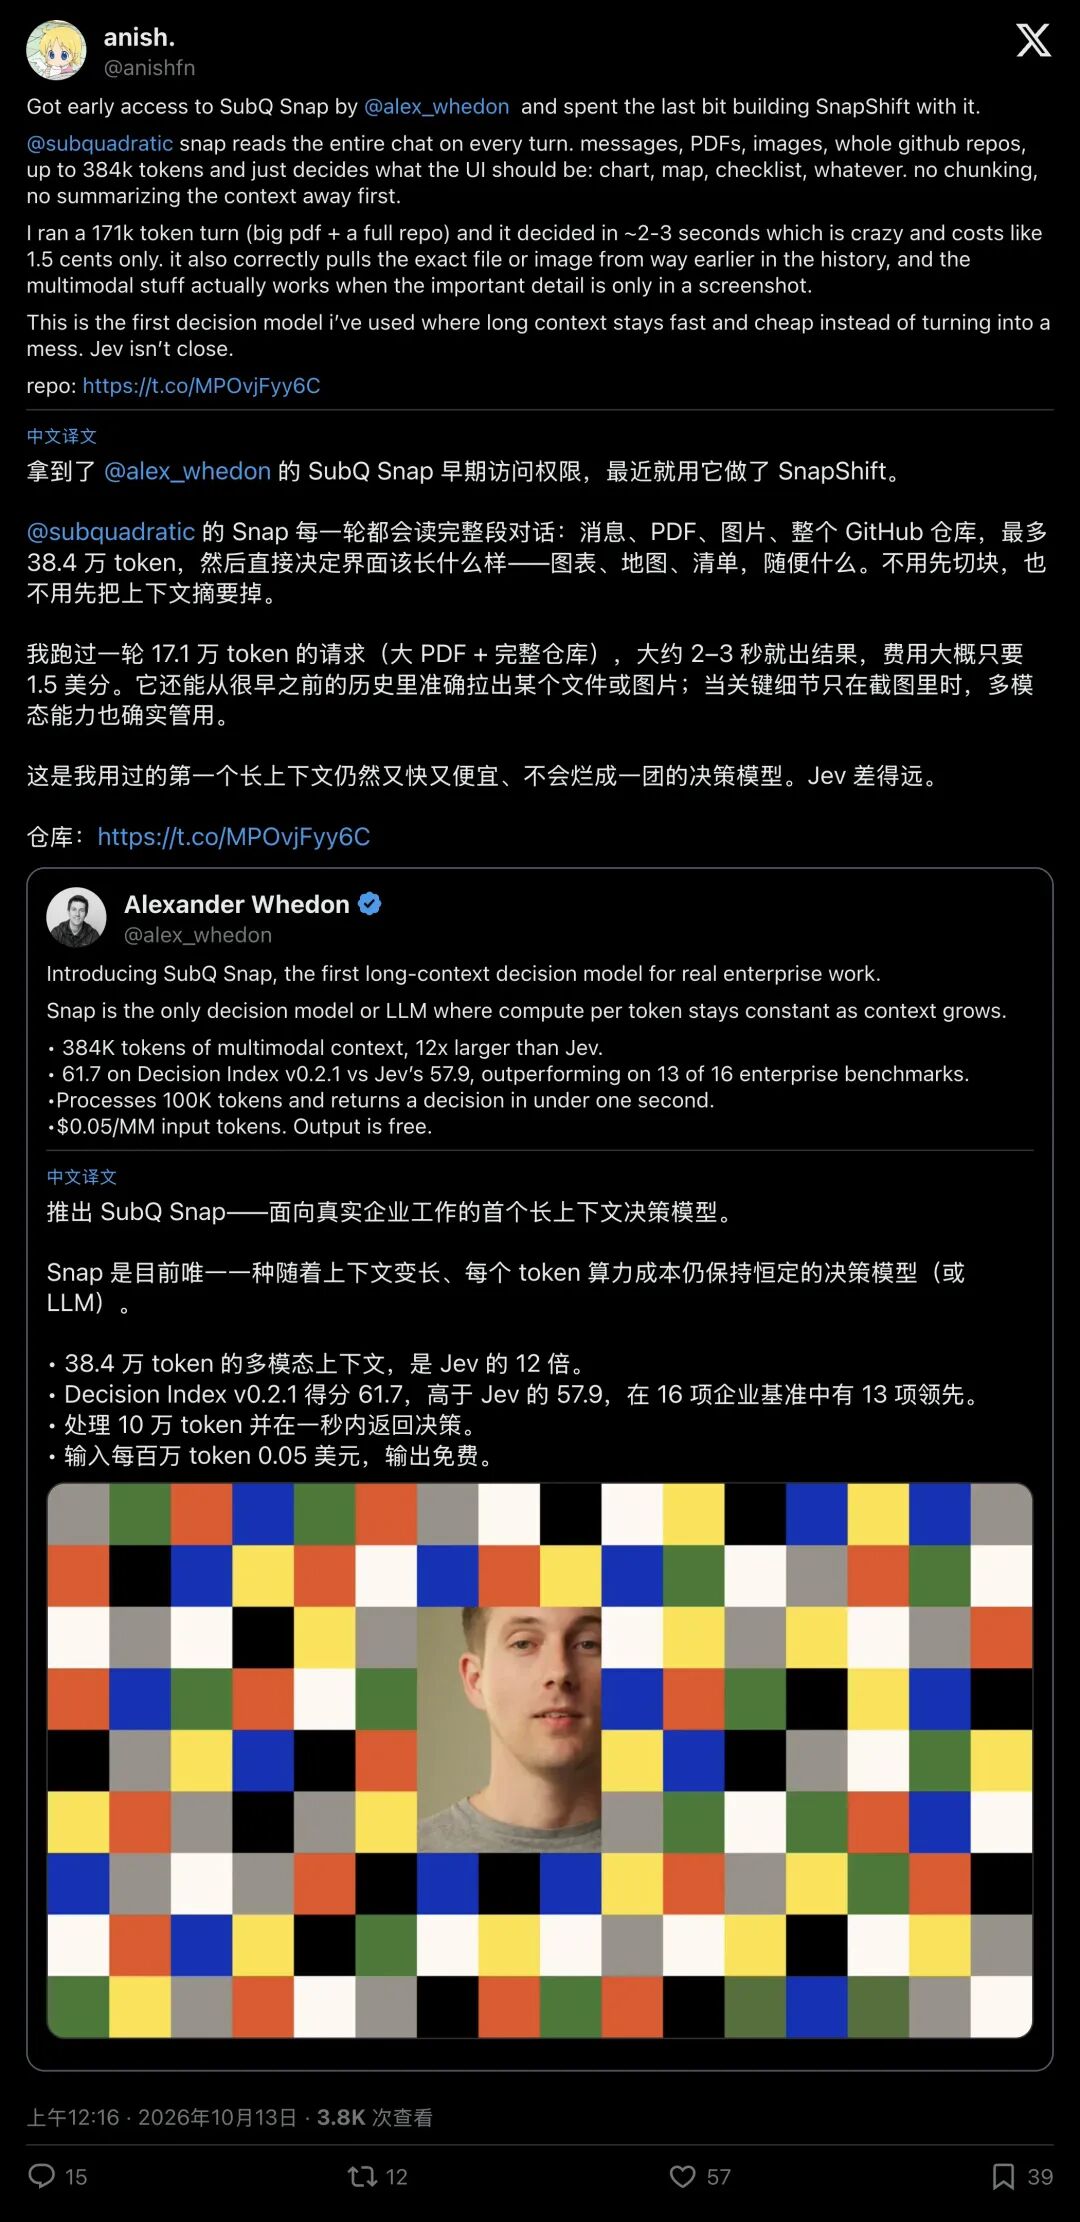
▲ 开发者 anish. 实测 17.1万 Token 极速决策,耗时仅 2-3 秒,花费仅 1.5 美分
结果震撼了整个技术圈:
整整 17.1 万 Token,Snap 只用了 2 到 3 秒就给出了完美决断,甚至精准揪出了埋藏在对话极早期的一张截图细节。
这一趟疯狂调用的总成本是多少?1.5 美分,折合人民币刚过一毛钱
anish. 在开源项目 SnapShift 的推文里直言不讳:“这是我用过第一个上下文再长也不会变慢变烂的决策模型,之前的 Jev 甚至无法望其项背。”
03算力浪费的荒诞剧:企业 AI 账单暴跌 98% 的秘密
当个人开发者还在惊叹于标签页一键归类和开源小工具的神奇时,企业架构师们早已看到了更惊心动魄的底层商业洗牌。
AI 分析师 Tanmay Goel 随即发布了一篇击中无数 CTO 痛处的行业檄文:《别再用最贵的模型做最简单的决策了》。
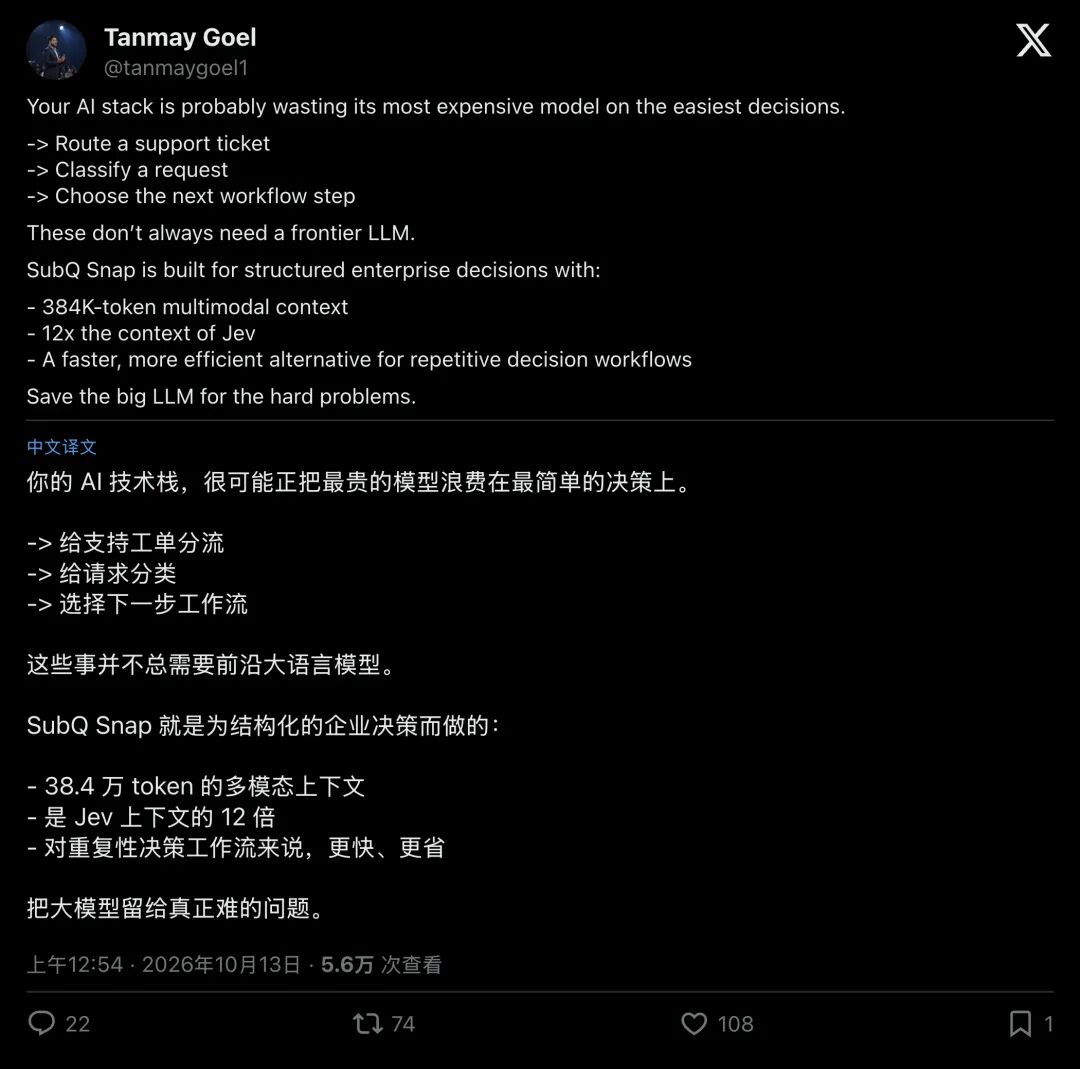
▲ Tanmay Goel 呼吁停止将昂贵前沿模型浪费在简单的流水线决策上
在过去两年的企业自主智能体流水线里,藏着四道几乎每轮都在疯狂空转的“隐形吞金兽”:
- 意图路由(Router)
:看一眼用户的几千字长文,只为了选出“退费”、“维修”还是“人工”; - 工具选择(Tool Picker)
:在几十个微服务接口池里,选出下一步调用的单个函数; - 合规防御与幻觉门控(Checker)
:检查工具返回的数据有没有违规、检索结果存不存在胡说八道; - 终止条件判定(Stopping Condition)
:判定当前多轮探索搜集到的代码与事实够不够,是“继续循环”还是“退出交付”。
这四道关卡占了整个智能体系统调用量的 70% 到 80%。
此前,无数企业被迫咬牙用 GPT-4o 级别的顶级生成大模型来硬扛这四道关卡。
我们可以算一笔极其血腥的经济账:
以一家中型企业为例,其多智能体客服或编程流水线每月需要跑 1000 万次 路由与门控判断。
- 采用通用前沿大模型
:哪怕每次平均只消耗 2000 个输入 Token 和 50 个输出 Token,按输入 $2.50/MM、输出 $10.00/MM 计算,这家公司每月光是在简单的分支判定上,就要向大模型厂商上缴 超过 5.5 万美元(约合近 40 万元人民币) 的纯 API 账单! - 改用 SubQ Snap 这类决策模型
:1000 万次调用,由于输出免费、输入仅 $0.05/MM,整整一个月的账单直接被干瘪到只有 1000 美元(约合 7200 元人民币)!
成本直接断崖式暴跌 98% 以上!
更别提延迟上的降维打击原本在大模型上空转等待自回归吐词,走完 5 轮“路由-工具-校验”循环往往要耗费超过 10 秒;而在 80 到 250 毫秒极速响应的决策模型加持下,整个流水线的响应速度直接飙升了 3 到 5 倍。
在软件工程层面,这也是一场彻底的解脱。过去为了防止大模型输出错误的 JSON 格式,工程师们必须写层层包裹的校验、重试与防御代码;而决策模型天然输出强类型概率向量,直接无缝对接系统代码,从根源上终结了格式崩溃的梦魇。
04神经反射与沉思大脑:AI 工业革命的下半场
当然,面对这场技术狂欢,理性的行业观察者依然保持着审慎。
必须承认,目前无论是 Decision Index v0.2.1 上的 61.7 分,还是对比 Jev 胜出 13 项基准的数据,大都来自 Subquadratic 团队的官方自测披露。面对公测期可能出现的算力拥堵与延迟波动,真实的工业界独立复测与长期稳定性仍需时间检验。
此外,像 Hasan 演示的 SnapTab,目前仍依赖本地 Python 服务读取浏览器的所有标题与网址。在享受“一键整理混沌”的极客快感之余,这些敏感路径与未保存草稿的数据边界,依然需要更透明的工程规范来守护。
但无论如何,这场由 32 个混乱标签页点燃的技术突围,已经不可逆转地揭开了人工智能演进的下一个篇章。
心理学诺贝尔奖得主丹尼尔·卡尼曼曾在《思考,快与慢》中提出人类大脑的双系统理论:系统 1 负责快速、无意识、直觉式的本能反应;系统 2 负责缓慢、深思熟虑、逻辑密集的复杂推理。
过去两年,我们盲目地试图用一个臃肿不堪的“系统 2”,去同时兼任每一次眨眼、每一次抬腿、每一次心跳。
而以 SubQ Snap 为代表的长上下文决策模型的登场,正在为硅基智能补齐它失落已久的“系统 1”,那是一套廉价、敏捷、长生不灭的条件反射神经系统。
未来的 AI 世界,绝不会是某个通晓万物的单体大模型孤身走天下。
在那张由千万行代码织就的未来工业网络里,我们终将看到:数以万计轻盈精准的神经触手在毫秒间做出断决,为少数几个沉思静虑的宏大头脑铺平道路。
大模型的虚火正在退去这一次,是工程师的理性与算力的冷酷,重新夺回了战场。