ARTICLE · 1191023
相关学习资料
 公文写作功底之简报_2025春招题库汇总_国企综合题库_1、国企招聘考试------笔试资料_综合写作_公文写作全套必过复习资料。
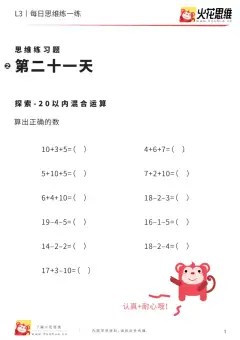 每日一练21-大班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_大班
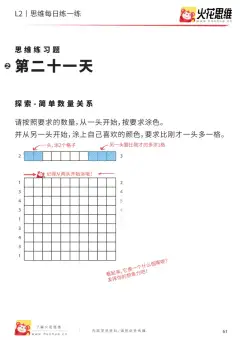 每日一练21-中班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_中班
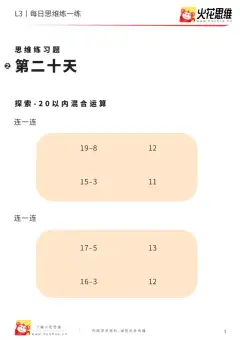 每日一练20-大班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_大班
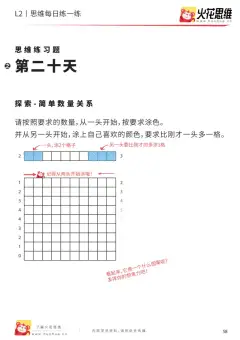 每日一练20-中班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_中班
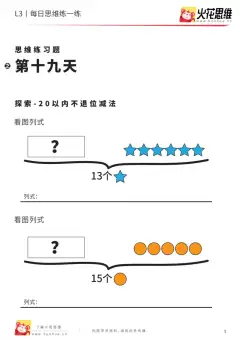 每日一练19-大班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_大班
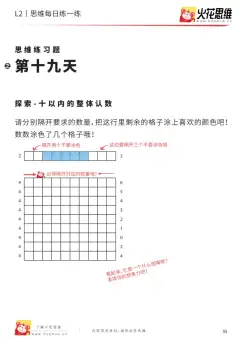 每日一练19-中班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_中班
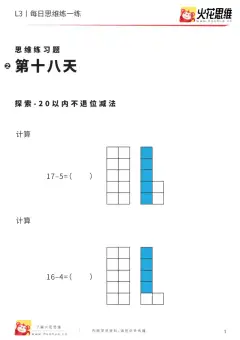 每日一练18-大班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_大班
 每日一练18-中班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_中班
 每日一练17-大班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_大班
 每日一练17-中班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_中班
 每日一练16-大班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_大班
 每日一练16-中班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_中班
 每日一练15-大班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_大班
 每日一练15-中班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_中班
 每日一练12-大班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_大班
 每日一练12-中班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_中班
 每日一练11-大班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_大班
 每日一练11-中班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_中班
 每日一练10-大班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_大班
 每日一练10-中班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_中班
 每日一练09-大班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_大班
 每日一练09-中班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_中班
 每日一练08-大班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_大班
 每日一练08-中班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_中班
 每日一练07-大班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_大班
 每日一练07-中班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_中班
 每日一练06-大班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_大班
 每日一练06-中班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_中班
 每日一练05-大班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_大班
 每日一练05-中班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_中班
 每日一练04-大班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_大班
 每日一练04-中班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_中班
 每日一练03-大班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_大班
 每日一练03-中班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_中班
 每日一练02-大班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_大班
 每日一练02-中班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_中班
 每日一练01-大班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_大班
 每日一练01-中班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_中班
 每日一练13-14-大班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_大班
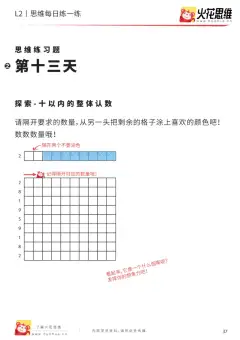 每日一练13-14-中班_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_中班
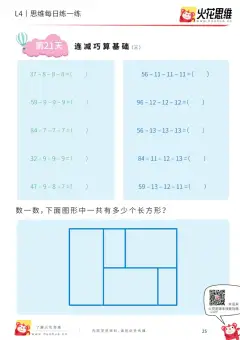 每日一练21-一年级_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_一年级
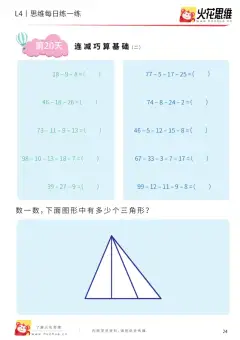 每日一练20-一年级_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_一年级
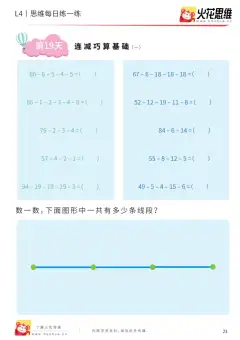 每日一练19-一年级_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_一年级
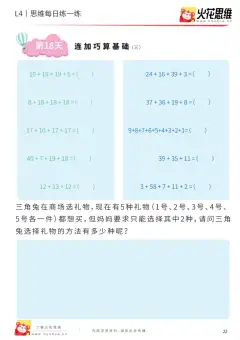 每日一练18-一年级_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_一年级
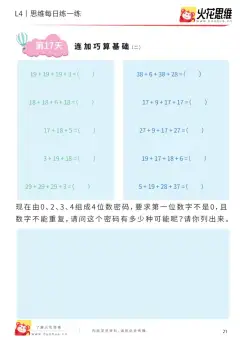 每日一练17-一年级_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_一年级
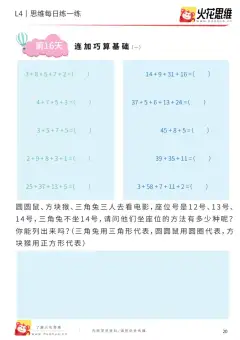 每日一练16-一年级_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_一年级
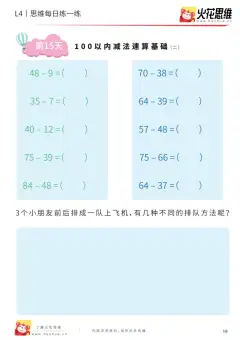 每日一练15-一年级_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_一年级
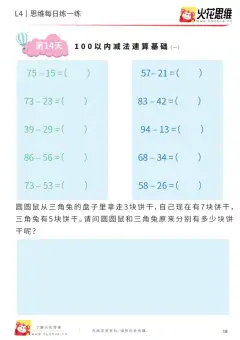 每日一练14-一年级_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_一年级
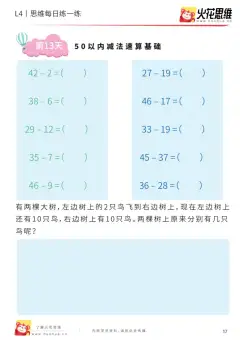 每日一练13-一年级_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_一年级
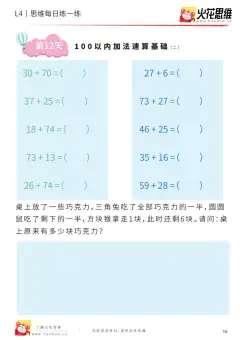 每日一练12-一年级_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_一年级
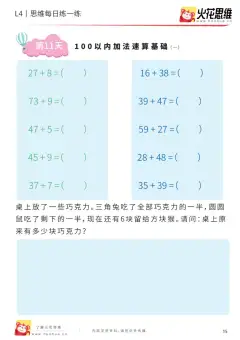 每日一练11-一年级_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_一年级
 每日一练10-一年级_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_一年级
 每日一练09-一年级_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_一年级
 每日一练08-一年级_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_一年级
 每日一练07-一年级_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_一年级
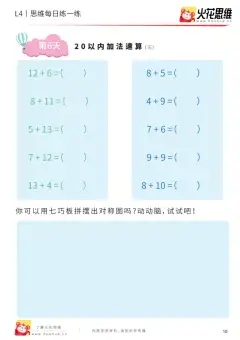 每日一练06-一年级_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_一年级
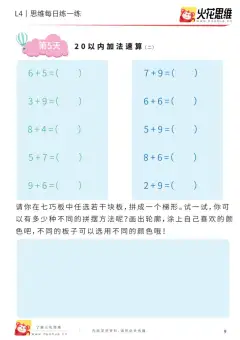 每日一练05-一年级_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_一年级
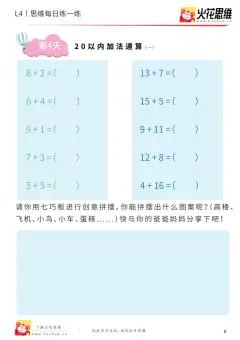 每日一练04-一年级_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_一年级
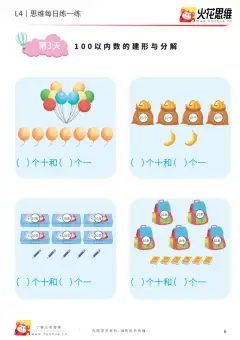 每日一练03-一年级_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_一年级
 每日一练02-一年级_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_一年级
 每日一练01-一年级_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题_一年级
 如何培养孩子专注力-火花思维21天每日一练公开课_(G1450)火花思维幼小衔接及L1-L5_L2完结_L2完结AI40课_07火花训练营福利合集_21天每日一练儿童计算训练题
 2026.3.4读懂AI红包大战公众号:叛逆小樱桃资料_3539.2027北京定向选调_08选调高分范文+写作素材+申论刷题集_20、人民日报范文每日精讲(按月更新)_3月人民日报精读
 25日-与AI同行,答案在人手中(评论员观察)_3539.2027北京定向选调_08选调高分范文+写作素材+申论刷题集_20、人民日报范文每日精讲(按月更新)_5月人民日报精读
 2024AI解析_2025春招题库汇总_快消题库-2_2023快消合集(17家持续更新中)_2024达能最新题库(AI开放题+游戏题)_2024达能秋招AI题
 AI2024汇总(持续更新中)_2025春招题库汇总_快消题库-2_2023快消合集(17家持续更新中)_2024达能最新题库(AI开放题+游戏题)_2024达能秋招AI题
 2024AI解析_2025春招题库汇总_快消题库-1_快消汇总_达能_2024达能秋招AI题
 数感锦囊_(G1450)火花思维幼小衔接及L1-L5_L3完结_L3完结AI_05完结AI41-88_补充资料练习册
 17.图文推理_(G1450)火花思维幼小衔接及L1-L5_L3完结_L3完结AI_05完结AI41-88_补充资料练习册
 14.数字推理_(G1450)火花思维幼小衔接及L1-L5_L3完结_L3完结AI_05完结AI41-88_补充资料练习册
 13.差数的应用_(G1450)火花思维幼小衔接及L1-L5_L3完结_L3完结AI_05完结AI41-88_补充资料练习册
 01-联合利华AI面合集(考试时随机抽取)_2025春招题库汇总_快消题库-1_快消汇总_联合利华_01-AI面和图形题
 20巧算启蒙练习册_(G1450)火花思维幼小衔接及L1-L5_L3完结_L3完结AI_05完结AI41-88_补充资料练习册
 19图形变换练习册_(G1450)火花思维幼小衔接及L1-L5_L3完结_L3完结AI_05完结AI41-88_补充资料练习册
 18.天平与不等式_(G1450)火花思维幼小衔接及L1-L5_L3完结_L3完结AI_05完结AI41-88_补充资料练习册
 16.数形结合练习册_(G1450)火花思维幼小衔接及L1-L5_L3完结_L3完结AI_05完结AI41-88_补充资料练习册
 15.经典应用题启蒙_(G1450)火花思维幼小衔接及L1-L5_L3完结_L3完结AI_05完结AI41-88_补充资料练习册
 01-联合利华AI面合集(考试时随机抽取)_2025春招题库汇总_快消题库-2_2023快消合集(17家持续更新中)_2024联合利华_01-AI面和图形题
 第14专题_数字推理_递变推理_火花秘籍_202003052029071_(G1450)火花思维幼小衔接及L1-L5_L3完结_L3完结AI_05完结AI41-88_补充资料练习册_14.数字推理