ARTICLE · 1191019
AI Agent 入门 02|上下文管理
FIELD NOTES / AGENT ENGINEERING
任务越长,Agent 越需要认真选择每轮输入的信息,并在失败后做出明确的恢复决策。
上一篇,我们拆解了 Agent 的模型、工具、状态和控制循环,也区分了 Tool Calling、Messages、State 与 Memory 的职责。
接下来,把这些部件放进一个稍长的任务:比如,分析代码仓库。Agent 读了多个文件,搜索了好几轮,用户还不断补充问题。消息越来越长,工具偶尔报错,原来的计划也可能走不通。
这时候,继续调用模型并不难,难的是决定两件事:下一轮到底给模型看什么,以及当前这条路径失败后该怎么办。
本篇围绕这两个问题展开:上下文窗口、摘要、裁剪、检索,以及错误分类、重试和恢复动作。
本文看点
01
一、上下文窗口:一次调用能同时看到多少信息
02
二、为什么 Agent 更容易把上下文塞满
03
三、管理上下文的三种常见方法
01
CONTEXT
一、上下文窗口:一次调用能同时看到多少信息
模型每次调用能使用的上下文都有容量限制,这就是上下文窗口(Context Window)。理解这个限制时,既要计算输入,也要为本次生成预留空间,通常以 token 为单位衡量。
上下文窗口不能直接等同于“最多能塞进去多少输入”。输入和生成内容如何共同占用窗口,要看具体模型和接口;部分模型的推理内容也消耗相关预算,最大输出长度还可能有单独限制。如果输出预算已包含推理用量,就不能再重复相加。
本轮输入通常包括:
• 系统提示词,也就是 system prompt。
• 用户消息,也就是 user message。
• assistant 的历史消息。
• tool 调用记录。
• tool 返回结果。
• 额外放进去的 memory 摘要。
• 本轮提供给模型的工具描述和参数 Schema。
因此,不能只看“用户这次问了多少字”。系统提示、对话历史、工具定义和工具返回,只要成为模型输入,就会占用相应空间。OpenAI 的函数调用文档也说明,工具定义会计入输入 token。
一个用户问题可能只有一两句话,Agent 为了回答它读进来的材料,却可能远远超过问题本身。安排下一轮调用时,要同时估算这些输入,并为生成内容留出预算。
02
CONTEXT
二、为什么 Agent 更容易把上下文塞满
最简单的一次聊天,可能只有系统提示、用户提问和模型回答。Agent 在推进任务时,还会不断增加新的信息:
• 多轮对话历史。
• 多次工具调用。
• 大段工具返回结果。
• 任务计划。
• 状态摘要。
• 长期记忆片段。
任务每向前走一步,这些内容都有可能继续累积。Agent 因而比简单聊天更容易遇到几类问题:
上下文越来越长,新的材料难以继续放入。
调用成本变高,同一批历史内容可能在后续轮次反复输入。
延迟变高,系统需要处理的上下文更多。
模型抓不住重点,关键线索混在大量旧信息里。
请求失败或内容被截断;如果运行时裁剪了旧历史,后面的判断还可能缺少前面已经讨论过的内容。
超过容量限制时,接口可能直接拒绝请求,也可能按配置裁剪输入,或在生成达到限制时结束。是否自动处理旧历史,取决于模型接口与运行时策略,不能假定系统总会替你妥善保留重点。
例如,用户只是继续追问“还有别的问题吗”,这句话很短;但如果系统把此前读过的所有文件、所有搜索结果和全部对话都带上,下一轮输入依然可能很大。
所以,设计 Agent 时需要持续做一件事:判断哪些信息值得留在下一轮,而不是每轮都把全部历史重新堆进去。
03
CONTEXT
三、管理上下文的三种常见方法
1. 摘要:把长内容变成可继续使用的短结论
摘要(Summarization)是把长对话或长工具结果压缩成更短的内容,让后续步骤继续使用。
假设工具返回了一大段日志,而且关联记录已经提供足够证据,可以把它提炼为几条结论:
• 调用了 3 次接口。
• 第 2 次返回 500。
• 关联记录已确认 auth 服务超时,并保留对应证据引用。
比起每轮都带上整段日志,这几条信息更容易继续放进模型的上下文。
但“第 2 次返回 500”本身不能证明 auth 服务超时。如果关联证据还没核实,摘要就应明确区分:已观察到 500,auth 超时只是待核实线索。摘要不能为了写得简短,把假设改成事实。
整理诊断类摘要时,可以保留四类内容:已知事实、待验证假设、下一步动作、原文引用。这样后续既能继续推进,也能在需要时回到证据。Anthropic 的上下文工程文章同样强调,压缩应保留关键细节和继续任务所需的信息。
摘要的价值在于:把当前还要用的内容留下,同时减少后续轮次反复携带的原文。
2. 裁剪:移除已经不重要的旧消息
裁剪(Trimming)是把对当前任务已经不重要的旧消息移出上下文。
例如:
• 已经过时的中间步骤。
• 对当前任务没有帮助的内容。
并不是所有历史都值得一直保留。某一步的探索过程曾经有用,并不代表它在之后每一轮都同样重要。
摘要保留一份短的描述,裁剪则直接减少当前还要携带的内容。选择哪种方法,要看后续是否还需要依靠这段信息继续判断。
这里移除的是下一轮的活跃上下文,不等于删除审计记录或外部证据。当前目标、硬约束、未解决的问题和必要引用,仍应优先保留。
工具调用还可能受消息协议约束:如果接口要求调用与结果配对,就不能只留下某条工具结果,却删掉关联的调用记录。裁剪应按完整交互单元处理,并遵守实际接口的消息顺序要求。
3. 检索:需要的时候再取回来
检索(Retrieval)强调按需取回。长期 memory 不必始终整份放在上下文里,可以等当前任务需要时,再取出相关内容。
例如:
• 用户问 Python 代码问题时,再取出“用户偏好 Python”。
• 用户继续之前的仓库分析时,再取出“上次分析进度摘要”。
这样,系统可以保存比单次上下文更多的信息,同时只把与当前问题相关的部分交给模型。
这也是长期 memory 常常需要按需检索的原因:保存了某条信息,不意味着每次调用都要把它带上。
补充:需要精确原文时,可以先卸载再按需取回
如果工具结果很大,而后续又可能需要精确内容,可以先把原文存到任务受控的外部存储中,只在上下文里保留短预览和引用句柄;需要时再按范围取回。
这就是信息卸载:先改变信息的存放位置,再结合检索使用。摘要减少当前携带的内容,卸载则保留可取回的原文,两者可以配合。
例如,较长的日志不必每轮全文输入;模型可以先看到一段预览和有效引用,再读取需要的部分。是否能恢复原文,取决于存储是否仍存在、引用是否有效,以及当前任务是否有读取权限。
只留下“我查过了”或一个已经失效的路径,无法代替真正可用的证据引用。
04
ENGINEERING
四、分析一个仓库时,Messages、State 和 Memory 怎么安排
假设 Agent 正在分析一个代码仓库,已经发生了这些事情:
• 读了 15 个文件。
• 调了 8 次搜索工具。
• 用户又追问了 4 轮。
• 每个工具返回的内容都很长。
如果把这些原文全部塞进 Messages,上下文很快就可能变得庞大而混乱。
一种更容易管理的组织方式,是分别看“本轮继续判断要用什么”“程序要跟踪什么”“以后还可能复用什么”。
放在 Messages 中的内容
• 当前任务目标。
• 最近几轮最关键的上下文。
• 与当前步骤相关的文件摘要。
• 最近一次工具调用结果。
这些内容服务于下一轮判断:模型现在要解决什么问题,眼前有哪些线索。这里的“最近一次工具结果”只是简化例子,不是通用的固定保留数量;如果当前判断还依赖更早的结果或未闭合的工具交互,就需要把相关内容一并保留。
存进 State 的内容
• 已读文件列表。
• 已发现问题列表。
• 当前计划。
• 重试情况。
这些内容帮助系统跟踪任务进度,知道哪些工作已经做过、当前正在做什么,以及之前是否发生过失败。
存进 Memory 或外部存储的内容
• 用户偏好。
• 历史学习进度。
• 上次任务总结。
这些内容可能在以后继续发挥作用。当前需要其中哪一部分,再结合任务取回来。
这三组信息对应的是不同用途,并不要求实现成三个互斥的容器。Messages 记录交互内容,State 保存程序跟踪任务所需的信息;同一条信息可以同时出现在两处,也有框架会把 messages 作为 state 的一个字段。
把内容放进 State,不会自动减少模型输入。如果运行时每轮又把整个 State 原样序列化给模型,它仍然占用上下文。真正决定输入大小的,是本轮实际交给模型的内容。
以配置文件为例,同一件事可以有三种表示:
例如,State 记录了已读 15 个文件,并不意味着下一轮要把文件清单和全部原文都发过去。运行时可以只选与当前步骤相关的文件、必要结论和证据引用;需要精确原文时,再按路径与范围取回。
OpenAI Agents SDK 也区分本地 Context 对象和模型可见的 LLM Context:本地对象的字段不会因为存在,就自动成为模型输入。
因此,整理这些信息时,需要分别判断:程序应当跟踪什么,本轮模型必须看到什么,以及之后可能复用什么。
05
ENGINEERING
五、什么时候应该做摘要
下面这些场景,通常值得考虑摘要:
• 对话明显变长。
• 工具返回了很大一段文本。
• 一个阶段已经完成,后面只需要保留结论,不需要一直携带原文。
• 下一轮只需要关键结论,不需要全部细节。
例如,读完 10 个文件后,不一定要让这 10 个文件的全文继续留在每一轮输入里。可以先保留每个文件的一行结论摘要,让后续步骤知道它大致负责什么、与当前问题有什么关系。
这一行摘要适合作为索引和定位线索。要修改代码、核对条件分支或引用精确内容时,还需要读回对应文件和范围;跨版本分析还应保留文件所属的版本,避免读回的已经是另一份代码。
但摘要有自己的边界:如果下一步依赖精确原文,就不能只保留摘要。
“我已经看过某个文件”和“我现在还能准确引用其中的内容”,是两种不同的能力。是否继续保留原文,需要结合下一步任务判断。
设计 Agent 时,可以反复问自己四个问题:
这条信息当前轮真的必须给吗?
给摘要就够了,还是必须给原文?
不给模型看,程序自己记着是否就够了?
以后如果需要,能不能从外部再取回来?
这四个问题能帮助我们判断,什么时候摘要、什么时候保留原文,以及什么时候应该让信息留在模型之外。
06
AGENT
六、错误会发生在 Agent 链路的每一层
上下文安排好了,任务也不一定能一路顺利执行。Agent 往往包含一条较长的处理链路:
用户输入。
模型决策。
工具选择。
参数生成。
工具执行。
结果回填。
下一步决策。
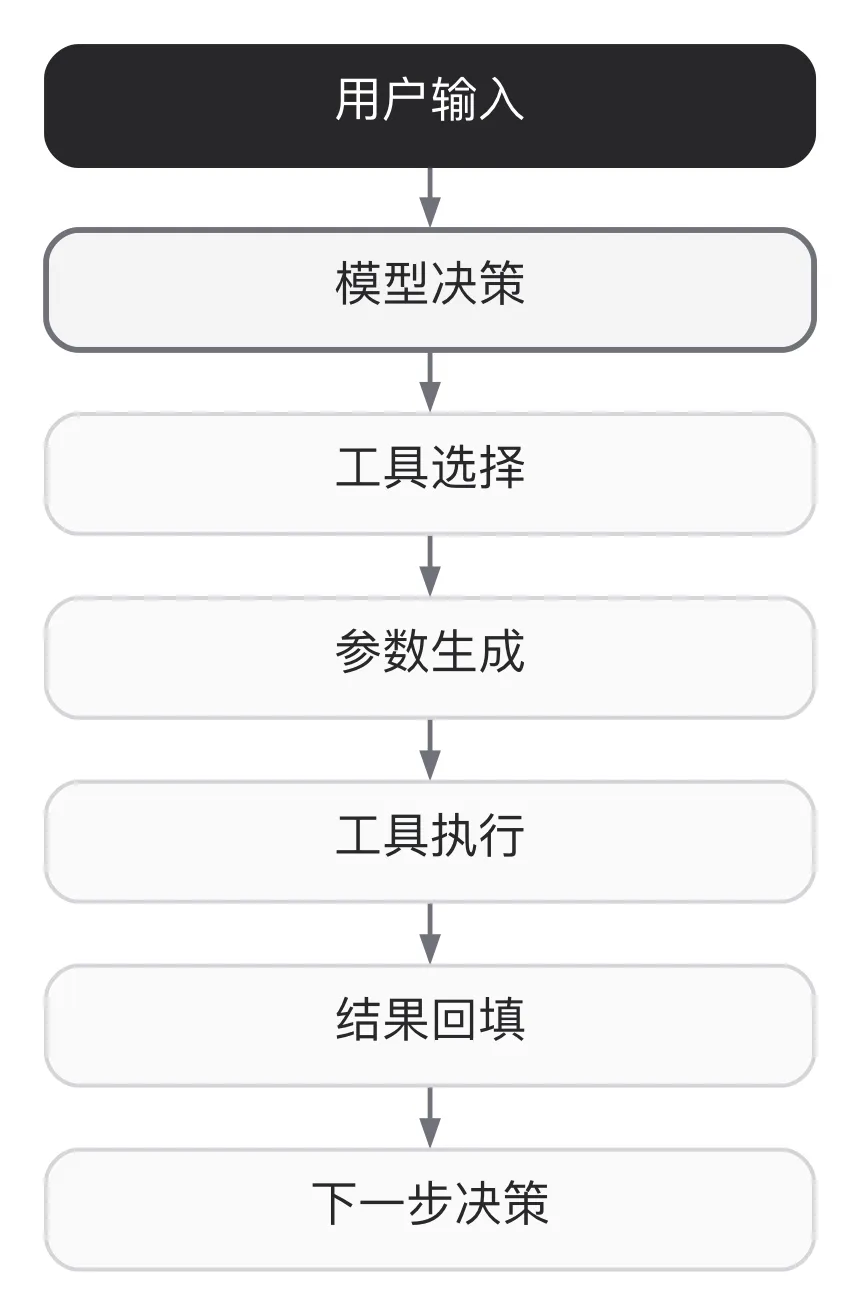
图 1|从用户输入、模型决策到工具执行与结果回填的七步链路
任何一层都可能出错。用户可能给错路径,模型可能选错工具,工具可能超时,运行时也可能没有正确更新状态。
如果缺少错误处理,常见后果包括:
• 一次报错就导致整个任务崩掉。
• 模型没有被告知失败,还继续编造后续答案。
• 系统进入死循环,不断重复重试。
• 用户完全不知道任务卡在哪里。
错误处理需要让系统明确知道:错了什么、能不能恢复、该不该继续。
07
ENGINEERING
七、先区分四类常见错误
错误看起来都是一次失败,但发生的位置不同,需要的处理方式也可能不同。
例如,文件没有读到,既要检查调用时给出的路径,也要看实际执行时发生了什么;模型选错工具,则需要重新判断下一步动作。
分类的作用,是帮助系统找到应该处理的环节,而不是把所有失败都交给同一个重试按钮。
08
ENGINEERING
八、哪些错误值得重试,哪些需要先改变条件
并不是所有错误都应该重试。
在操作允许安全重复执行、且仍有剩余预算的前提下,通常适合考虑重试的,包括:
• 网络超时。
• 临时性服务不可用。
• 限流。
• 偶发依赖故障。
这些错误有可能只是临时状态,再尝试一次就能继续执行,但“网络超时”需要特别判断。
超时只说明调用方没有及时收到结果,不能证明服务端没有执行。只读查询通常可以在预算内有限重试;发送消息、提交订单或修改数据等有副作用的操作,应先核对执行状态,或依赖接口实际支持的幂等键和去重机制。幂等机制的作用,是让同一业务操作的重复请求按约定避免重复生效。
如果无法确认是否已经执行,就要记录为“结果未知”,不要盲目重复操作。限流或临时服务不可用时,还应结合服务端的重试提示、退避等待和抖动安排下一次尝试;抖动就是给等待时间加入一定随机性,减少多个调用方同时再次请求。
而下面这些问题,单纯重复同一次调用通常无法解决:
• 文件路径写错。
• 参数缺失。
• 工具名不存在。
• 用户目标不清楚。
• 权限永久不足。
路径写错了,重复读取同一个错误路径不会让文件出现;缺少关键输入,也不会因为调用次数增加就自动补齐。
因此,可以先记住这个原则:原样重试主要应对暂时性故障;逻辑错误需要先改变条件。
本文把 Retry 理解为:在相同任务条件下,对同一操作进行有限次重试。路径或参数错误应先纠正;工具不合适,则需要重新选择路径。部分框架也会把纠正参数后的再次调用称为 retry,具体术语可能不同,关键是识别本次到底有没有改变条件。
纠正后的再调用同样受次数、时间和费用预算限制。要决定是否重试,系统首先需要知道当前失败属于什么情况。这也是工具返回结构化错误信息的意义。
09
TOOL CALLING
九、让工具明确返回成功、失败和是否可重试
下面的文件读取示例,展示了一种简单的错误表达方式。这里按 OpenAI Agents Python SDK 说明 @function_tool 的来源:它用于把函数封装成框架工具,依赖安装、Agent 注册和运行时接入在片段中省略。
所需的装饰器导入是:
from agents import function_tool
工具函数的主体如下:
@function_tool
def read_local_file(path: str) -> dict:
"""Read a local text file."""
try:
with open(path, "r", encoding="utf-8") as f:
return {
"success": True,
"content": f.read()
}
except FileNotFoundError:
return {
"success": False,
"error_type": "file_not_found",
"error": f"File not found: {path}",
"retryable": False
}
except Exception as e:
return {
"success": False,
"error_type": "unknown",
"error": str(e),
"retryable": False
}
成功时,它返回 success: True 和文件内容。文件不存在时,它返回 success: False,并用 error_type、error 和 retryable 说明发生了什么。
这几个字段分别承担不同作用:
• success:当前调用是否成功。
• content:成功时得到的内容。
• error_type:便于程序区分的错误类型。
• error:当前错误的说明。
• retryable:是否允许针对这次失败继续重试。
在这个示例中,文件不存在和未分类异常都被标成不可重试。调用方可以据此停止重复调用,而不是只收到一个模糊的“失败”。
这段示例关注的是错误如何表达;恢复动作仍然需要由外层流程继续决定。工具返回的 retryable 是一次失败的分类信息,运行时还应结合操作权限、幂等性和剩余预算,决定是否真的再次执行。
@function_tool 装饰后得到的是框架的 FunctionTool 对象,不应把它当成未装饰的普通 Python 函数直接调用。后面出现的 call_tool() 只是“由运行时执行工具并取得结果”的抽象;两个片段不能直接拼成完整项目。官方仍支持 function_tool,tool 是它的别名,这里不需要为换名称而改写示例。
文件读取工具还需要哪些执行边界
上面的 open(path) 没有实现授权目录限制,f.read() 会把全文读入内存;相对路径还依赖进程的工作目录。文件较大时,返回全文又会加重本篇前面讨论的上下文问题。
接入实际 Agent 时,需要在执行层限制授权目录和读取大小,处理路径、符号链接和文本编码,并按需支持分段读取。路径规范化可以辅助定位文件,但不能单独代替授权或沙箱。
当前片段只单独捕获了 FileNotFoundError。在进一步实现时,可以按需要细分下面这些错误,让运行时更容易选择恢复动作:
| FileNotFoundError | |
| PermissionError | |
| IsADirectoryError | |
| UnicodeDecodeError |
表中 PermissionError、IsADirectoryError、UnicodeDecodeError 的细分分支尚未实现,当前会进入 unknown;FileNotFoundError 已单独处理。对模型返回足以采取下一步动作的简短错误信息,供排查的完整异常则记录在受控日志中。
另外,示例的所有失败分支都设置了 retryable=False,它没有演示一次真正可重试的失败。文件不存在后,如果修正了路径或补齐输入,再调用属于条件改变后的新尝试。
10
ENGINEERING
十、给重试设置次数和明确出口
一个基本的重试策略,需要考虑四件事:
限定最大次数。
只对可重试错误生效。
每次重试前记录原因。
超过次数后停止。
下面这个循环展示了最基本的次数限制和退出判断:
max_retries = 2
for attempt in range(max_retries + 1):
result = call_tool()
if result["success"]:
break
if not result.get("retryable", False):
break
max_retries = 2 表示首次调用之外,最多再尝试两次,因此循环最多调用工具三次。
每一轮都检查两件事:当前调用是否成功;如果失败,这个错误是否允许重试。成功就结束,不允许重试也结束。只有失败且被标记为可重试,循环才有机会继续下一轮。
这个结构给当前这层重试设置了上限:即使工具持续报错,这个循环也最多调用工具三次。
但这段代码只实现了次数限制和两类 break 判断。call_tool() 是占位函数,实际运行时应返回约定结果,或把调用异常转换成受控的错误结果;如果它直接抛出异常,这个循环本身并没有捕获逻辑。
循环退出后,还要继续检查最后的 result。外层流程可以区分这些情况:
| success=True | |
循环结束不等于任务成功。工具重试是否结束、这次工具调用是否成功,以及整个任务是否完成,需要分别记录。
网络重试还要处理等待和总预算
前面提出的“每次重试前记录原因”,在这个最小循环里尚未实现。实际接入时还要补上:
• 单次调用超时,以及整个任务共同的时间和费用预算。
• 重试原因、已尝试次数和最后结果的受控记录。
• 对限流或暂时性依赖故障使用退避等待,按需要加入抖动。
• 次数耗尽、超时或不可重试时的明确出口。
还要检查 SDK、HTTP 客户端或工具内部是否已经重试。如果每一层都独立配置多次尝试,真实请求次数可能被放大。应明确由哪一层主导重试,避免额度层层叠加。
这些是把最小控制骨架接入真实工具时需要补齐的责任,不能把上面的几行循环当作完整的网络恢复实现。
11
ENGINEERING
十一、失败后,选择 Retry、Re-plan、Ask User 或 Stop
从错误恢复的角度,可以把下一步动作整理成四类:
这四种动作几乎覆盖了大部分 Agent 错误恢复场景。要处理的重点,是识别自己现在该进入哪一种。
什么时候应该 Ask User
下面这些情况,可以考虑向用户询问:
• 缺少关键输入,而且无法可靠推断。
• 用户需求存在歧义。
• 多个选项会带来不同后果,需要用户决定方向。
• 涉及高风险动作,需要确认。
• 工具失败表明外部信息缺失。
例如,当继续执行所需的信息并不在当前材料中,且系统不能可靠推断时,把缺口明确交还给用户,比反复尝试更容易推进任务。
不过,工具失败不代表一定要问用户。如果缺失信息能够通过已经授权、成本可控的其他途径可靠补齐,可以先调整计划;缺口需要用户判断、补充或授权时,再把控制权交还给用户。
涉及高风险动作时,仍由既有授权和外层策略判断能否执行;需要补充确认时才询问用户,不能让模型自行宣布已经获得权限。
什么时候应该 Re-plan
下面这些情况,说明需要重新考虑原来的路径:
• 原计划依赖的前提不成立。
• 工具结果推翻了原假设。
• 当前路径连续没有进展。
• 重复动作开始出现。
• 新信息表明存在更好的路径。
例如,工具已经返回了与原假设不符的结果,就需要结合这个观察重新选择下一步。重试原来的动作和重新规划,是两种不同的恢复选择。
重新规划同样受最大步数、总时长和费用预算限制,不能因为换了工具或计划就把预算清零。记录已尝试的路径、失败原因和新获得的线索,才能判断是否真的产生了进展。
停止时,把结果和缺口说清楚
停止当前自动运行时,应交代已经确认的事实、还缺少的信息,以及停止原因。等待用户补充、证据不足、预算耗尽和任务成功,需要作为不同结果记录;不能只因为循环结束,就把任务状态标为完成。
这也把错误恢复与 State 联系起来:程序要跟踪的不只是“执行过哪些步骤”,还包括为什么继续、为什么换路,以及为什么结束。
12
INTERVIEW
十二、面试时,怎样把这些边界讲清楚
为什么不用一个更大的上下文窗口解决所有问题
更大的窗口能容纳更多材料,但仍要考虑输入成本、延迟,以及这些信息是否与当前决策相关。应用需要挑选本轮必要内容,并保留取回精确原文的方式;具体预算和能力则以实际模型、接口与工作负载为准。
讨论时可以把问题落到一个具体任务:读过 15 个文件后,下一轮究竟需要它们的全文、摘要,还是其中两个文件的精确片段。窗口大小只是约束之一,信息选择本身仍需要设计。
把历史放进 State,模型是不是就能自动记住
State 让程序跟踪任务;模型能否利用其中的信息,取决于运行时有没有把必要字段、相关摘要或工具读回结果交给它。把整个 State 重新输入模型,依然占用上下文。
可以用“程序保存了什么”和“本轮模型实际看到了什么”来解释。两者可能有重叠,但不会因为数据结构名字不同,就自动改变模型的可见范围。
给工具加三次调用上限,就算设计好错误恢复了吗
次数限制只解决无限重试的一部分问题。系统还需要判断错误能否恢复、操作能否安全重复、何时改计划或询问用户,以及退出后如何记录结果。
超时尤其要区分“收到明确失败”和“结果未知”。如果外部操作可能已经生效,就要先核对状态或使用接口支持的幂等机制,再决定是否重试。重新规划也必须服从整个任务的共同预算。
∞
THE END
收尾:把每一轮输入和每一次失败都管起来
上下文管理决定模型下一轮带着哪些信息继续;错误处理决定一条路径失败后,系统是重试、重新规划、询问用户,还是停止。
接着第一篇的模型、工具、状态与控制循环,本篇把注意力放到了更具体的执行问题:历史如何整理,精确原文何时要保留和读回,工具错误如何表达,以及重试怎样有明确的次数、预算和出口。
做一个稍长的 Agent 任务时,可以从两件事开始检查:本轮输入里有没有不再需要的材料;遇到错误后,系统有没有明确的恢复动作。