ARTICLE · 1191011
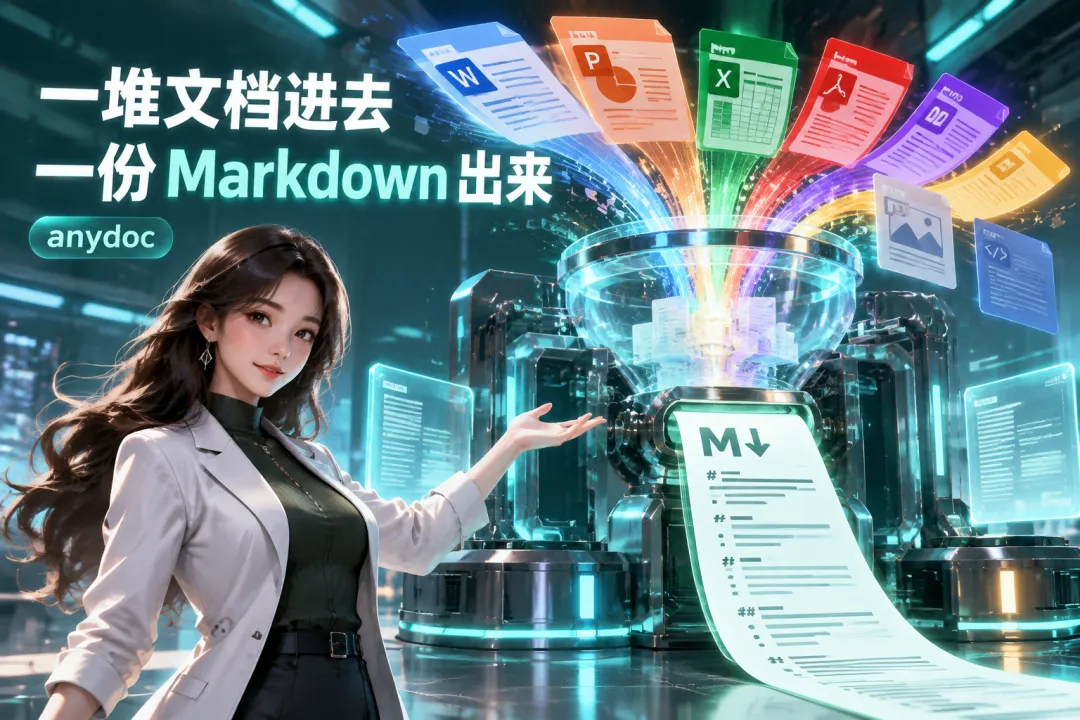
把 Word、PPT、Excel 一起丢进去,出来是一份干净的 Markdown
把 Word、PPT、Excel 一起丢进去,出来是一份干净的 Markdown
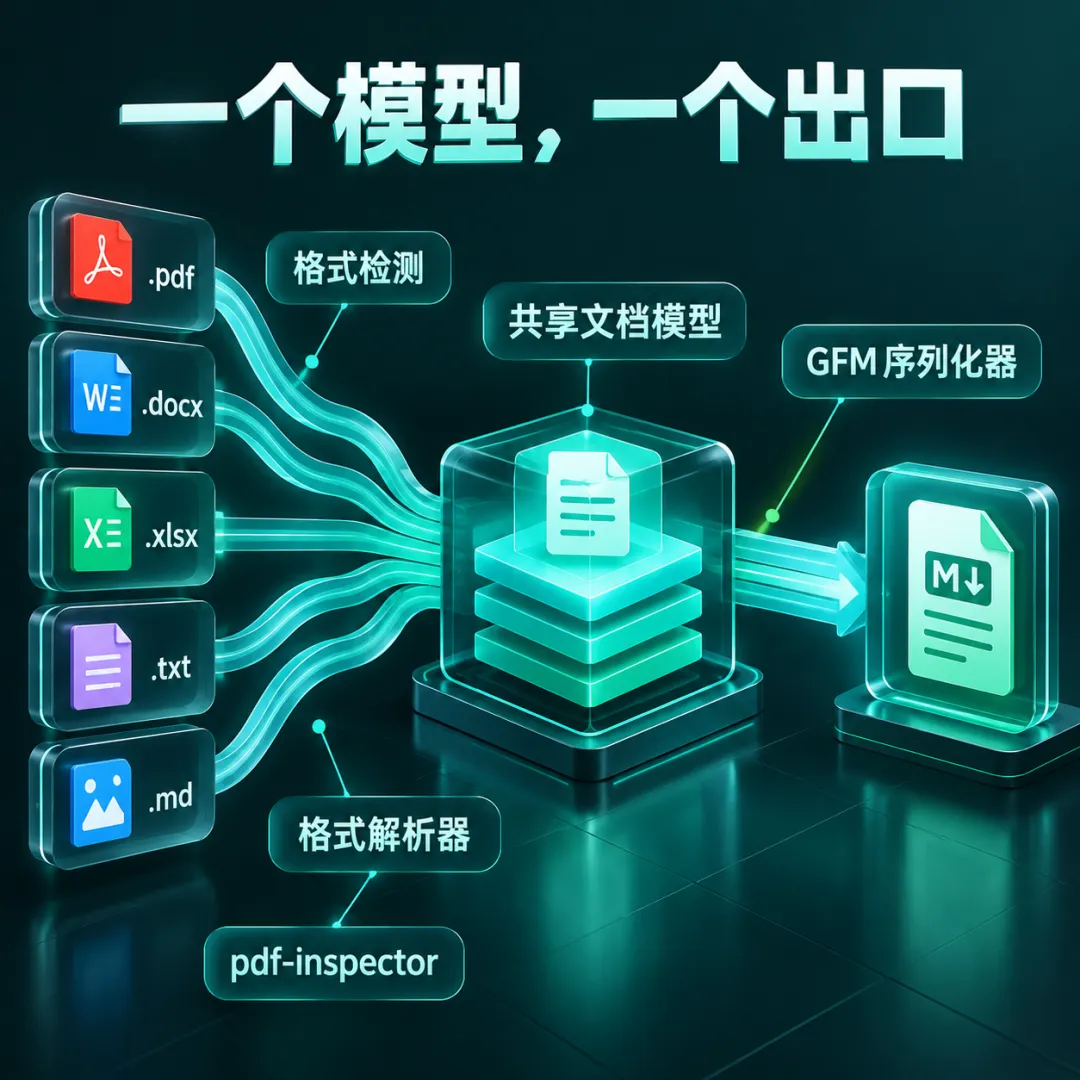
它把八种文档格式解析进同一个文档模型,再用同一个序列化器输出——所以给 docx 修的表格转义问题,会自动变成给 rtf、odt 修的。
▼ QUICK READ · 几秒钟速读版
CORE TAKEAWAY
它的价值不在于「能转 Markdown」,而在于「同一个出口」——喂给 AI 之前,把一堆格式的文档统一成一份结构可预期的东西,这件事的收益在流程上,而不在单次转换上。
阅读预计耗时:约 7 分钟
完整阅读版
你手里大概有一堆要处理的文档:供应商发来的报价单是 Excel,客户给的方案是 Word,汇报材料是 PPT,还有几份扫描件是 PDF。
你想让 AI 读它们,第一步就卡住了:格式太多,喂不进去。
复制粘贴是一种办法。粘十份文档之后你会知道它有多不靠谱——表格散了,层级丢了,编号乱了。
anydoc 解决的就是这一步。它现在 2.2 万 Star,MIT 许可,Rust 写的,出自 Firecrawl。
但它真正值得看的不是「支持多少格式」,是它怎么保证「不同格式出来长得一样」。
先说结论
如果你只读一段,读这段。
anydoc 的核心设计是「一个模型、一个出口」:每种格式先解析进同一个文档模型,再由同一个 Markdown 序列化器渲染。
一句话概括:它不解决「AI 怎么理解文档」,它解决「文档先变成一份能喂进去的东西」。
anydoc 到底是什么
官方定位是一句话:把文档(Word、PowerPoint、Excel、OpenDocument、RTF、EPUB、CSV 和 PDF)转成干净的 GitHub 风格 Markdown 的快速 Rust 库。
关键词是「一个一致的输出」:不管进来的是什么格式,出去的结构是一样的。
它支持的具体格式:
用法在四个语言里长得几乎一样。命令行最短:`npx @firecrawl/anydoc report.docx` 直接输出到终端,加 `-o` 写文件,`-` 从标准输入读。
它还带一个 Agent Skill:`npx skills add firecrawl/anydoc`,装完之后你的 Agent 就能自己读它遇到的文档。
浏览器版是 WebAssembly 编译的,官方 demo 页明确写着:文件在本地转换,不会离开你的机器。
为什么它容易进入工作流讨论
第一,「把文档喂给 AI」是一个人人都会撞到的前置步骤。它不是小众需求,它是所有文档类 AI 应用的第一公里。
第二,它把「保真」拆成了可比较的维度。官方没有只说「我们转得准」,而是拆成完整性、结构、格式、干净度四项来打分。
第三,它有一张很难得的东西:方法论写得很细的对比表。哪六个对手、怎么评的、评了多少次,都写在 README 里。
一个容易被忽略的背景
它是 Firecrawl 出品的,并且驱动 Firecrawl 自己的 Parse 产品。这意味着它有一个商业产品在真实流量上跑——对这类转换库来说,这比单纯的 Star 数更能说明问题。
它真正让我在意的是:那张评测表,以及它的评法
很多开源项目都会贴一张「我们比对手好」的表格。anydoc 这张表值得看,是因为它把评法一起写了。
官方口径是:100 份真实文档、跨 14 种格式、对比 6 个其它转换器,分数 0–100,速度是转换一份文档的中位时间。
更关键的是它自己指出的一件事:总分是把「它支持的每种格式的分数」平均出来的,所以每一行平均的格式集并不一样。 mammoth 的 70 分只是 docx 一项,而 anydoc 的 81 分跨了全部 14 种。官方因此专门又给了一张逐格式的对照表,说「那张才是公平比较」。
评分方法也交代了:一个 LLM 判官(Claude Sonnet 5)盲评两个工具的输出,对照的地面真值是文档前六页由 LibreOffice 渲染成的图片;每一对判两次、交换位置以抵消位置偏置,共 482 次判定。
速度条件也写了:Ryzen 9 9950X3D、Windows 11、64 GB DDR5-6400,每份文档一次热转换;库类不计进程启动,命令行工具计入。
我愿意花篇幅写这些,是因为这决定了我怎么引用这张表。它是一份自述的评测,不是第三方评测;但它把方法和限制都摊开了,所以它有引用价值——引用时把口径一起带上就行。
还有两个设计我觉得比分数重要:
基于内容的格式检测
它从字节本身判断格式(PDF 头、RTF 的开括号、OLE 流名、ZIP 包的 mimetype),而不是看扩展名。所以一个被错误命名的文件也能正确转换。CSV 没有这种标记,才需要靠扩展名或显式指定。
PDF 的分岔
文本型 PDF 本地转(走 pdf-inspector);扫描件会失败并返回 `NeedsOcr`,要处理就得显式选择托管 OCR——这时只有需要 OCR 的文档会离开机器,而且是整份文档都传(托管服务没有页面选择)。官方也写明:Rust crate 没有 OCR 选项,永不发起网络请求。
适合谁
要把一堆混杂格式的文档喂给 AI 的人。 这是它最标准的场景,官方自己给的最佳适配也是「收到混杂 office 文档、需要一份一致结构化 Markdown 输出的流水线」。
在写文档处理流水线的人。 四套绑定意味着你可以在 Node 服务、Python 脚本、Rust 程序或浏览器里用同一套逻辑。
在意「文件不出机器」的人。 本地转换是默认行为,只有扫描件 PDF 需要显式 opt-in 才会走托管。
要处理老格式的人。 `.doc`、`.ppt`、`.xls` 这类格式,很多现代工具已经不支持了。
需要公式和表格结构的人。 公式转 LaTeX(`$...$` 和 `$$`),表格保留合并单元格和表头行。
不适合谁
要「无损还原排版」的人。 它的目标是结构化 Markdown,不是版式还原;官方也不承诺无损。
要处理扫描件、又不想把文件传出去的人。 这类文档要么走托管 OCR,要么得自己在外面接 OCR。
只偶尔转一两个文件的人。 网页版够用了,不用装。
要转图片、音频、视频的人。 它处理的是文档格式,不是媒体格式。
需要它读懂内容的人。 它只做格式转换,不做摘要、不做问答、不做信息抽取。
坑和注意点
最重要的一条
那张 benchmark 是项目自述的评测,不是第三方评测。它把方法写得很细,但样本是 100 份、语料不可再分发(README 说语料不在仓库里)。引用分数时要把口径一起带上。
其余要注意的:
我怎么看
我把 anydoc 看成一件「基础设施」性质的工具。
它没有炫目的能力,它做的是把文档变成文本这一步。但这一步是所有文档类 AI 应用的第一公里,而第一公里最容易被低估——因为大家默认它「应该很简单」。
它值得注意的地方有三个:同一个出口(修复全局生效)、四套绑定(能在任何地方用)、评测透明(方法、样本量、判法都写了)。
我最欣赏的是它把「平均口径不一致」这件事自己指出来了。一个项目愿意在展示优势的表格下面,主动说明「这张表的对比并不公平,请看另一张」,这比分数本身更能说明它的可信度。
所以我的判断是:它适合先接进流水线试一批真实文档,再决定要不要长期用。转换质量这件事,看别人 100 份语料的分数,不如看你自己那 10 份。
SAVE THIS
收藏版清单
下一步建议:拿你自己的文档试,而不是先看分数。
我的顺序是这样。
第一步,用 `npx @firecrawl/anydoc` 直接转你自己的三份文档。一份 Word、一份 PPT、一份 Excel。
第二步,重点看三处:表格有没有散、标题层级对不对、列表编号有没有乱。
第三步,如果 PDF 里有扫描件,先确认它返回的是 `NeedsOcr` 而不是别的错误。
第四步,再决定接哪种绑定。 服务端用 Node 或 Rust,脚本用 Python,纯前端场景用 WebAssembly。
按这个顺序走,最坏情况你只是花了十分钟转了三份文档。反过来,先按官方分数选型、再发现自己的文档类型不在语料里,返工的是整条流水线。
来源说明:
· 仓库:https://github.com/firecrawl/anydoc
· 官网 / Demo:https://firecrawl.github.io/anydoc
· Star / Fork / 许可 / 主语言为 GitHub API 时间截面(采集时间 2026-10-08):22,606 Star / 1,432 Fork,MIT,主语言 Rust
· 格式清单、benchmark 数字与评分方法、错误类型、OCR 分岔说明均来自 README 转述,非本文实测结论
· 本文未安装、未部署、未实测;转换保真度(表格 / 复杂排版)、benchmark 可复现性均未验证
END