ARTICLE · 1193114
一文搞懂 AMD 官方FPGA 开发AI 助手 ROSS
阅读本文收获
✅ 分清 ROSS 里技能和 MCP 是两件事
✅ 算清你那套环境能直接跑几个示例
✅ 看清哪些能力现在还没到能用的状态
✅ 算一遍交出去划不划得来
最近 AMD 推出了自家的 FPGA 开发 AI 助手,ROSS 「Agentic AI Assistant」,这名字一看像又一个 AI 聊天窗口。但不是。
准确的说法是,它是一层架在 AI 客户端和 AMD 工具链之间的桥。你在 Claude Code、VS Code、Cursor 里说话,它把这句话翻成 Tcl,丢给 Vivado 或 Vitis 执行,再把结果讲回给你听,还可以搜索文档。
官方给了 49 个技能、11 个示例素材,但它们分三条路径、有门槛、还分阶段发布。先摊开数一遍,你才知道该从哪条路开始。
一、Ross 是什么?
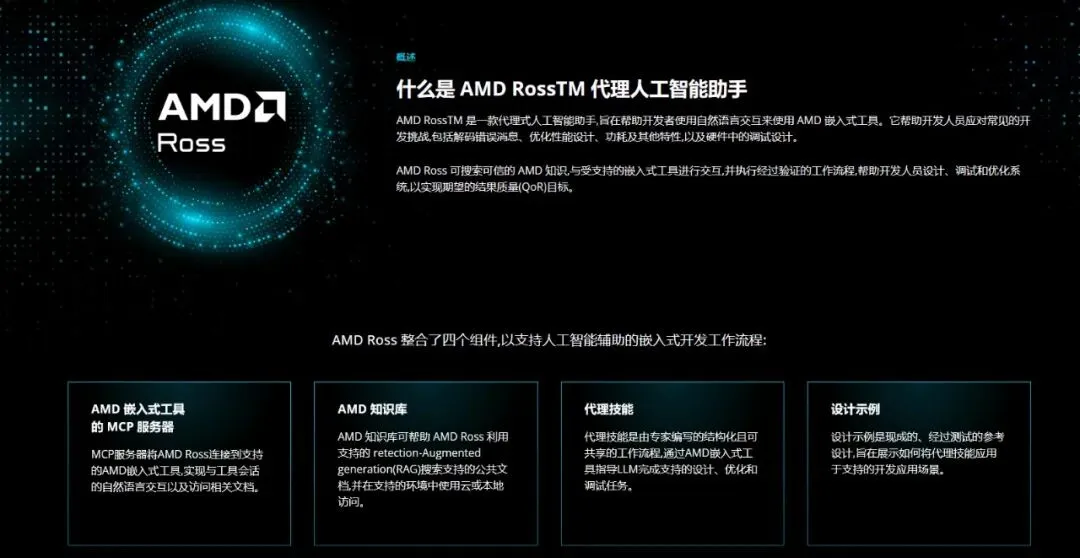
首先要明确的是:
桥不产生设计能力,上限取决于你接的模型;桥也不托管你的工程,设计文件不上传 AMD。
「不上传」得说细点。官方 FAQ 把系统拆成三层,客户端与模型、MCP server 与技能、文档检索。
它保证的是中间那一层,原话是设计文件、网表、约束、比特流和 vivado_execute 发出的 Tcl 文本都不上传给 AMD。这句只管 Vivado MCP 这一层,不等于代码不会被送到模型服务商那里。
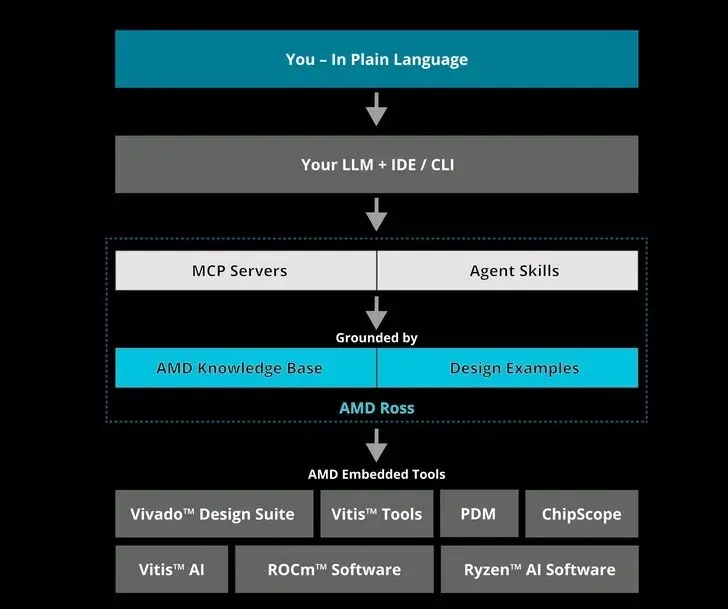
官方列了四个组件:
MCP Servers 是桥接层,把请求翻成 Vivado Tcl 命令再回传结果,只有 Vivado 路径需要它。
AMD Knowledge Base 用 RAG 检索公开文档,可选。
Agent Skills 是专家写好的结构化工作流,也就是一个个 SKILL.md 文件,这个是必需的。
Design Examples 是官方说的「开箱能跑、测过的参考设计」,全在仓库的 examples 目录里。
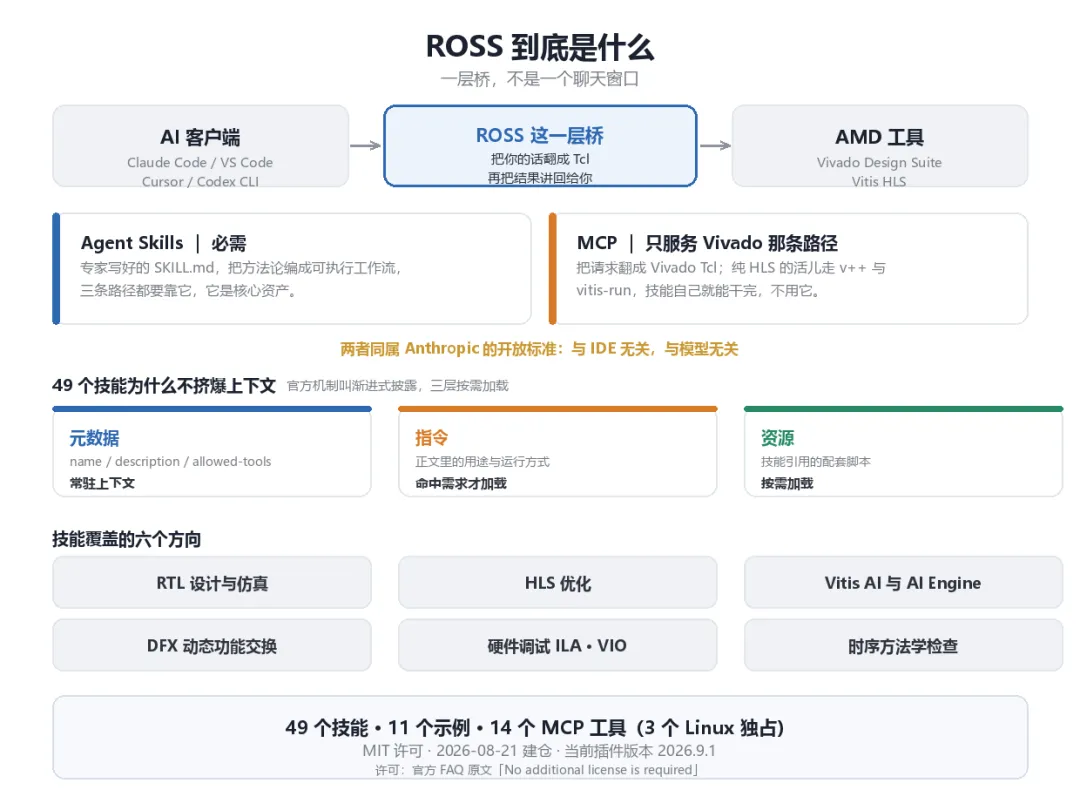
注意这里容易忽略的是,技能和 MCP 是两件独立的事。MCP 只服务 Vivado 路径,纯 HLS 的活儿技能自己就能干。
官方 FAQ 有组问答最直白,问的是 HLS 技能需不需要 MCP server,答的是不需要,它直接对源码和工程文件工作,走 v++ 和 vitis-run 这类命令行工具。
skill技能有哪些?
49 个技能挂上去,为什么不把上下文挤爆。官方给的答案叫渐进式披露,技能按三层加载,只有头部那几行元数据(name、description、allowed-tools)常驻,正文指令要命中需求才加载,引用的脚本按需加载。
这些技能覆盖 RTL 设计、HLS 优化、Vitis AI 与 AI Engine、DFX、硬件调试、时序方法学六个方向。
压成一排数字就是,49 个技能、11 个示例工程、14 个 MCP 工具(其中 3 个 Linux 独占)、MIT 许可、2026 年 8 月 21 日建仓、当前插件版本 2026.9.1。
许可方面可以放心,官方 FAQ 原文写的是不需要额外许可。模型方面门槛更硬,官方要求大上下文编码模型,排除了小模型和纯聊天模型。工具版本反倒含糊,官方文档里同时出现过 2020.2 以后、2025.1 以后、2025.2 以后、2026.1 以后四种说法,值得单独开一篇。
二、官方给了什么能跑的素材
官方示例一共 11 个,全部托管在 GitHub 上的 Xilinx/ross-ai-assistant 仓库里,MIT 许可,没有第二个下载源。
11 个都自包含,不用先备好一个自己的工程。
3个 HLS 示例(1 到 3 号)把源码摊在目录下,运行命令写在 README 里;
8个 Vivado 与 Vitis AI 示例(4 到 11 号)每个场景一个子目录,带 input 目录和一份 prompt.md。
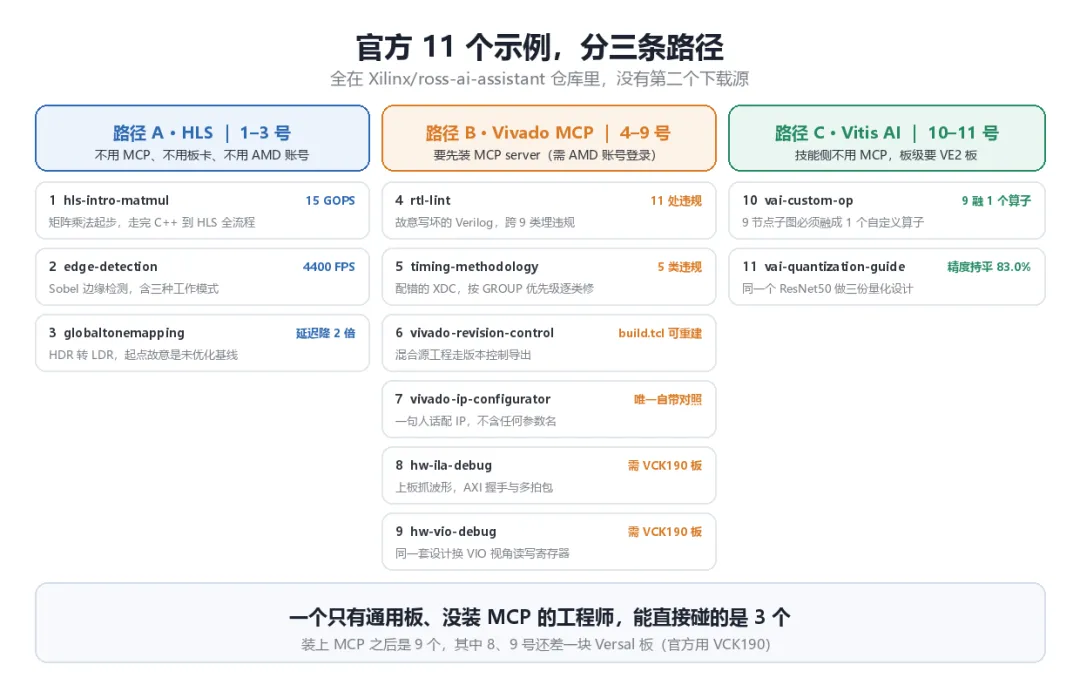
真正决定你能跑几个的是前置条件。维度就三个问题,要不要 MCP、要不要板卡、vivado 或vitis 版本要求。
路径 A 是 HLS,1、2、3 号。不需要 MCP server、板卡和 AMD 账号,装好技能就能跑,代价是要面对 Vitis HLS 的版本口径差。
三条分别是入门矩阵乘法(15 GOPS)、Sobel 边缘检测(4400 FPS)、全局色调映射(延迟降 2 倍、资源不超 1.5 倍),均为官方记录。
路径 B 是 Vivado MCP,4 到 9 号。要先装 MCP server 或 VSIX 扩展,这一步有账号门槛,官方产品页第一步原话是先用 AMD 账号登录,再下载 MCP server。
4、5、6 号分别对着 RTL lint、时序方法学检查、版本控制导出,都拿一份故意写错的输入让技能逐条修,官方记录是 11 处 lint 违规、5 类方法学违规、一份能重建工程的 build.tcl。
7 号是「一句话配 IP」,需求里不含参数名,agent 自己查出 IP、合法参数值和端口依赖再配好,这是官方唯一自带「有技能和没技能」对照的示例。
8、9 号要上板抓波形,除了 MCP 还要一块 Versal 板,官方用的是 VCK190。
路径 C 是 Vitis AI,10、11 号。
技能侧不需要 MCP,但板级步骤要 Vitis AI 容器和 VE2 板。
一个是给 9 节点子图生成 AIE kernel 和 tiling,难点是 9 个节点必须融成 1 个算子;另一个是量化对照实验,同一个 ResNet50 做三份设计,官方记录里 VINT8 加 BF16 和 BF16 精度持平在 83.0%。
顺手记一个真坑。示例 README 里链接的技能路径和仓库真实目录名对不上,README 写 skills/matlab-to-cpp,真实目录是 hls-matlab-to-cpp,照抄文档里的命令是打不出来的。
到这里可以下第一个关键结论了。官方 11 个示例,一个手上只有通用 UltraScale+ 板、没装 MCP 的工程师,能直接碰的是 3 个;装上 MCP 之后是 9 个,其中 8、9 号还差一块 VCK190。
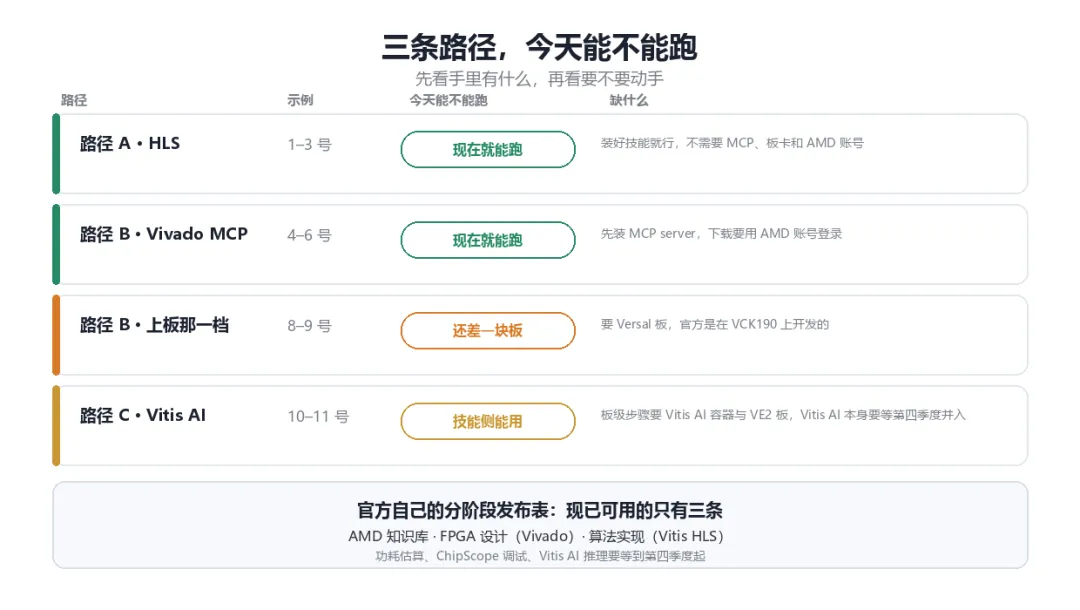
先别急着上头,还有一层。按官方给的分阶段发布表,眼下可用的只有三条,AMD 知识库、FPGA 设计 Vivado、算法实现 Vitis HLS;功耗估算、ChipScope 调试、Vitis AI 推理要等到第四季度起。你在别处看到的 PDM、ChipScope、Vitis AI 演示,眼下还不是装上就能用的状态。
三、官方记录的三个实例
示例告诉你「能跑什么」,没告诉你「跑起来能帮上什么忙」。
官方产品概览用三个实例回答了后半句,正好覆盖设计、实现、优化三个阶段。
口径先摆出来,这三个都是 AMD 的内部测试记录,官方在实例三下面附了脚注,写的是基于 AMD 截至 2026 年 9 月的内部测试与分析,结果可能因情况而异。实例一、二没有公开可复现的仓库,只能读,不能照做。官方把整条链条概括成表达意图、编排、工具执行、目标达成四步。
实例一用于设计。
输入一句「创建一个微控制器」,它解析成「为 Spartan UltraScale+ 评估套件创建一个 AMD MicroBlaze V 微控制器」,生成 11 步计划,遇到模块配置不匹配时自适应调整重试,产出一条可用的设计。
实例二用于实现。
输入「分析我的时序违例」,它调用时序技能,启动可重复的布线后流程,把失败路径按类别分组逐类修复验证。官方记录是失败路径从 735 条降到 0 条。
实例三用于算法优化。
输入是图像传感器去马赛克流水线,MATLAB 实现,性能目标 300 Mpixels 每秒,它用 Vitis HLS 工作流把手写实现重做一遍。
官方记录的对照是,吞吐量两边打平在 300 Mpixels 每秒;逻辑资源从 1,801 个 LUT 降到 1,177 个,少了 35%;开发耗时从约 2 天压到约 2 小时。官方还补了一句,这条从算法到 HLS 规范的 C 代码、再到 RTL 和 pragma 调优的传统路径,通常要 3 到 6 周。
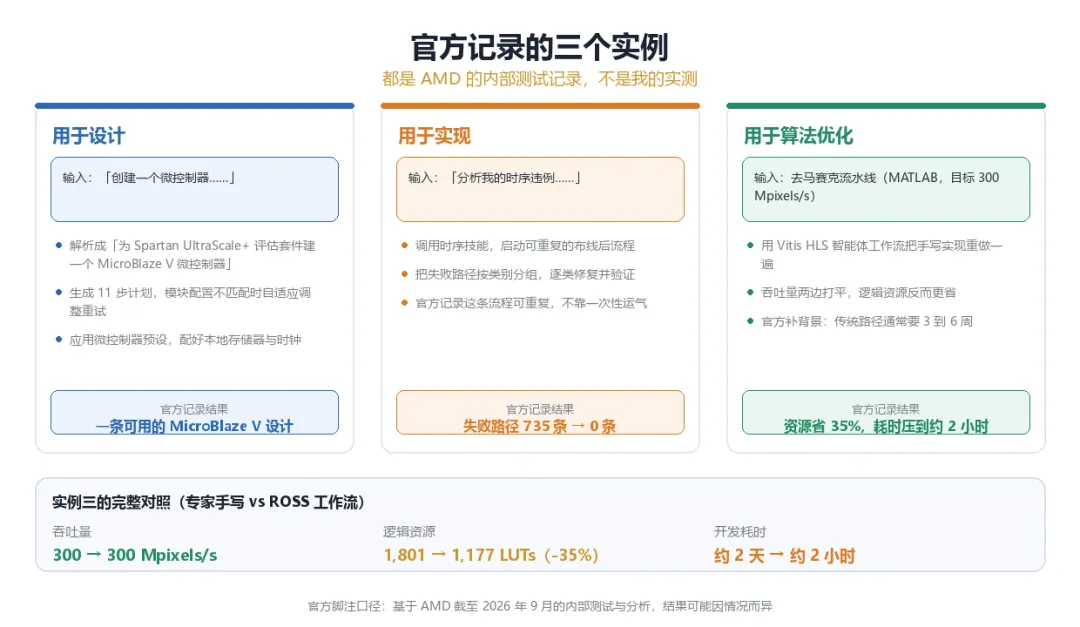
三个实例的共同点是,输入都是一句话,输出都是能进实现的具体产物,一条配好的设计、一份零违例的时序报告、一版达标的 HLS 实现。这就是「Agentic」和「聊天」的分界。
四、和手动做比,差在哪
先说边界。ROSS 没换工具链,底下还是 Vivado 和 Vitis,换的是交互方式。
手动是自己查器件、配 IP、连总线、敲约束,再一轮轮解报错;
ROSS 是说一句话,它翻成 Tcl 或走命令行,跑完把结果讲回来。
所以能省的那段时间,集中在「想清楚要做什么」之后、「结果出来」之前。
官方内部测试记录给过三组数字,口径都是 AMD 自己测的,不是第三方复现。
时序修复那条,失败路径从 735 条降到 0 条。手动做这件事,常规路数是跑完布线后报告,把失败路径按类分组,一类一类改约束、重跑、再看。
算法优化那条,逻辑资源从 1,801 个 LUT 降到 1,177 个,少了 35%,耗时约 2 小时;同一件事专家手写,官方记录约 2 天。官方另给了一个参照,同样这条从算法到 HLS 规范的老路,通常要 3 到 6 周。
设计生成那条一眼能看出差别。
给的还是那句「创建一个微控制器」,它自己把意向补全成 Spartan UltraScale+ 评估套件加 MicroBlaze V 软核,排出 11 步计划,中途遇到模块配置不匹配会自己调整重试,最后产出一条能用的设计。
数字之外,有两个性质上的差别更值得记住。
一是流程可复用。
技能就是一份写清楚的结构化流程,存在 SKILL.md 里,换台机器、换个人,跑的还是同一套步骤;手动做法把流程留在经验里,换人就要重新踩一遍。
二是它不替你判断。
技能按渐进式披露加载,命中需求才展开正文;跑的过程中它会在预设范围内自己选、自己重试,你看到的多是结果,不是每一步的取舍。
要求精确控制每一步的活儿,比如必须按既定顺序改动的工程,交出去之前得先想清楚。
所以划不划得来,得看你手头那件活儿。流程固定、官方有现成技能的,交出去省的是来回迭代的时间;本来两步就能干完的零碎操作,多一道「说话指令」反而绕。
五、小结
写 HDL 的代码能力还是取决于使用的大模型。
ROSS 是客户端与 AMD 工具链之间的一层桥,技能是核心资产,MCP 可控制 Vivado ,可查询官方文档手册。
ROSS 使用起来确实可以提效,但要注意匹配的vivado vitis等软件的版本,至于费不费token,有待实测。
后续会分享 ROSS 的安装和实测。