ARTICLE · 1217639
截图录音 PDF,Mac 上终于能按内容搜了
有没有一张图,你记得画面,却想不出它叫什么名字?录音也是,你记得里面聊了什么,却说不清它在哪个文件。多数人翻一半就放弃了。
Mac 的用户都熟知 Spotlight 工具了,Spotlight 认得文件名,认不得画面里有什么、录音里说了什么。DigUp 想做的事很直白:你把记得的那句话打进去,剩下的它来翻。
Spotlight 负责找文件的名字,DigUp 可以找文件的内容,区别就这一条。
两者不冲突,可以并排开着用。
图片按画面内容进去,不靠文件名;PDF 和文档按页、按段落进去;音频按一段段重叠的 30 秒窗口听进去;视频既抽帧,也听音轨。发票号、报错码这类死数字,这些内容会额外加权,因为光靠语义记不住一串字符。
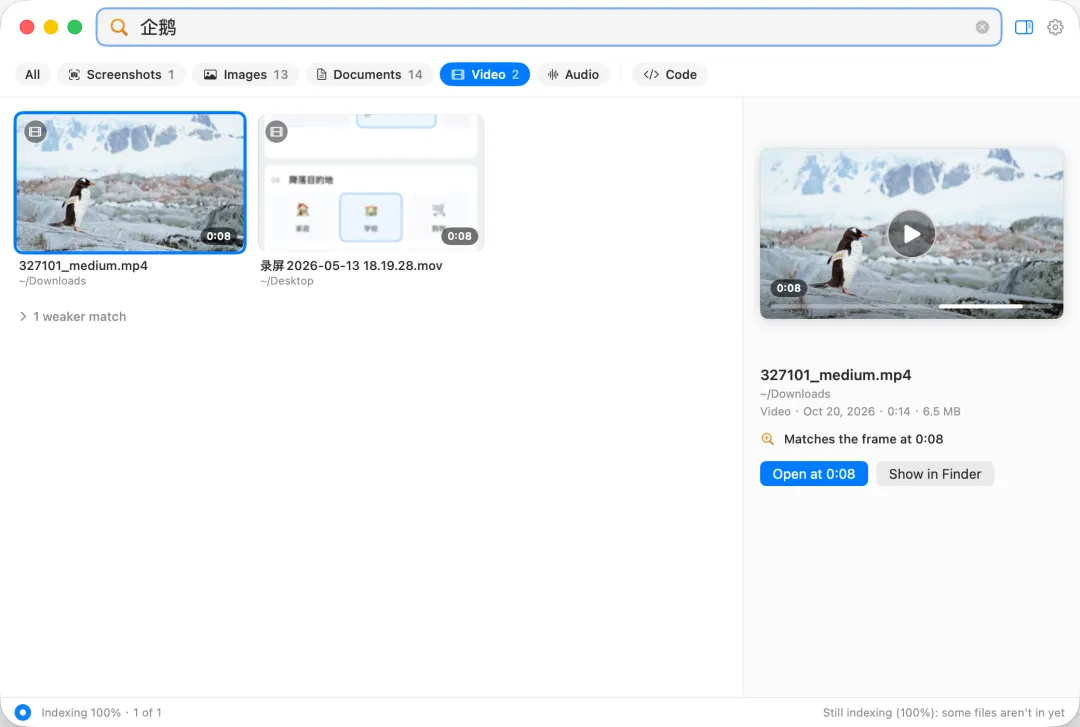
所以我这边的例子长这样:搜“企鹅”,去查包含企鹅的视频;搜“code: system.out”,找代码里包含 system.out 的文件。
命中之后,回车打开,空格看大图预览,⌘↩ 可以在访达里把它显示出来。开发者还能在设置里打开代码搜索,用 code: 加一句“这段代码在干什么”去找函数。
这是它最硬的一点:索引内容全部都在本地,整个索引就存在本机一个 SQLite 文件里。
需要联网的只有两次。第一次是下载模型,约 865 MB,其中文本部分 310 MB,图像和音频编码器 555 MB;日常搜索只加载文本那部分,约 250 MB。第二次是每天一次的更新检查,不发送任何文件信息,也可以关掉。没有账号,也不收集你搜过什么。
它只扫你勾选的目录,对文件只读,不动也不传。密钥、证书、密码文件、.ssh 这些默认不碰,看着像数据集的目录会跳过,只留在云端、本机没落地的文件也不会去拉下来。
模型用的是 Google DeepMind 2026 年 10 月发布的 EmbeddingGemma 2,7.4 亿参数。
Mac 装起来最顺:Apple Silicon 加 macOS 14 以上,从 GitHub 的 Releases 里取 DMG,或者 brew install --cask arahim3/tap/digup。装完用 ⇧⌘Space 呼出,勾上要索引的文件夹,它会按你这台机器估第一遍要多久,进度在菜单栏里看。官方说索引建完之后,新文件落盘一般几秒就能搜到。
Windows 和 Linux 目前还是 beta,功能没 Mac 全,想尝鲜可以自己试。
有个限制得讲清楚:中文、日文、泰文这种词与词之间没有空格的语言,不会被切成词。这是精确关键词匹配层面的限制,语义搜索不受影响。
也就是说,用大白话描述画面去翻照片,问题不大;但别指望它像搜英文专有名词那样靠切词精准命中,具体哪个中文词能直接搜到,得自己试过才知道。
另外,截图里的文字目前只在 Mac 上通过苹果的识别来读,支持约 25 种语言,Windows 和 Linux 还没做。
装完可以先拿三个任务试一轮:找一张只记得画面的照片,找 PDF 里的某一条款,找录音里的某一句话。跑得顺再决定要不要让它常驻。
仓库地址:github.com/ARahim3/DigUp
无法打开 GitHub,可以关注公众号发送:DigUp