ARTICLE · 1217649
AI 的记忆,能不能长在模型里?MemT 1.0 给出了一条新路
AI 的记忆,能不能长在模型里?MemT 1.0 给出了一条新路
把一个 AI 助手教会,往往需要反复交代背景、纠正细节、补充工作方法。可到了下一次任务,这些投入能留下多少?
如今常见的解决办法,是把经验整理成文档、用户画像、对话摘要或 Skill,等到需要时再交给模型阅读。这套办法已经很有用,也带来了一个值得继续追问的问题:模型能否拥有持续演化的内部记忆,让积累过的经验直接参与后续计算?
MemTensor 团队的 MemT 1.0 正在探索这件事。它在模型架构中加入原生记忆模块,将历史信息写入一块可以更新的内部状态。后续回答可以读取这块状态,不必把历史原文重新放进上下文。项目已公开技术报告、代码和模型权重。官方项目
这条路线的吸引力,在于让“经历过”逐渐转化为“以后用得上”。但它仍有记忆精度、容量和经验获取方面的限制。
先把“存入参数”说清楚
谈到模型内部的知识,人们容易想到训练:模型读过大量材料,再把其中的规律压进权重。沿着这个直觉理解 MemT,可能会以为它每聊完一轮,就重新训练一次大模型。
实际机制需要分开看。MemT 的主干负责通用能力,另有一套学习过的记忆读写机制,以及随交互变化的记忆状态。在线使用时,主干权重和记忆读写参数保持固定;持续更新的是各条交互轨迹自己的记忆状态。
可以把它理解为:模型已经学会一种记忆方法,之后用这套方法处理新经历。记忆能够延续,模型的通用权重也无需随着每轮对话重训。技术报告:模型架构
官方提供两个版本:Nano 基于 Qwen3.6-35B-A3B,Flash 基于经过进一步后训练的 DeepSeek-V4-Flash。两者动态记忆状态的规模分别约为 10M 和 336M 个元素。这些数字描述的是记忆状态规模,不能直接当作整个模型的参数量。官方模型配置
记忆真正困难的地方,是更新与取舍
保存历史记录并不难。难的是,新旧信息混在一起时,系统如何保留有效结论,以及后续任务如何用上这些结论。
假设用户先确定周六开会,随后正式改到周日,中间又讨论过一个最终没有采用的周一方案。几百轮之后,助手需要区分原计划、最终安排和未采纳的建议。仅仅找到包含日期的句子,还不足以完成这件事。
外部记忆系统通常通过摘要、检索和更新流程解决这类问题,效果取决于保存策略与取回的信息。需要反复送进上下文的材料越多,模型处理历史的负担也可能越重。更长的 Skill 同样需要筛选、组织和维护;篇幅增加本身并不保证模型执行得更好。
MemT 把一部分取舍交给学到的记忆机制。每轮交互完成后,系统处理该轮输入和输出,按 token 更新记忆,控制哪些旧信息被削弱、哪些新信息被写入。生成下一轮回答时,记忆分支与原有注意力分支并行工作,再把结果合并到后续计算中。官方架构说明
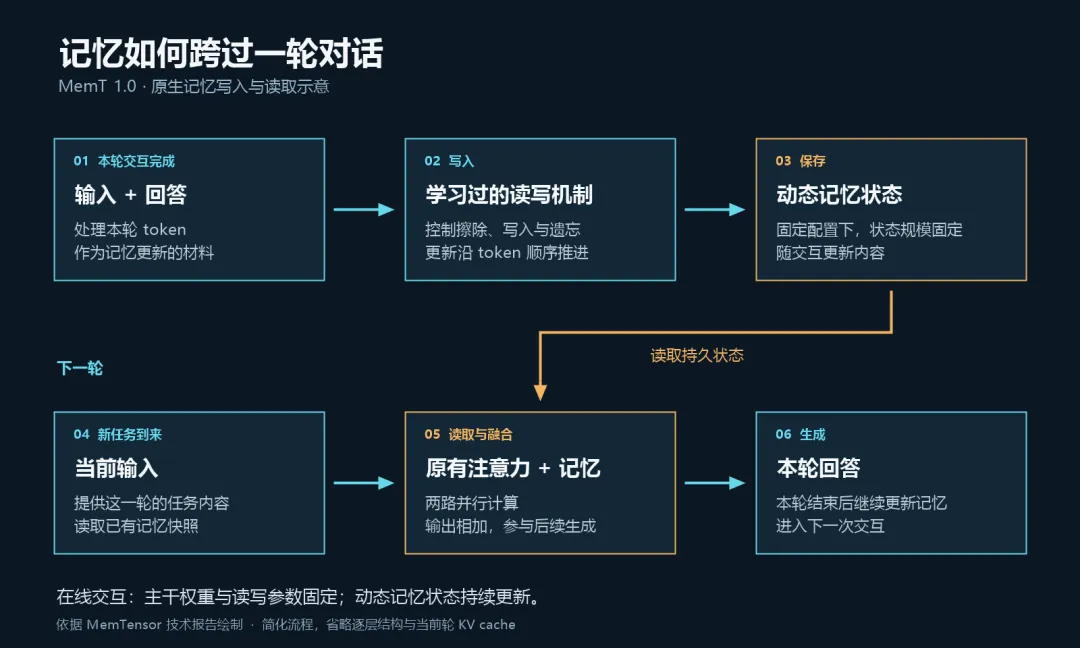
示意图为简化说明:记忆写入发生在一轮交互完成后;下一轮生成读取已有状态。在线交互期间,主干权重和读写参数保持固定。
这种安排改变了历史信息的存在形式。过去的内容不必始终作为可见文字留在窗口里,也能对后续回答产生影响。
让模型学会记忆,要看它以后能否用上
记忆训练的目标,不能停留在“把东西存进去”。更有价值的检验是:当历史原文不再可见,留下来的状态能否帮助模型完成之后的任务。
MemT 使用继续预训练和后训练来建立、调整这种能力。其中的蒸馏思路可以这样理解:让能够读取历史材料的教师提供学习信号,训练学生依靠记忆状态完成后续回答。模型由此学习哪些信息值得保留,以及如何从有限状态中提取有用内容。
不过,有限容量意味着取舍。即使更新机制足够稳定,也无法推导出“历史可以无限增长、所有细节永远无损保留”。记忆状态固定之后,新的内容仍要进入同一空间,旧细节和新信息之间就存在竞争。技术报告:训练与局限
固定记忆带来成本优势,也带来精度边界
这条路线最直观的价值,是历史越积越多时,持久记忆状态不必按原文长度持续扩张。
以 Nano 的标准配置为例,采用 FP32 保存时,每条轨迹的记忆矩阵约占 40 MiB。这个数字只计算持久记忆状态,不包含模型权重、当前一轮的 KV cache 和运行工作空间。Flash 对应的状态更大,也不能套用 40 MiB 的说法。技术报告:配置与存储口径
因此,更准确的判断是:固定配置有利于控制历史状态的存储与读取开销。它并不能保证整个系统的费用恒定,更不能保证任何任务都比全文上下文便宜。历史写入仍然要计算,当前任务仍然需要推理,多用户服务也需要保存多份状态。
精度方面,同样要区分比较对象。官方结果显示,MemT 在所评测的参数化记忆方法中取得领先的平均表现,但较强的文本记忆系统整体仍然领先,尤其是在长历史中需要找回精细证据的任务上。官方评测说明
这给出了一个清楚的边界:内部记忆适合探索紧凑、持续的经验积累;需要逐字核对、引用证据和追溯来源的场景,仍然有保留原文的价值。
更值得关注的实验:经验能指导下一次行动
原生记忆的用途还可以超出事实回忆。它能否承载“遇到这种情况,应该怎样做”的经验?
在编码实验中,团队从 41,057 条成功轨迹出发,整理出 1,040 条可复用经验,再将相关经验写入原生记忆,用来指导后续执行。经验文字无需直接出现在任务上下文中,也能影响代理的行动。技术报告:经验构建
原文提到的 54.0%→61.6%,对应 SWE-bench Verified 中的一项特定指标:每道题独立运行三次,三次全部成功的任务占比,即 pass³。它提高了 7.6 个百分点,不能当作单次平均成功率来理解。该实验使用的是 MemT-1.0-Nano;在执行前注入经验的设置下,原生记忆与显式文本经验的 pass³ 都为 61.6%。技术报告:表 5
这组结果支持一个具体判断:经过训练的内部状态,可以承载对行动有帮助的经验。它尚未证明系统能够独立完成经验发现、筛选和持续学习的全过程。当前框架仍依赖外部构建与检索经验,收益也受经验质量影响。
从记住信息,到积累能力
沿着这条路线继续发展,有三个问题值得期待。
首先是经验能否组合。多次经历进入同一记忆状态之后,模型是否更容易归纳出共同规律,并迁移到未见过的任务?这是一种有吸引力的可能性,现有结果还不足以把它写成已经实现的能力。
其次是记忆容量能否成为新的扩展维度。除了增加模型规模和训练数据,系统也可以研究扩大记忆容量、改进读写机制所带来的收益。MemT 对记忆扩展进行了初步实验,但是否存在稳定、普适的 Memory Scaling 规律,仍需要更多研究。
最后是它与持续自我改进的关系。一个长期工作的 Agent,需要把环境反馈变成经验,再让经验改善后续行动。原生记忆提供了其中一条连接路径。距离完整的自我改进闭环,还需要解决经验获取、质量判断和长期可靠性等问题。技术报告:应用讨论与局限
MemT 1.0 把一个原本主要由外部系统承担的问题,推进到了模型内部:过去发生过的事,如何成为下一次计算的条件。
这一步的意义已经足够具体。它让我们有机会检验,AI 能否在有限状态里积累有用经验,减少重复交代,并在新的任务中表现得更稳定。至于这样的记忆能走多远,接下来要看更长时间、更复杂环境下的实际结果。