ARTICLE · 1217735
产品 PDF 文档怎么做 SEO 吃 AI 搜索流量
PDF / 2026 产品 PDF 文档怎么做 SEO |
下面全部是动作,第一条五秒钟就能做完
先做一个五秒钟的测试
打开终端,装个 poppler,然后跑这一行。
pdftotext -layout 产品手册.pdf -
Mac 用 brew install poppler。Windows 用 scoop install poppler,或者去官网下预编译包。Linux 上一般自带。
不加 -layout 是按文件内部的绘制顺序抽,加了 -layout 是尽量按版面的位置还原。两版都跑一遍对照着看,第一次跑就能看出问题在哪。
要看的只有三件事。
字是不是乱序了。两栏排版抽出来会左右交错,一句话被另一栏插断。
表格是不是散架了。单元格变成一串数字,行和行对不上。
每页开头是不是都重复着同一行。页眉页脚会被当成正文。
不想装东西也行。用 Chrome 打开那个 PDF,全选,复制,粘到记事本里。你看到的基本就是解析器看到的东西。
为什么这一步最关键。2026 年 10 月,Google 在自家播客里把这条管道讲清楚了:PDF 进来先被转成 HTML,后面所有的环节只认 HTML。
你在 PDF 里做的所有排版功夫,都得先过这道转换器。转换器读不出来的,等于不存在。
别用任何 SEO 工具查这一项。工具会告诉你「可索引」,转换器不会。
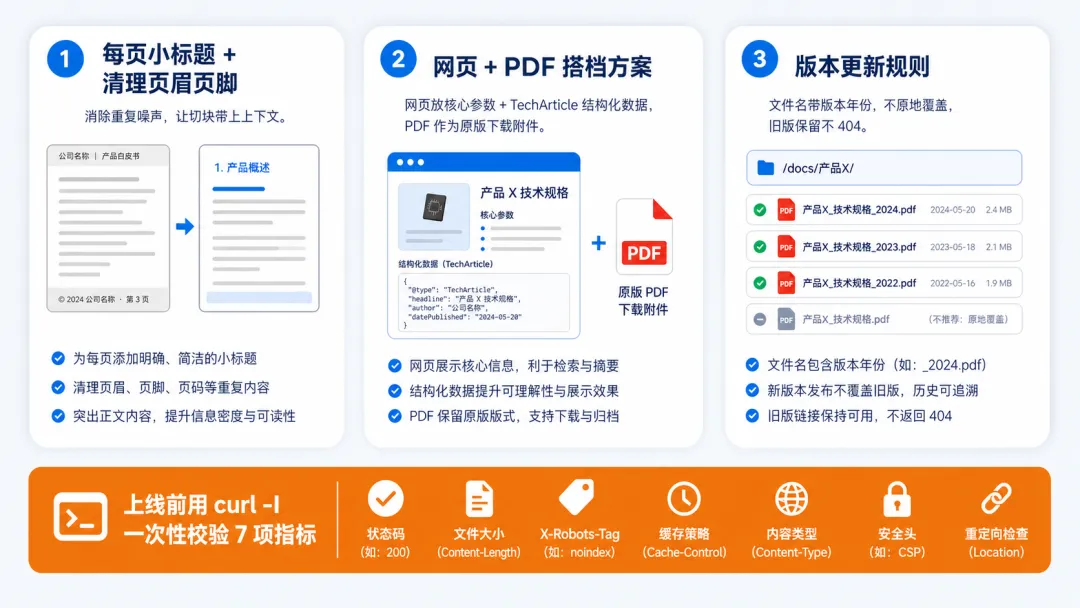
把每页重复的那行字清掉
页眉页脚对人来说是装饰,对解析来说是毒。
一份三十页的手册,每页顶上印着「某某公司 · 2026 产品手册 · 第 N 页」。这句话会被切进每一个文本块。
分块的常规大小是五百个词上下,Google 自家文档里给解析器的默认值就是五百。二十个字的页眉塞进去,听着不多,但有两个副作用。
每个块的开头都是同一句废话。模型判断这块讲什么的时候,先读到的是它。
页码是数字,会被当成内容。三十页就是三十个孤零零的数字,散在各个块里。
做法很简单。导出之前,在源文件里把页眉页脚删掉。页码让阅读器自己显示,不要印在页面上。品牌名只在封面和封底出现。
源文件丢了也有救。Acrobat 的「编辑 PDF」能直接删掉那行字。删完重新跑一次第一节的测试,确认没删坏。
如果手册是用 Word 或者 InDesign 排的,去改母版页,那里改一次全本都生效。别一页一页手动删,三十页删下来一定会漏。
顺带把文档属性里的标题也改一下。默认值经常是「Microsoft Word - 未命名2.docx」这种东西,它会跟着文件一路走。
每页给一个自己的小标题
这条最反直觉,也最容易被跳过。
分块器不是按固定字数硬切的。2026 年 Google 公开的文档处理说明里,主流做法是按版面元素切:标题,列表,表格各自成块,并且会把「祖先标题」一起带进块里,免得切出来的块失去上下文。
问题是,产品手册里一个章节往往横跨五六页,章节标题只印在第一页。
后面那几页被单独切走的时候,祖先标题就没了。它们变成几段没有出处的文字。
所以每一页顶上,给一个属于这一页的小标题。不用长,一句话交代这页在讲什么就行。
「M12 接口定义」「防护等级与工作温度」「配套线缆选型」。
这三行标题的价值,比在正文里多塞十句关键词高得多。它们决定了切块时,这一块有没有名字。
顺带一个好处,对人也有用。翻手册找参数的人,速度能快一倍。
三种排版,抽出来必死
表格。用画出来的线拼表格,解析出来是一堆散落的数字。要用真正的表格插入,导出时保留结构。判断方法还是抽一遍:抽出来还是「型号 电压 电流」一行一行对得上,那就是真的。
两栏。产品手册爱用双栏省纸。双栏在抽取时几乎必然交错。要么改成单栏,要么保证每一栏都是完整独立的段落,不跨栏续写。
扫描件。最常见,也最致命。判断方法很简单,用鼠标能不能选中文字。选不中就是图,对引擎来说这一页是白纸。要么重新从源文件导出,要么做 OCR,但 OCR 出来的字必须人工过一遍,型号里的 O 和 0,l 和 1 会被认错。
还有第四种,这几年最多见:参数表做成图片发出去。图能被人看到,字不能被机器读到。
这四种里,前两种能修,后两种只能重做。所以如果手册还要用三年,现在就重做一遍,比每年补一次便宜。
配一个网页,别让 PDF 单打独斗
PDF 有个先天缺陷:它装不了结构化数据。
schema 是网页的东西,PDF 里没有这个位置放。
所以标准做法是两份,一份网页一份 PDF,配对使用。
网页上放这几样。
一句话说清楚这是什么文档,哪一年的,适用于哪个型号。
关键参数用真正的表格再写一遍,不要只给一个下载按钮。
下载按钮指向 PDF,旁边标清楚文件大小和页数,人下载前想知道这两样。
结构化数据标成 TechArticle 或者 DigitalDocument,不要标成 Product。产品页标 Product,文档页标文档,标错了等于没标。
版本号和发布日期写在页面上。这两样 PDF 里其实也有,但写在网页上更显眼。
分工就定了:网页负责被人找到和被引用,PDF 负责在被引用的那一刻,是那份原件。
有一个动作千万别做,给 PDF 加表单门禁。用邮箱换下载,人拿得到,爬虫拿不到。真要用表单,让网页先把核心参数写全,PDF 只当完整版。
改了参数就发新文件
这条跟大部分人的习惯相反。
Google 在那期播客里说得很直白:PDF 的重新抓取频率比网页低。你原地覆盖一个 catalog.pdf,搜索引擎可能几个月都不知道你换过。
而且 PDF 是二进制文件,重复内容的归并本来就难做。
所以参数一改,做法是这样。
新文件名带上年份或者版本号,catalog-2026-v3.pdf。
旧文件留着,不要让它 404。
网页上的下载链接换成新的。
旧文件首页写一行「本版已由 v3 取代」,或者让旧文件的响应头指向新文件。
代价是文件会越攒越多。所以要一开始就做对,别用 catalog.pdf 这种名字,用带年份的。每更新一次,天然就是一个新地址,旧的自然退役。
上传前过一遍这七条
curl -I 一条命令全看完。
curl -I https://你的域名/files/catalog-2026-v3.pdf
六十四兆是 Google 文档里写明的 PDF 抓取上限。带高清图的产品手册很容易踩线,压图或者拆成两册,都比被丢下强。
还有一件别做的事。
别把 llms.txt 做成 PDF。Google 明确说过处理不了这个格式。2026 年 7 月的一份统计里,百分之九十七的 llms.txt 请求量是零。这个东西现在不值得占用你半个小时。
收个尾
七节走完,回头看一眼。
第一节不做,你不知道转换器看到了什么,后面六节都是猜。
第五节不做,PDF 就只剩被下载这一条路。
第六节不做,你改的参数三个月后搜索引擎还不知道。
第七节最省事,一分钟,能挡掉一半的低级错误。