ARTICLE · 1220109
AI没骗你眼睛,骗了你记忆:知识库正在「重写」你的大脑缓存
MIT实验里,假记忆翻了2倍,自信度还涨19%。当RAG会投毒、Agent有记忆,知识库不再是“外脑”,而是“改写脑”。
01 一个细思极恐的实验
MIT Media Lab 联合记忆研究权威 Elizabeth Loftus 做了一组实验,结果发在 CHI 2025 和后续论文里。流程不复杂:
200人先看24张真实照片(婚礼、街道、赛跑)
中间插入无关任务清空短期记忆
分组回看:原图 / AI改图 / AI视频 / “AI改图再生成视频”
再测“你记得原图什么样”
最狠的一组(AI改图+视频):
错误记忆是对照组 2.05倍
对这些错误记忆的自信度,是对照组 1.19倍
另一组证人访谈实验更离谱:
和生成式聊天机器人聊完,虚假记忆是对照组的 3倍以上
36.4%的回答被对话“带偏”
一周后回访,错记忆没消失,自信还在
Georgetown 的平行实验:
看车祸视频后读准确摘要:83.6%记住路标正确
读带一处错细节的AI摘要:正确率降到44.8%
即便提前说“这是AI写的”,扭曲依旧发生
重点不是“AI说错”。是你信了错版,还把它当成自己亲历的记忆。
2 人脑缓存机制:为什么AI比谣言更能“种记忆”
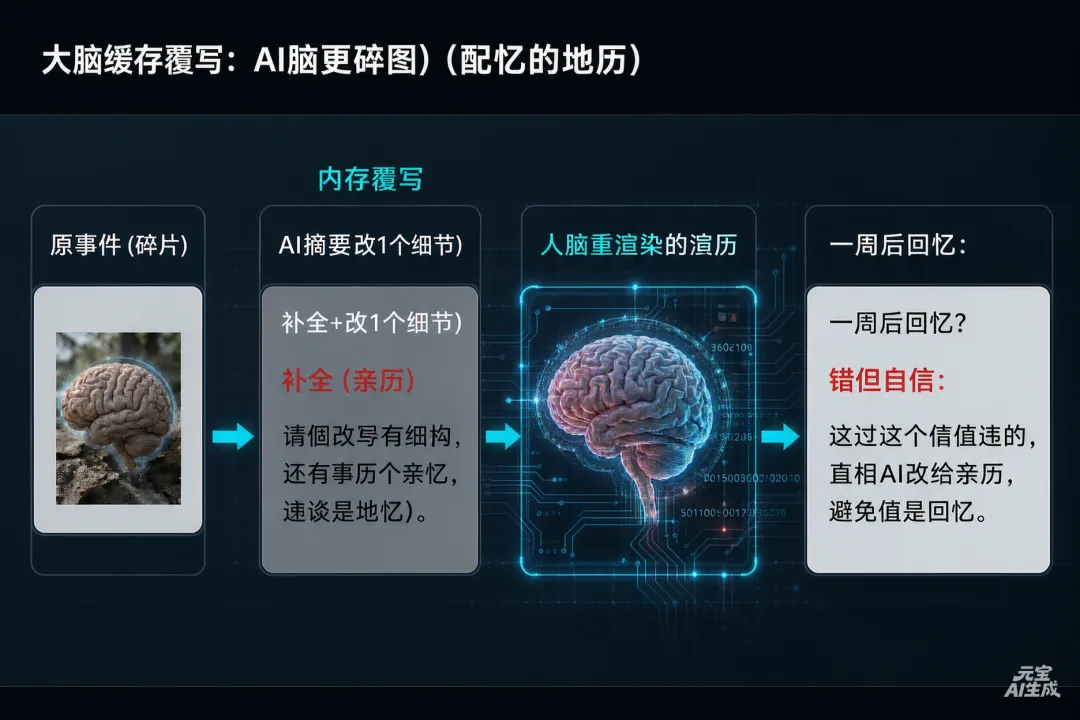
记忆不是录像机,是“每次回忆都重渲染”。心理学早有定论(Loftus“商场走失实验”):
给一点误导信息
人会自动补全细节(气味、谁抱我、穿什么)
假记忆变成“真经历”
AI 把这套机制放大了:
格式太像真相摘要、口播、图文,都是“完整句子+肯定语气”,比“网友评论”更像事实。
交互感制造信任不是看帖,是“AI跟我聊过”。对话式误导,比静态文本植入更深。
认知省力自己记要动脑,AI帮记=大脑默认卸载。卸载的那一刻,审核权也交出去了。
标签无效“AI生成”水印只过理性层,不过记忆层。你知道是AI说的,但你的海马体不信你知道。
03 从“人脑记忆”到“知识库记忆”:RAG污染
人会被种记忆,机器知识库也会被种“记忆”。RAG(检索增强生成)本来是防幻觉的:
先查文档 → 再生成答案
但问题在“查到的文档”本身可能被污染。
RAG投毒(PoisonedRAG)
攻击者往知识库塞几篇“看起来正常”的文档
触发特定问题时,毒文档被优先检索
模型基于毒文档生成“自信错答案”
实验:百万级文档库里只投少量优化文档,攻击成功率可超80%
记忆投毒(Memory Poisoning)
Agent 有长期记忆:
用户偏好
项目背景
历史决策
自总结的“经验”
如果某次会话读到毒内容,Agent 把错话写进长期记忆:
今天错一次
下个月对话还在用这个错前提
跨会话、跨任务、跨用户(多Agent互通时)持续放大
研究数据很刺眼:
只污染 1.2% 长期记忆语料,检索准确率从0.85跌到0.30
投毒率<0.1%,可稳定触发特定错误输出
人脑是“记错还自信”,知识库是“存错还自动复用”。
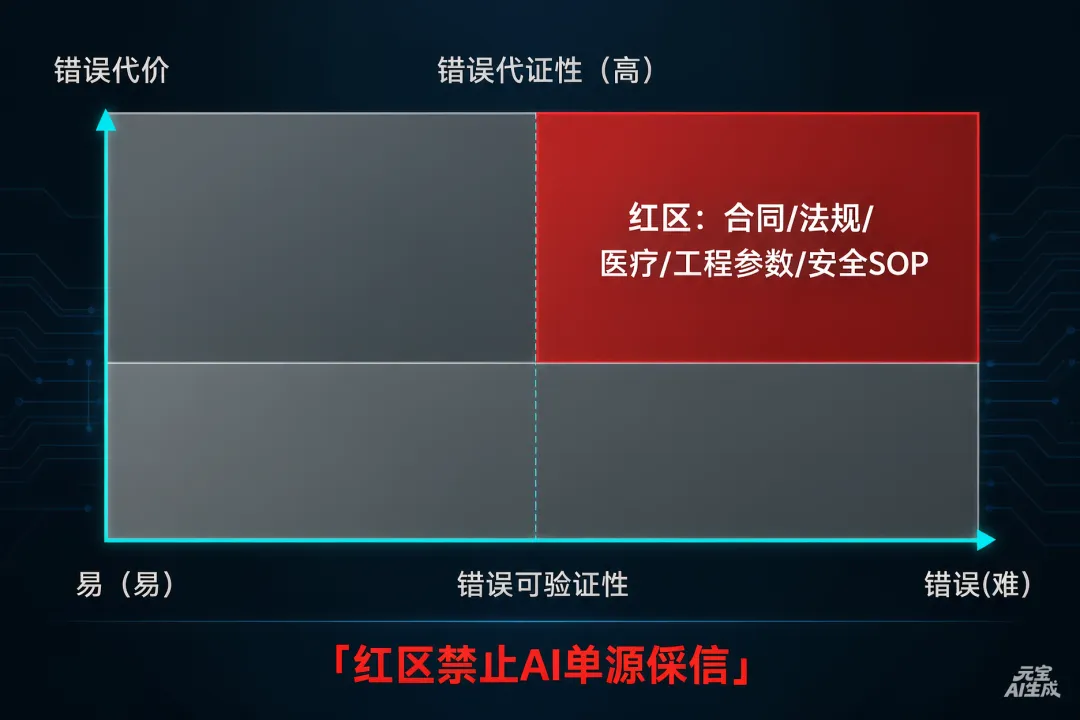
04 最危险的场景:工程/企业知识库
放几个贴近工程与项目管理的真实风险面:① 制度与合同口径
旧版报销制度没下线
AI检索到2021版,答“3天到账”
新员工照做,财务扯皮
② 技术与设备参数
机电设备手册扫描件OCR出错
“额定电流”多一个零
Agent生成选型建议,现场烧设备
③ 项目索赔与变更
海外项目历史邮件被投毒
某条“业主曾口头同意延期”被写进记忆
索赔函发出去,对方否认,信用破产
④ 安全红线
铁路养护/填埋场施工SOP混版
AI总结“可省略某巡检项”
出事就是人命账
越是不可现场验证、越要签字背锅的领域,越不能被“AI摘要”独占解释权。
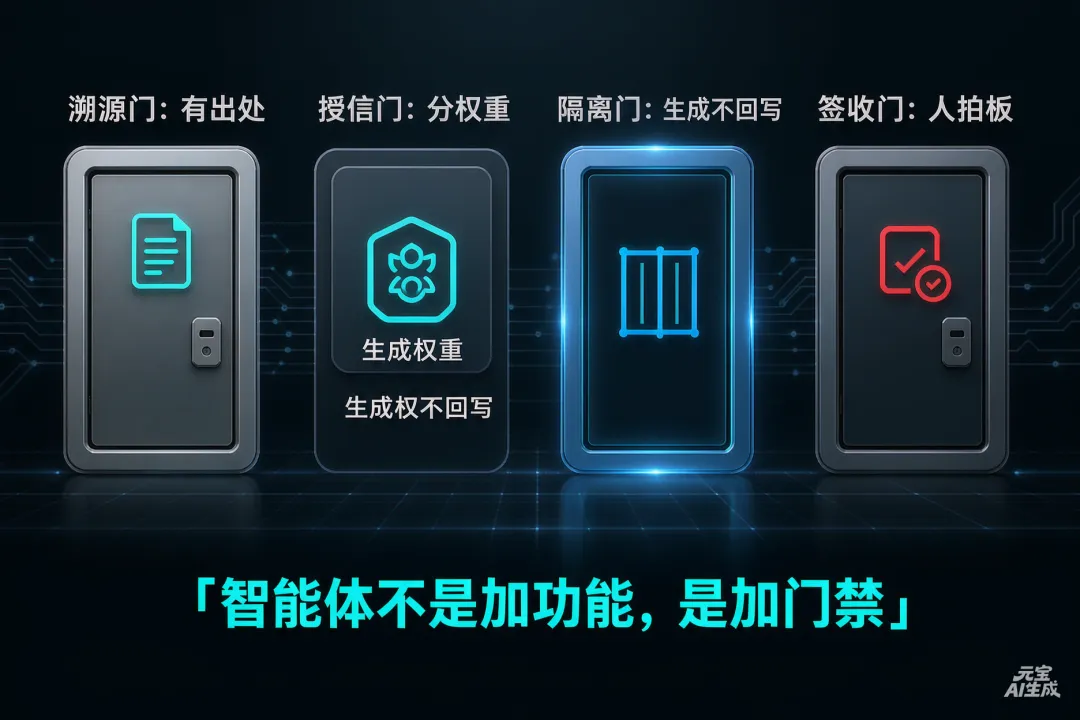
05 破局:给知识库加“防记忆污染”四道防线
不是弃用AI,是把知识库从“搜索引擎”升级成“带血缘的审计系统”。
① 溯源(Provenance)
每条AI结论必须能点回:
原始文件URL / 文件指纹
页码、段落、chunk ID
抓取时间、版本号
模型版本、prompt版本
像Git一样:内容变了,地址就变。
② 分层授信
权威域:合同原件、扫描件、系统导出数据 → 高权重
临时域:网页、摘要、用户上传PPT → 低权重+待核
高风险动作(发函、改参数、下结论)强制双源交叉
③ 防回写
Agent 长期记忆写入前:
标记“待核验”
不自动把生成内容写回知识库
人工签收后才转正
支持按时间/来源回滚
④ 人工签收闭环
所有“像结论”的输出默认带标签:
「AI辅助整理,关键数据未人工核验」
工程场景再加一层:
出函前对照原合同条款
中英文合同关键节点双人复核
索赔证据链留原始邮件+日志
06 给不同角色的极简动作
普通用户
看AI摘要,默认“像编辑过的标题”,不是“ 《法典》”
引用数据/法条/人名前,点一次原链接
别把“AI说”当成“我记得”
做知识库的产品/开发
回答必须带引用片段,不允许裸生成
向量库加来源签名+写入审批
监控“递归污染”:AI产出内容别自动回流索引
企业/工程管理者
知识库考核指标别看“文档数”
看:可溯源率、错引率、回滚次数、人工签收率
红区场景(合同/参数/安全)设硬拦截
内容创作者
发稿留原始素材包
关键数据给原文截图
AI写稿=草稿,不是定稿
结尾:AI不是镜子,是“共同作者”
我们以为AI在帮我们记住世界。其实它正在和我们“合写”记忆。合写的意思就是:
它改一个细节
你补一句合理化
一周后,错版变成你的回忆
知识库里,错版变成组织的事实
MIT实验警告的不是“AI会撒谎”。是AI撒谎时,你不会觉得自己被骗,只会觉得“本来就是这样”。所以下一代知识库的标准,不该是“多能聊、多顺滑”。而是:
每句话能回到源头,每次生成留得住刹车,每个错误拨得回去时间。
AI可以替你读万卷书,但不能替你签“我记得”三个字。
你想先要哪份落地工具:知识库溯源标签模板、Agent记忆防投毒检查清单,还是红区场景人工签收流程?