ARTICLE · 1224373
这个PDF解析智能体,几十页文档不用逐字读
周一早上九点,领导甩来一份 60 页的行业报告:"下午三点开会,你过一遍,挑重点讲讲。"
你打开文档,硬着头皮看了两页,又看了眼时间——这要一页一页读,下午就别干别的了。
别急着硬啃。我最近实测了一类专门"吃"PDF 的工具——PDF 解析智能体:把几十页的文档丢进去,然后直接用大白话问它要答案。
它真正改变的不是"读得快",而是文档第一次变得可以被提问。
一、为什么几十页的PDF这么难读
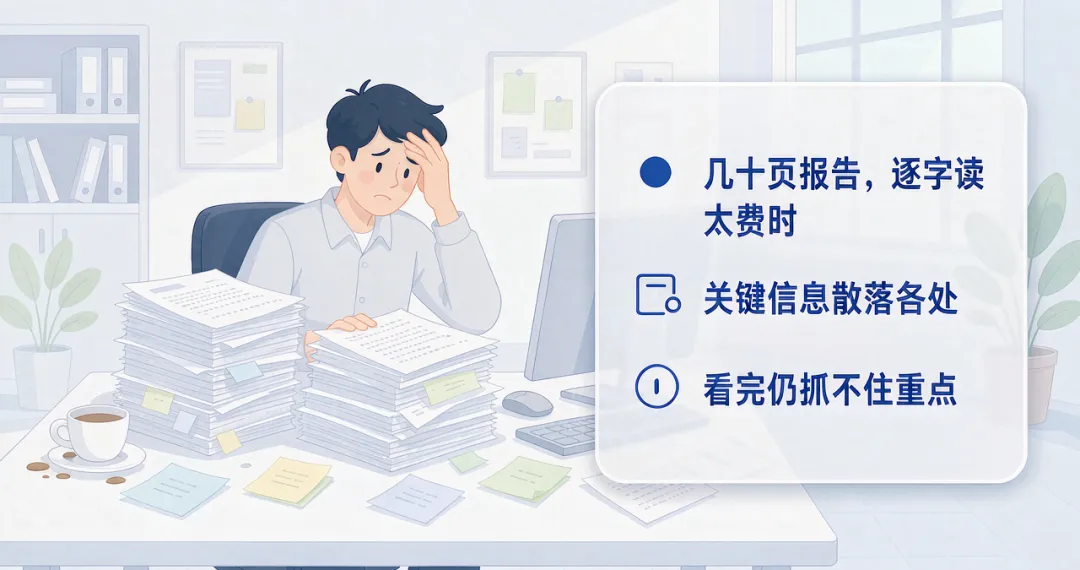
先说个反常识的事:PDF 难读,不完全是因为"字多"。
PDF 本质上是一种"印刷格式"——它记录的是每一页长什么样,而不是内容的逻辑结构。所以你从里面复制一段话,经常出现乱码、断行;想搜"第三章的结论",也搜不到,因为它根本不知道哪里是第三章。
过去用 AI 帮忙读文档,大多数人的做法是把全文复制进对话框。文档短还好,几十页的文字一次塞进去,AI 的注意力就被摊薄了,回答容易漏、容易混。
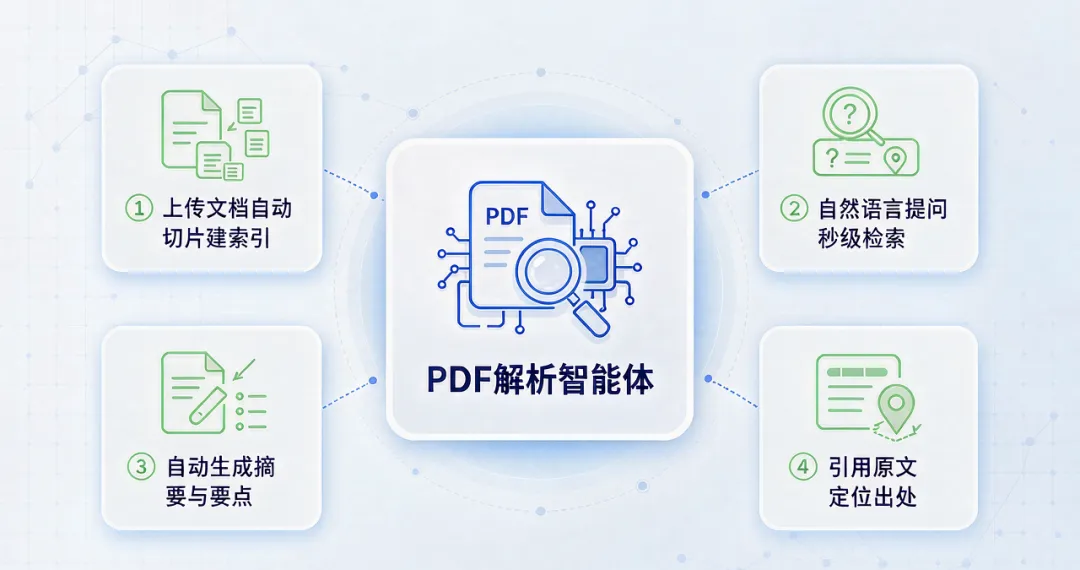
PDF 解析智能体走的是另一条路:它先把文档切成小段、建好索引,你提问时,它只去调取最相关的几段来回答。
打个比方:前者是把整本书塞给一个人硬背,后者是给他配了个图书管理员,随问随查。
二、三类人,最先把时间省下来
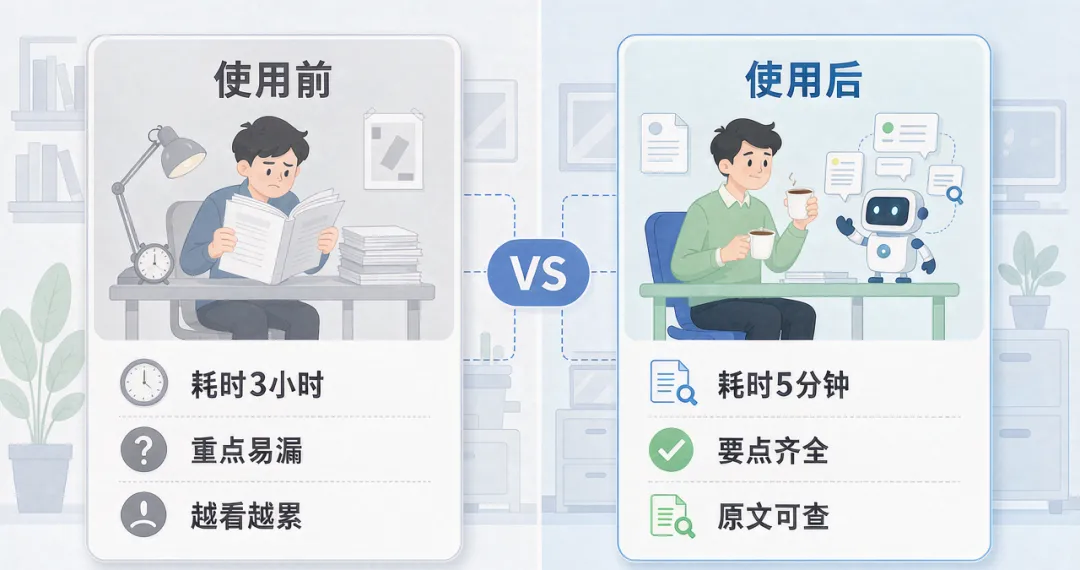
在校学生,是最直接的受益者。几十页的文献、课件,以前要通宵啃,现在先把问题列出来——"这篇论文的实验方法是什么""结论有哪三条"——让智能体先答一轮,再带着答案回原文细读。从"逐字读"变成"按需查"。
普通职场人,省的是核对的时间。报告、合同、标书,几十页里真正要紧的往往就几个数字、几条条款。与其从头翻,不如直接问"违约责任在第几部分、原文怎么写的",让它把出处指给你。
生活里的普通人,用得上的地方比想象中多。保险条款、体检报告、购房合同,这些"又长又不敢跳读"的文档,最怕漏看关键项。问一句"这份条款里,哪些情况是不赔的",比自己逐条找踏实得多。
一句话:文档越长、越不敢漏的人,省下来的时间越多。
三、想用好它,记住四个动作
动作一:先要摘要,再问细节。打开文档先别急着问具体问题,让它先出一份"一页纸摘要",确认它理解的方向没错,再往下问。方向错了,问得越细,偏得越远。
动作二:提问要具体,带上位置和数字。别问"这篇讲了什么",要问"第三章的结论是什么、依据是哪些数据"。问题越具体,答案越准。
动作三:重要信息,回原文核对。智能体会给出来源和出处,但它是"检索",不是"保证"。越关键的数字,越要回到原文亲自核对一遍。这是底线,不是建议。
动作四:一次只喂一个主题。把行业报告和个人简历混在同一个库里,答案就容易串台。一个智能体管一类文档,干净。
四、上手实测:拿"扣子"的RAG文档助手举例
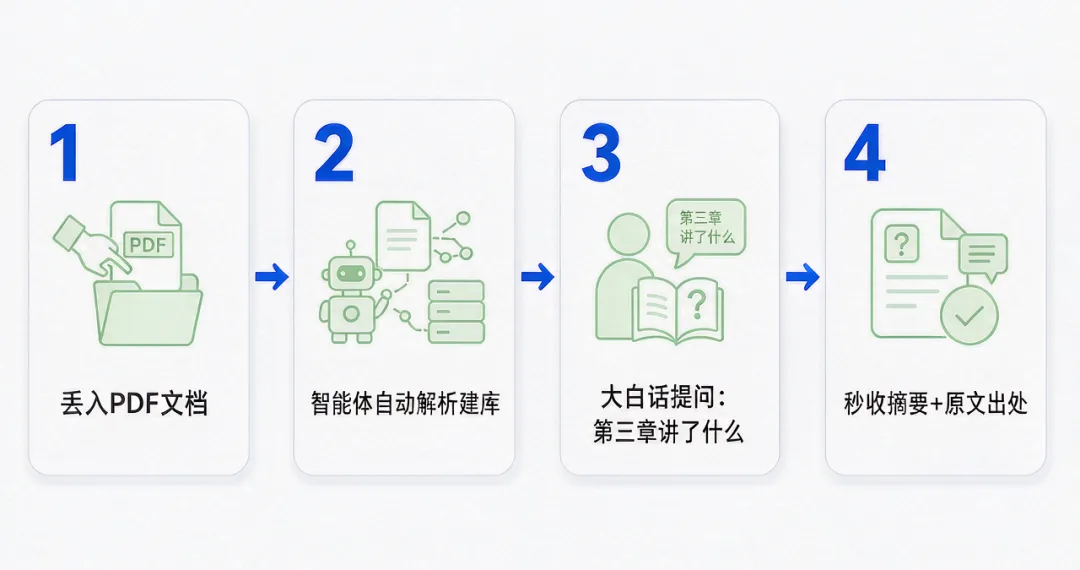
光讲道理不上手没意思。我拿扣子(Coze)的"RAG 文档助手"模板跑了一遍,全程没写一行代码:
第一步,新建智能体,把 PDF 拖进去,它会自动切片、建索引,几十页的文档大概一两分钟就绪;第二步,直接打字提问,比如"整份报告的核心结论有哪些",几秒出答案;第三步,也是我最看重的一步——让它"给出处",答案后面会附上引用的原文位置,点过去就能对到原文。
当然,也有要注意的:涉密文件、公司未公开的数据,别往这类在线工具里传;免费额度够个人日常用,量大的话先看清楚它的收费说明。
五、最后想说
工具解决的是"找得快",解决不了"信不信"。
AI 不能替你读文档,但它能把"读"这件事,变成"问"。
下次再收到几十页的PDF,先别叹气。把它丢给智能体,问出你最关心的那个问题,再带着答案回原文核一遍——三分钟的准备,换下午会上的从容。
你手边现在压着哪份没读完的PDF?评论区聊聊,我看看哪类文档最让人头疼。
AI 不能替你读文档,但它能把"读"变成"问"。
关注「人间无事人」,每天一篇,把 AI 用明白。
—— 人间无事人 ——